دیپسیک با آپدیت جدید V4.1 Flash و فریمورک DeepInfer هزینه اجرای هوش مصنوعی را کاهش میدهد
شرکت دیپسیک با معرفی بهروزرسانی جدید مدل V4.1 Flash و انتشار فریمورک متنباز DeepInfer، گام بلندی برای کاهش هزینههای اجرای هوش مصنوعی برداشته است. این راهکارها با کوتاهتر کردن پاسخها و بهینهسازی پردازش، اجرای مدلهای زبانی را برای توسعهدهندگان بهصرفهتر و سریعتر میکنند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- بهروزرسانی جدید V4.1 Flash عملکرد مدل را در کدنویسی و تسکهای ایجنتی ارتقا داده و با تولید خروجیهای کوتاهتر، هزینه مصرف توکن را کاهش میدهد.
- فریمورک متنباز DeepInfer بخشی از زیرساخت اختصاصی دیپسیک برای تسریع پردازش استنتاج در سرورها را در اختیار عموم برنامهنویسان میگذارد.
- دیپسیک با تخفیف در ساعات خلوت مصرف و ارائه APIهای ارزانقیمت وبگردی، اکوسیستم ابزارهای هوش مصنوعی خود را گسترش داده است.
ساخت یک مدل هوش مصنوعی قدرتمندتر فقط نیمی از مسیر است؛ نیمه دیگر این نبرد، کاهش هزینههای اجرا در مقیاس انبوه است. شرکت دیپسیک بهتازگی نسخه بهروزرسانیشده V4.1 Flash را با هدف تکمیل سریعتر تسکها و تولید خروجیهای کوتاهتر معرفی کرده و همزمان یک فریمورک متنباز را برای استنتاج کارآمدتر در دسترس قرار داده است.
بهروزرسانی امیدوارکننده مدل V4.1 Flash
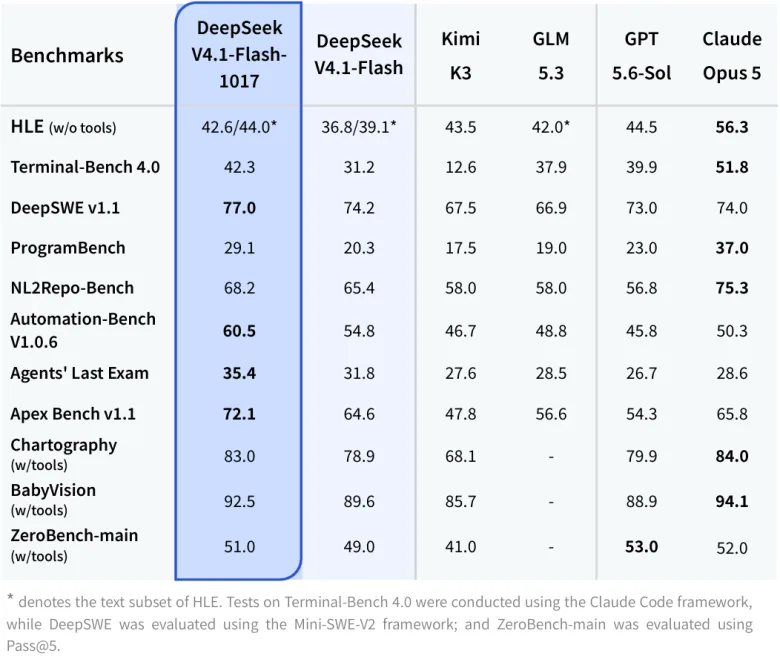
دیپسیک در تاریخ ۱۷ اکتبر (۲۶ مهر) نسخه بهروزرسانیشده V4.1-Flash-1017 را منتشر کرد. نتایج بنچمارکهای رسمی این شرکت نشاندهنده ارتقای عملکرد مدل در چند بخش کلیدی، از جمله برنامهنویسی و تسکهای مبتنیبر ایجنت است. بهعنوان مثال، امتیاز این مدل در بنچمارک Terminal-Bench 4.0 از ۳۱٫۲ به ۴۲٫۳ ارتقا یافته و در DeepSWE v1.1 نیز از ۷۴٫۲ به ۷۷٫۰ رسیده است.
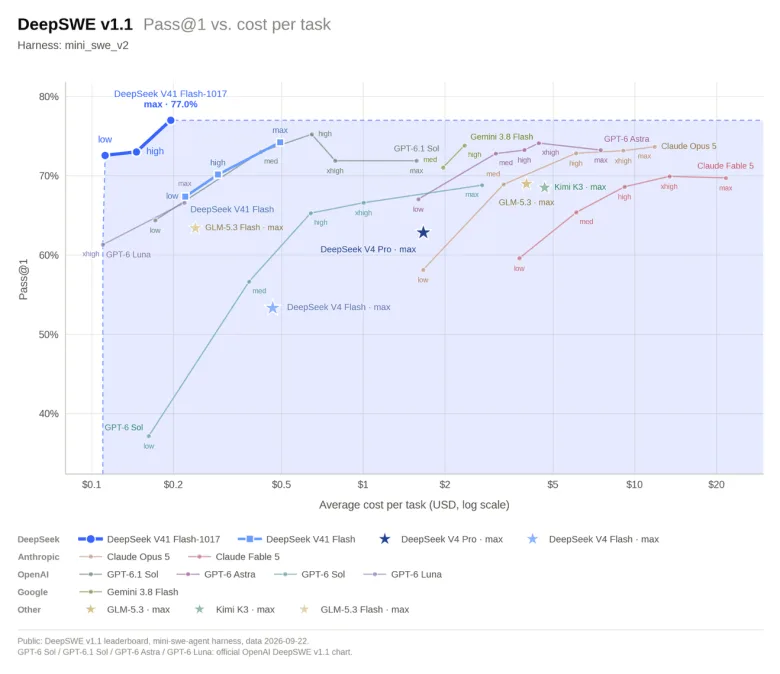
نمودار نسبت کارایی به هزینه در بنچمارک کدنویسی DeepSWE v1.1 نشان میدهد که مدل V4.1 Flash-1017 با ثبت امتیاز ۷۷ درصدی در معیار Pass@1، به ازای هر تسک حدود ۰٫۲۰ دلار هزینه دارد و از مدلهای متعددی که هزینه اجرای بهمراتب سنگینتری دارند، عملکرد بهتری به نمایش میگذارد. این مدل حتی در تنظیمات کمهزینهتر با ۰٫۱۱ تا ۰٫۱۴ دلار به ازای هر تسک، همچنان امتیازی در حدود ۷۲ تا ۷۳ درصد کسب میکند.
دیپسیک همچنین از کاهش زمان اجرای تسکها و تولید پاسخهای خلاصهتر خبر داده است؛ قابلیتی که با انجام کار یکسان از طریق توکنهای کمتر و زمان پردازش کوتاهتر، هزینههای استنتاج را کاهش میدهد. این بهروزرسانی برای فریمورکهای ایجنتی از جمله DeepSeek Harness و CodeBuddy و WorkBuddy شرکت تنسنت بهینهسازی شده است.
با این حال، این ارقام عمدتاً نتایج بنچمارکهای داخلی خود شرکت هستند و آزمونهای گوناگون از فریمورکها و شرایط ارزیابی متفاوتی استفاده میکنند؛ بنابراین نمیتوان این نتایج را دلیلی قطعی بر عملکرد یکسان مدل در تمامی کاربردهای واقعی دانست.
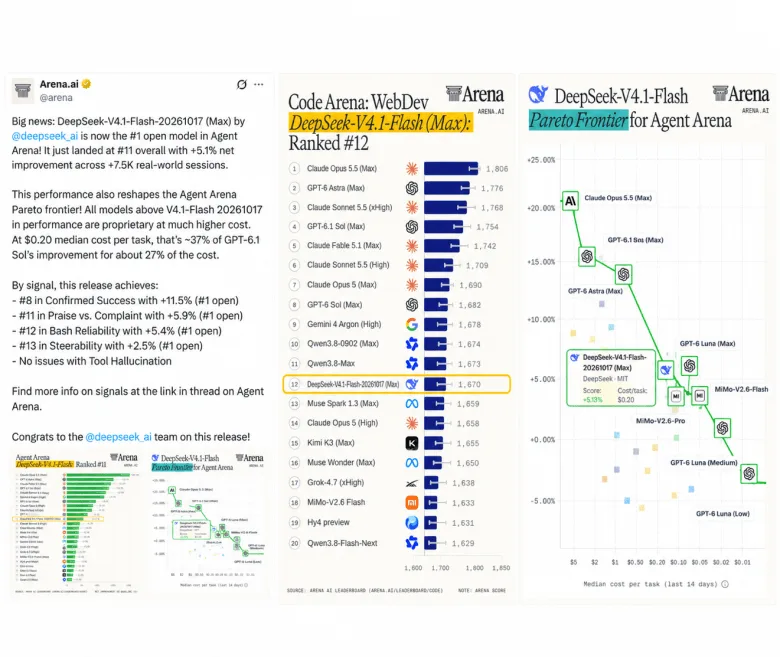
از سوی دیگر، دادههای مستقل لیدربورد Agent Arena در پلتفرم Arena نیز این پیشرفت را تأیید میکنند. طبق گزارش ۲۰ اکتبر رسانه ITHome بر پایه ۷٬۴۹۸ نشست استفاده واقعی، مدل بهروزرسانیشده دیپسیک موفق شده رتبه نخست را در میان مدلهای وزنباز و جایگاه یازدهم را در ردهبندی کلی کسب کند. میانه هزینه اجرای این مدل حدود ۰٫۱۸ دلار به ازای هر تسک برآورد شده، هرچند در صفحات گوناگون لیدربورد ارقامی بین ۰٫۱۸ تا ۰٫۱۹ دلار به چشم میخورد.
متنباز شدن زیرساخت پردازشی دیپسیک
دیپسیک در تاریخ ۲۰ اکتبر، فریمورک استنتاج داخلی خود به نام DeepInfer را همراه با کتابخانه deepseek-recipe بهصورت متنباز منتشر کرد؛ ابزاری که برای پردازش درخواستهای API، آمادهسازی پرامپتها و تحلیل خروجیهای مدل طراحی شده است.
فریمورکهای استنتاج مدیریت نحوه استفاده مدلها از منابع محاسباتی را برای پاسخگویی به درخواستها بر عهده دارند. معماری این فریمورکها مستقیماً بر میزان تأخیر، پهنای باند خروجی (Throughput) و سختافزار مورد نیاز برای سرویسدهی به کاربران اثر میگذارد و یکی از عوامل کلیدی، هرچند کمتر دیدهشده، در تعیین هزینههای عملیاتی هوش مصنوعی به شمار میرود.
دیپسیک فریمورک DeepInfer را بهعنوان هسته اصلی زیرساخت سرویسهای ابری بزرگمقیاس خود معرفی میکند. بر اساس فایل README و مستندات راهاندازی پروژه، نسخه متنباز ارائهشده شامل کرنلهای محاسباتی بهینهسازیشده، زمانبندی ناهمگام (Asynchronous)، پشتیبانی از استنتاج توزیعشده و رمزگشایی گمانهزن (Speculative Decoding) است. این فریمورک در حال حاضر از پردازندههای گرافیکی SM100 انویدیا و تراشههای NPU اسند ۹۵۰ هواوی پشتیبانی میکند و مدل DeepSeek V4.1 Flash مدل سازگار اصلی آن اعلام شده است.
البته این انتشار شامل تمام اجزای چرخه استنتاج نیست. در مستندات دیپسیک اشاره شده است که مواردی مانند سیستم پیشرفته حافظه پنهان KV (KV-cache)، جداسازی مراحل پردازش اولیه و تولید متن (Prefill/Decode Disaggregation) و متعادلسازی بار پردازشی میان نسخههای موازی داده، از ملزومات یک سامانه جامع هستند که تمام آنها در این بسته اولیه پوشش داده نشدهاند؛ هرچند بخش اعظم کارکردهای تفکیک پردازش پیادهسازی شده است.
انتشار این کدهای متنباز دسترسی توسعهدهندگان را به بخشهایی از فناوری میزبانی و سرویسدهی مدلهای دیپسیک فراهم میکند؛ با این حال میزان بهرهوری عملی آن به نوع سختافزار، حجم کاری کاربران و مهندسی نرمافزاری لازم برای راهاندازی وابسته خواهد بود.
کاهش هزینهها تمام ماجرا نیست
دیپسیک در زمان رونمایی نسخه اولیه V4.1 Flash در ماه سپتامبر گزارش داده بود که میزان حافظه رم مورد نیاز برای KV-cache به یکچهارم و فضای ذخیرهسازی SSD به یکهشتم نسل گذشته کاهش یافته است. افزون بر این، این شرکت تعرفه استفاده از API در ساعات خلوت و کمترافیک را با ۵۰ درصد تخفیف نسبت به ساعات اوج مصرف ارائه میدهد.
این شرکت همچنین در ماه اکتبر دسترسی به APIهای جستجو و دریافت داده (Search and Fetch) را با هزینه ۵ یوان به ازای هر ۱٬۰۰۰ درخواست موفق برای توسعهدهندگان باز کرد. علاوه بر این، فراخوانی API دیپسیک در ابزارهای Claude Code و Codex فعلاً رایگان است و سیستم پرداخت به ازای هر درخواست از تاریخ ۱ نوامبر آغاز خواهد شد.
این اقدامات نشان میدهد که دیپسیک ارتقای بهرهوری را بهصورت همزمان در دو سطح مدل و زیرساخت دنبال میکند و قصد دارد ابزارهای دردسترس ایجنتهای هوش مصنوعی را بهشکل چشمگیری توسعه دهد. اینکه آیا این بهینهسازیها در عمل به عملکردی پایدار و کاهش واقعی هزینهها منتهی میشوند یا خیر، به حجم کارهای دنیای واقعی، نحوه استقرار و نگهداری سیستمها بستگی خواهد داشت.
مطالب مرتبط و پیشنهادی
سرمایهگذاری اوپنایآی روی ایمپلنت مغزی جدیدی که سرطان را با هوش مصنوعی شناسایی و درمان میکند
شاخه سرمایهگذاری خطرپذیر اوپنایآی بههمراه صندوق پیتر تیل در استارتاپ کوهرنس سرمایهگذاری کردند؛ شرکتی نوپا که با توسعه ایمپلنت مغزی مجهز به هوش مصنوعی، به دنبال تشخیص زودهنگام و درمان تومورهای سرطانی است. این اقدام نشاندهنده علاقه فزاینده غولهای فناوری به استفاده از دادههای عصبی مغز برای آموزش مدلهای پیشرفته است.
تارگت با چتبات هوش مصنوعی Ask Target به رقابت با آمازون و والمارت پیوست
فروشگاه زنجیرهای تارگت از نسخه آزمایشی چتبات هوش مصنوعی Ask Target رونمایی کرد تا به مشتریان در خریدهای سال نو کمک کند. این دستیار هوشمند با تکیه بر دادههای اختصاصی، تارگت را وارد رقابت مستقیم با سرویسهای هوش مصنوعی والمارت و آمازون میکند.
مدل هوش مصنوعی GLM-4.5-Air رونمایی شد؛ قدرت استدلال ۱۰۶ میلیاردی با مصرف بهینه پردازش
شرکت Z.ai مدل وزنباز جدیدی به نام GLM-4.5-Air را با معماری ترکیبی از متخصصان (MoE) و مجوز MIT منتشر کرد. این مدل ۱۰۶ میلیارد پارامتری با فعالسازی تنها ۱۲ میلیارد پارامتر در هر توکن، امکان استدلال پیشرفته و هدایت ایجنتها را با هزینهای بسیار کمتر فراهم میکند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.