مقایسه عملکرد ChatGPT-6 و Claude Opus 5.5 در ۵ سناریوی روزمره؛ کدام مدل پیروز شد؟
در بررسی و مقایسه جامع دو مدل زبانی پرچمدار OpenAI و Anthropic، یکی از مدلها به تحلیل عمیق مسائل پرداخت، در حالی که دیگری پاسخهای سریع و سرراست را ترجیح داد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- بررسی عملکرد مدلهای زبانی ChatGPT-6 و Claude Opus 5.5 در پنج سناریوی کاربردی و روزمره.
- مدل Claude Opus 5.5 با دقت بالا در جزئیات، درک عمیق شرایط و تحلیل دقیق در ۴ تست از ۵ تست پیروز شد.
- مدل ChatGPT-6 با ارائه پاسخهای سریعتر، ساختاریافتهتر و کاربردیتر در مدیریت وظایف شخصی عملکرد بهتری ثبت کرد.
شرکتهای OpenAI و Anthropic در ماه جاری از مدلهای هوش مصنوعی پرچمدار خود یعنی ChatGPT-6 و Claude Opus 5.5 رونمایی کردند. هر دو مدل به قدری توانمند هستند که بسیار فراتر از نیازهای روزمره و درخواستهای معمول کاربران عمل میکنند.
خانواده GPT-6 شرکت OpenAI بر پایه مدل GPT-6 Astra بنا شده است که تاکنون چشمگیرترین مدل این شرکت به شمار میرود. این مدل در زمینههایی چون استدلال، کارهای حرفهای، کدنویسی، وبگردی و استفاده از رایانه پیشرفتهای چشمگیری داشته است. مدل جدیدتر GPT-6 Sol بخش عمدهای از این هوشمندی را به نسخهای ویژه کارهای روزمره آورده است و OpenAI آن را به عنوان یک مدل استدلالی سریعتر و مقرونبهصرفهتر معرفی میکند.
در سوی دیگر، Claude Opus 5.5 با رویکردی متفاوت وارد میدان شده است. Anthropic آن را مدلی ساختهشده برای پردازشهای طولانی ایجنتها و کارهای دانشمحور توصیف میکند که با تفکر تطبیقی، میزان تلاش مورد نیاز برای هر درخواست را میسنجد. این مدل دارای پنجره زمینه یک میلیون توکنی است، میتواند تا ۱۲۸ هزار توکن خروجی تولید کند و طبق گزارش Anthropic، در بیشتر وظایف عملکردی مشابه مدل ردهبالای Claude Fable 5.1 دارد، در حالی که هزینه اجرای آن ۴۰ درصد کمتر از نسخه قبلی Opus است. این شرکت همچنین بر بهبود ارتباط طبیعی مدل و پیروی دقیق از دستورالعملهای نگارشی تاکید کرده است.
این تفاوتها روی کاغذ بسیار جذاب به نظر میرسند، اما لزوماً مشخص نمیکنند که در دنیای واقعی کدام چتبات میتواند دستیار بهتری باشد.
در همین راستا، در بررسیهای انجامشده پنج پرامپت (دستور) کاملاً یکسان به ChatGPT-6 و Claude Opus 5.5 داده شد. نتایج به دستآمده برخلاف تصور اولیه، یکطرفه نبود و هر کدام نقاط قوت خاص خود را به نمایش گذاشتند. در ادامه نتایج این آزمایشهای روزمره بررسی میشود.
۱. برنامهریزی پیچیده در دنیای واقعی — محدودیتها و قدرت قضاوت
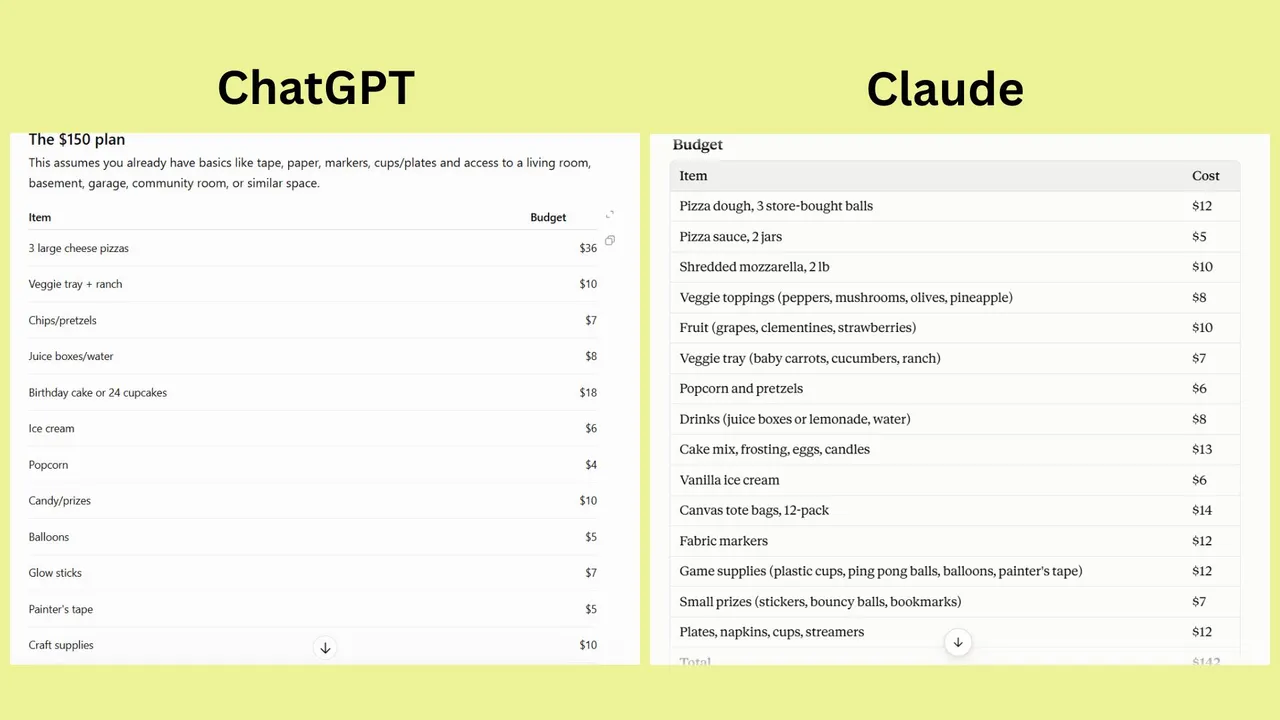
پرامپت: من ۱۵۰ دلار بودجه برای برنامهریزی یک جشن تولد برای ۱۰ کودک ۸ تا ۱۱ ساله دارم. این جشن باید سه ساعت طول بکشد، در صورت بارندگی در فضای بسته قابل اجرا باشد، شامل غذا باشد و استفاده از نمایشگرها در آن به حداقل برسد. دو کودک گیاهخوار هستند و یک نفر حساسیت به بادام زمینی دارد. یک برنامه کامل شامل بودجهبندی، جدول زمانی، فعالیتها و برنامه جایگزین طراحی کن. بودجه نباید از ۱۵۰ دلار فراتر برود.
ChatGPT با ارائه یک هویت و جهتگیری سریع برای رویداد، چارچوب مفهومی شفافی ارائه داد. اختصاص ۳۶ دلار برای سفارش ۳ پیتزای پنیر، در عمل برای والدینی که میزبان ۱۰ کودک هستند بسیار آسانتر از پخت مینیپیتزاهای خانگی در آشپزخانه است. این مدل همچنین نیاز به «بودجه اضطراری» در پایان کار را بهخوبی درک کرد.
Claude در برخورد با آلرژیها و پروتکلهای غذایی رویکردی هوشمندانه و پیشگیرانه داشت. این مدل به خطر آلودگی متقاطع در کیکهای قنادی و پودرهای آماده نیز توجه کرد. افزون بر این، با اختصاص ۱۴ دلار برای کیفهای پارچهای و ۱۲ دلار برای ماژیکهای پارچه، یک بودجهبندی دومنظوره انجام داد که هم به عنوان فعالیت کاردستی هنگام ورود و هم به عنوان هدیه پایان جشن کاربرد داشت؛ این کار باعث صرفهجویی و حذف پلاستیکهای ارزانقیمت شد. ارائه یک جدول زمانی عملیاتی و راهحلهایی برای مشکلات احتمالی از دیگر نقاط قوت این مدل بود.
برنده: Claude پیروز شد؛ زیرا یک برنامه کامل و آماده اجرا با رعایت دقیق اصول ایمنی ارائه داد، در حالی که خروجی ChatGPT بیشتر شبیه به یک لیست خرید پراکنده بود.
۲. نگارش — انسانی کردن لحن هوش مصنوعی
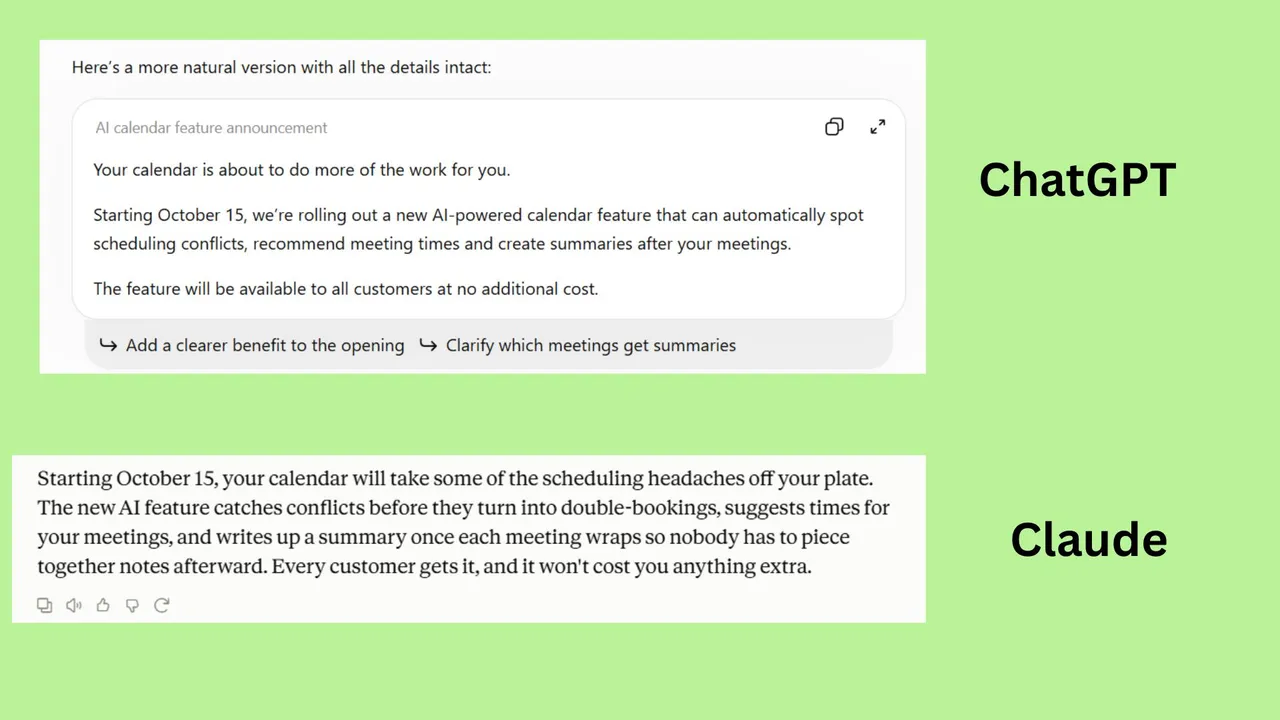
پرامپت: این اطلاعیه خستهکننده را طوری بازنویسی کن که شبیه متنی شود که یک انسان واقعی مایل به خواندن آن باشد. تمام جزئیات واقعی را حفظ کن، از خط تیره بلند استفاده نکن، از کلیشهها بپرهیز و کلماتی مثل «هیجانانگیز»، «انقلابی»، «تحولآفرین» یا «یکپارچه» را به کار نبر.
«شرکت ما در حال معرفی یک قابلیت جدید تقویم مبتنی بر هوش مصنوعی است که بهطور خودکار تداخلهای زمانی را تشخیص میدهد، زمان جلسات را پیشنهاد میکند و پس از جلسات خلاصهای از آنها تهیه میکند. این ویژگی ۱۵ اکتبر راهاندازی میشود و بدون هزینه اضافی برای تمامی مشتریان در دسترس خواهد بود.»
ChatGPT یک جمله جذاب و گیرا ارائه داد که مخاطب را درگیر میکرد. این مدل از سبکهای نگارشی رایج هوش مصنوعی پرهیز کرد و تمام جزئیات واقعی را نگه داشت. همچنین فاصلهگذاری مناسب پاراگرافها، خواندن سریع متن را آسانتر کرد.
Claude موارد کلیدی را به مزیتهای ملموس انسانی تبدیل کرد و جزئیات را حول محور کاهش فشارهای واقعی در محیط کار بازنویسی نمود.
برنده: Claude پیروز شد؛ زیرا بهخوبی درک کرد که بازنویسی «انسانی» نیازمند بازنگری در نحوه بیان ارزش ویژگیهاست و صرفاً نباید به جابهجایی چند فعل در متن اصلی بسنده کرد.
۳. استدلال — پاسخ بدیهی نیست
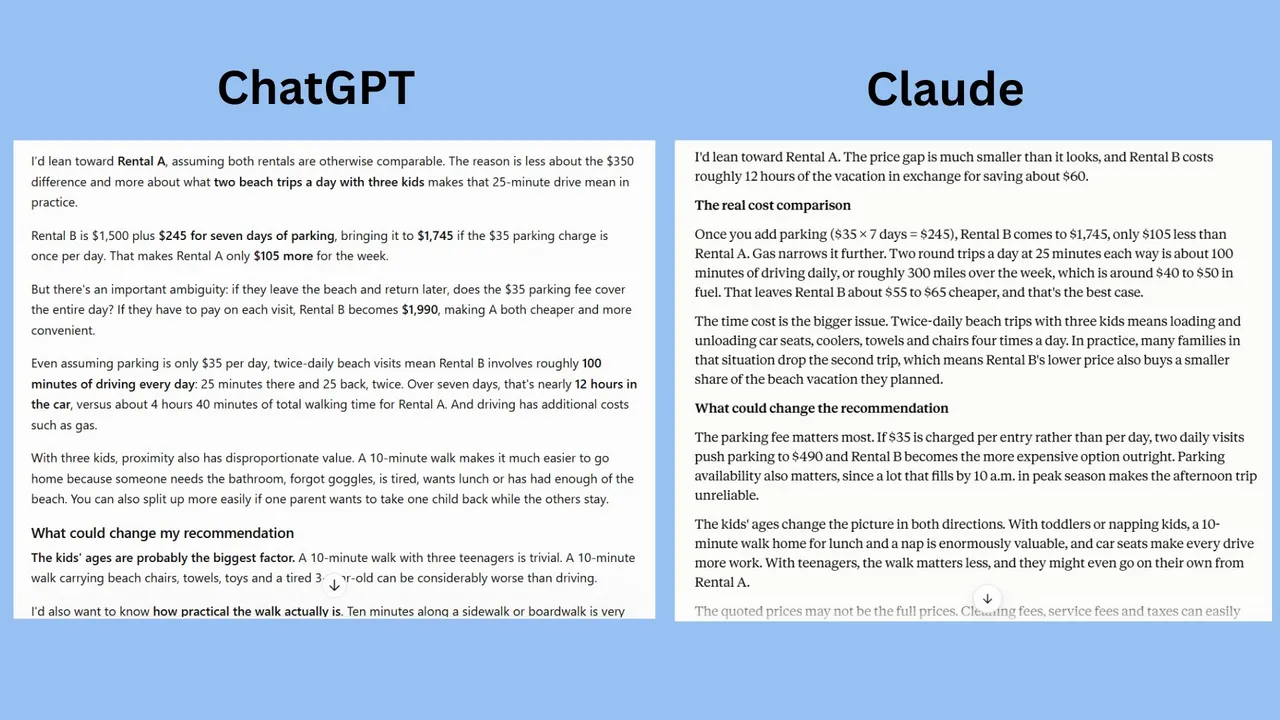
پرامپت: یک خانواده در حال انتخاب بین دو اقامتگاه برای تعطیلات است. اقامتگاه A حدود ۱۸۵۰ دلار هزینه دارد و فاصله آن تا ساحل ۱۰ دقیقه پیادهروی است. اقامتگاه B با هزینه ۱۵۰۰ دلار در دسترس است، اما برای رسیدن به ساحل نیاز به ۲۵ دقیقه رانندگی دارد و روزانه ۳۵ دلار هزینه پارکینگ در پی خواهد داشت. آنها هفت روز اقامت دارند و قصد دارند روزی دو بار به ساحل بروند. این خانواده سه فرزند دارد. کدام اقامتگاه را باید انتخاب کنند؟ فقط هزینهها را محاسبه نکن. عواملی که میتوانند پیشنهاد تو را تغییر دهند را مشخص کن و بگو چه اطلاعات اضافهای بیشترین اهمیت را دارد.
ChatGPT بهترین دیدگاه متقابل را درباره سن کودکان ارائه داد. این مدل هوشمندانه اشاره کرد که «۱۰ دقیقه پیادهروی» بسته به زیرساختها (مانند مسیر تختهپوش در برابر عبور از یک بزرگراه چهاربانده یا تپههای شنی) بسیار متفاوت است. این چتبات مشخصاً خاطرنشان کرد که اقامتگاه A به والدین اجازه میدهد تا در صورت نیاز از هم جدا شوند (مثلاً یک والد کودک خسته را به اقامتگاه برگرداند در حالی که والد دیگر با دو کودک دیگر در ساحل بماند).
Claude در واقع محاسبات مسافت و هزینهها را بهطور دقیق انجام داد و ثابت کرد که صرفهجویی مالی اقامتگاه B در کل هفته تنها حدود ۵۵ تا ۶۵ دلار است که رقم ناچیزی به حساب میآید. Claude همچنین یک نکته روانشناختی ظریف را مطرح کرد: سوار و پیاده کردن سه کودک در صندلی ماشین، آن هم چهار بار در روز، احتمالاً باعث میشود خانواده از دومین برنامه روزانه ساحل منصرف شوند. این مدل بهدرستی به هزینههای پنهان پلتفرمهای اجاره اقامتگاه اشاره کرد؛ نرخهای پایه شامل هزینههای نظافت، خدمات یا مالیات نمیشوند و همین موارد بهتنهایی میتوانند تفاوت ۱۰۵ دلاری را کاملاً برعکس کنند.
برنده: Claude با اختلافی اندک پیروز شد. اگرچه ChatGPT بهترین استدلال تکموردی را داشت (تشخیص اینکه پیادهروی با وسایل سنگین ساحل و کودکان خردسال میتواند طاقتفرساتر از رانندگی باشد)، اما Claude در مجموع برنده شد؛ زیرا تحلیل مالی آن تا ریزترین جزئیات دقیق بود، هزینههای پنهان را پیشبینی کرد و بهدرستی متوجه شد که سختیهای رفتوآمد با خودرو باعث لغو بخشی از برنامههای روزانه خانواده میشود.
۴. انبوه گزینهها — یافتن آنچه اهمیت دارد
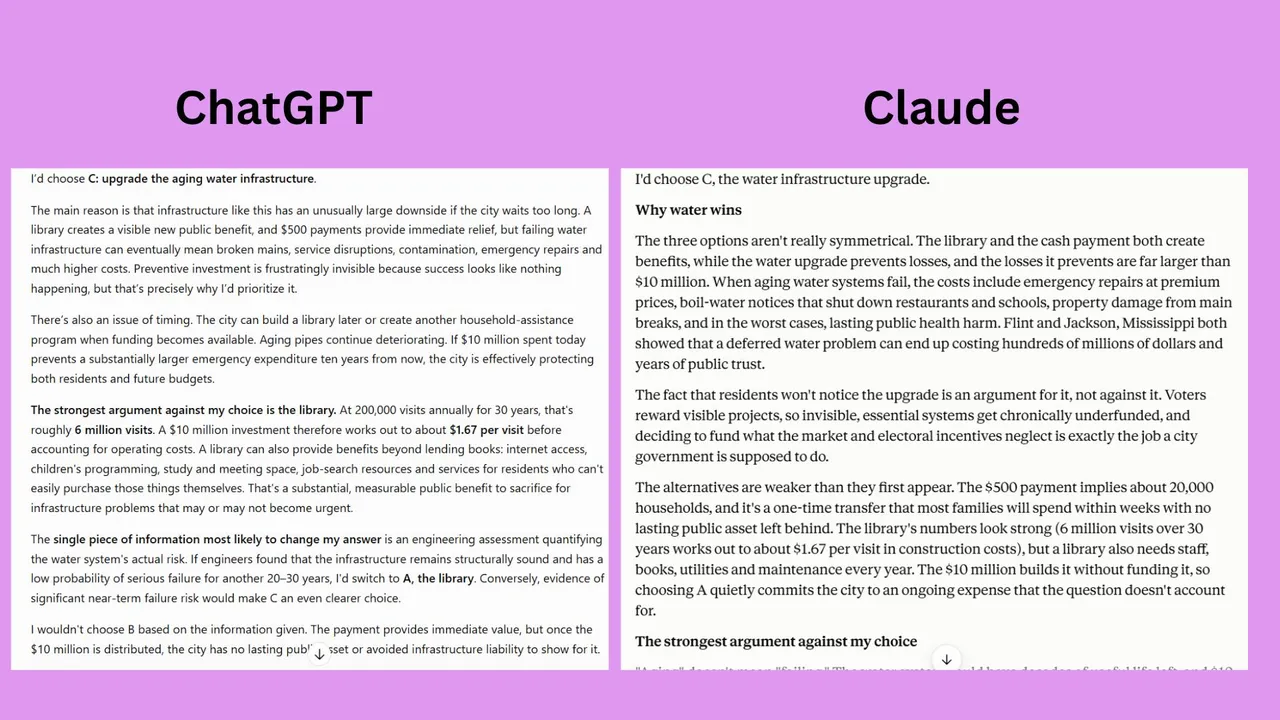
پرامپت: یک شهر ۱۰ میلیون دلار بودجه برای هزینه کردن دارد و سه گزینه پیش رو است:
الف) ساخت یک کتابخانه عمومی جدید که انتظار میرود حداقل ۳۰ سال، سالانه ۲۰۰ هزار بازدیدکننده داشته باشد.ب) پرداخت ۵۰۰ دلار کمکنقدی یکباره به هر خانوار.ج) ارتقای زیرساختهای فرسوده آب، پروژهای که ساکنان متوجه آن نخواهند شد مگر آنکه مشکلی پیش بیاید.
شهر تنها میتواند یک گزینه را انتخاب کند. بهترین گزینه را مشخص کن. دلایل خود را توضیح بده، قویترین استدلال مخالف با انتخابت را بیان کن و بگو چه اطلاعات اضافهای میتواند پاسخ تو را تغییر دهد. با گفتن اینکه «هر سه گزینه خوب هستند»، از دادن پاسخ صریح طفره نرو.
ChatGPT بهخوبی تمام دستورالعملها را رعایت کرد و دفاعیهای خوانا و منطقی برای گزینه «ج» ارائه داد. این مدل همچنین آستانه ارزیابیهای مهندسی را بهروشنی تعریف کرد.
Claude انتخاب خود را در چارچوب انگیزهها و سیاستهای شهری مطرح کرد و بهدرستی تشخیص داد که تأمین مالی پروژههایی که در سیاستهای انتخاباتی نادیده گرفته میشوند، وظیفه اصلی مدیریت شهری است.
برنده: Claude پیروز شد؛ زیرا پاسخ بسیار بهتری ارائه داد. این چتبات گویی در مدیریت مالیه عمومی تجربه داشت، در حالی که پاسخ ChatGPT بیشتر به صورت استاندارد و سطحیواره به نظر میرسید.
۵. آزمایش نهایی — درخواست مبهم و قدرت ابتکار
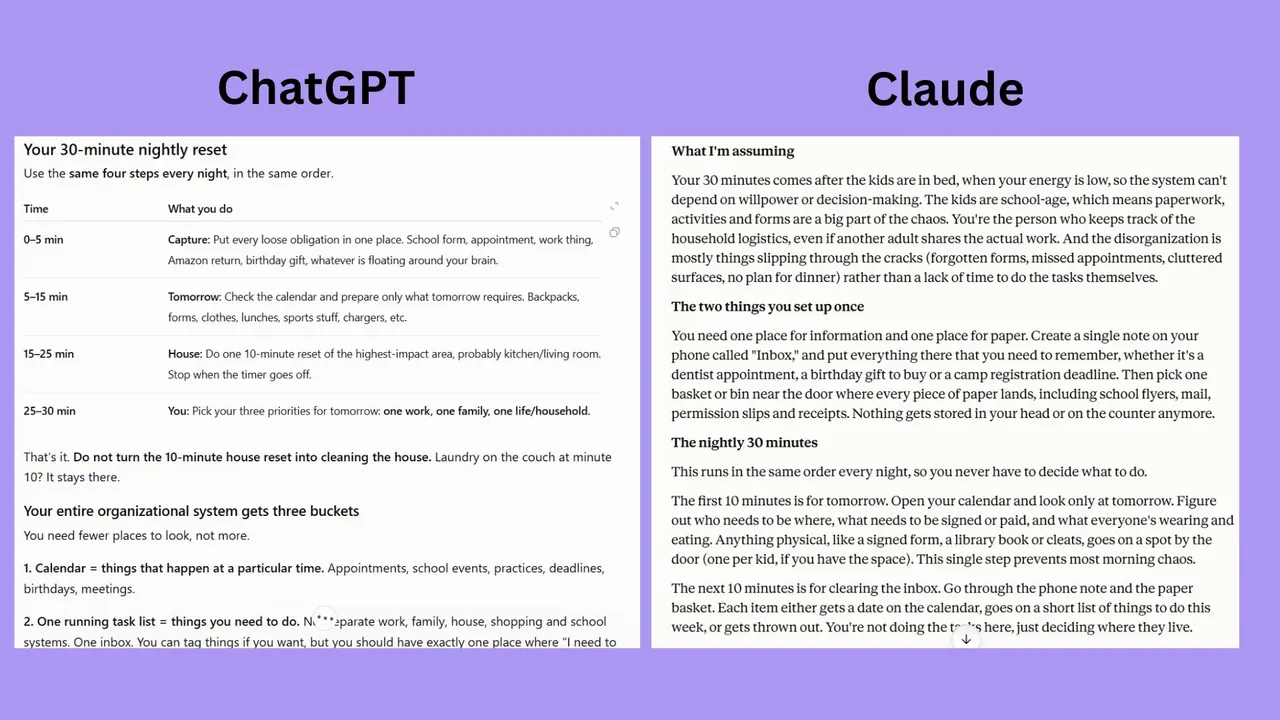
پرامپت: زندگی من بینظم شده است. سه فرزند، یک شغل تماموقت، مسئولیتهای خانه و تنها حدود ۳۰ دقیقه وقت آزاد در هر عصر دارم تا اوضاع را کنترل کنم. یک سیستم برای من طراحی کن که واقعاً بتوانم آن را حفظ کنم. از توصیههای کلی بهرهوری پرهیز کن. هر جا لازم است فرضیات منطقی در نظر بگیر، به من بگو چه فرضیاتی داشتهای و برنامهای به من بده که بتوانم از همین امشب شروع کنم.
ChatGPT راهکارهایی ساده برای جلوگیری از فرسودگی ارائه داد و دستورالعملهایی را به صورت گامبهگام درآورد تا کاربر نیازی به برنامهریزی ذهنی یا حدس زدن نقطه شروع نداشته باشد.
Claude به بار روانی مسئله پرداخت که نشاندهنده درک دقیق و عمیق این مدل از دلایل بینظمی بود. این مدل همچنین به ترفند کاربردی واگذاری کارهای خانه در صورت امکان اشاره کرد و پذیرفت که یک والد بهتنهایی نمیتواند موتور محرک یک خانواده پنجنفره باشد.
برنده: ChatGPT پیروز شد؛ زیرا چارچوب شناختی آن بهمراتب محافظت بیشتری از ظرفیت ذهنی یک والد خسته به عمل میآورد. Claude یک روال منظم خانگی خوب ارائه داد، اما ChatGPT یک فیلتر تصمیمگیری کاربردی خلق کرد که مانع از تداخل و آسیبرسانی کار، خانواده و زندگی شخصی به یکدیگر میشود.
برنده نهایی: Claude
پس از انجام پنج آزمایش، Claude Opus 5.5 در چهار مورد پیشتاز بود. اما نکته قابلتوجه این بود که تفاوت بین این دو مدل در وظایف کاملاً نامرتبط، بهشکلی پایدار تکرار میشد. Claude همیشه تمایل داشت عمیقتر مسائل را بشکافد.
هنگامی که از این مدل خواسته شد یک جشن تولد را برنامهریزی کند، به خطر آلودگی متقاطع مواد غذایی توجه کرد و راههایی یافت تا یک خرید، دو کاربرد داشته باشد. در مسئله اجاره اقامتگاه، هزینههایی را محاسبه کرد که صراحتاً در پرامپت خواسته نشده بود و به این فکر کرد که آیا زحمت رانندگی واقعاً رفتار خانواده را تغییر میدهد یا خیر. حتی در تصمیمگیری برای نحوه هزینهکرد ۱۰ میلیون دلار توسط شهرداری، فراتر از مزایا و معایب آشکار رفت و ریشههای تصمیمات دولتی را موشکافی کرد.
این دقیقاً همان نقطهای است که Opus 5.5 قدرت خود را به رخ میکشد. در مقابل، ChatGPT-6 عموماً روندی سرراستتر داشت که کاملاً با ماهیت و برند ChatGPT همخوانی دارد. فارغ از نوع مدل، ChatGPT همواره به عنوان مدلی شناخته میشود که کمتر به حاشیه میرود و سریعتر به اصل مطلب میپردازد. این ویژگی باعث میشود گاهی پاسخهای آن به اندازه Claude عمیق نباشد؛ با این حال، همین رویکرد مستقیم در آخرین آزمایش به یک مزیت بزرگ برای این مدل تبدیل شد.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی

رکورد ۸۳۳ هزار دانلود ماهانه برای LEGAL-BERT؛ وقتی توسعهدهندهها قید مدلهای گرانقیمت را میزنند!
مدل زبانی تخصصی LEGAL-BERT با ثبت بیش از ۸۳۳ هزار دانلود در ماه روی پلتفرم هاگینگ فیس حسابی خبرساز شده است. این ابزار جمعوجور و تخصصی نشان میدهد که برای پردازش و تحلیل متون حقوقی، حتماً نیازی به مدلهای غولپیکر و پرهزینه ندارید و گزینههای بهینه همچنان در اوج هستند.

جاسوسی هوش مصنوعی در محل کار؛ کارمندان میگویند کارفرماها باید قانوناً مچگیریهایشان را لو بدهند!
نظرسنجیهای تازه نشان میدهد که بیشتر کارمندان حس میکنند مدیرانشان با ابزارهای هوش مصنوعی تمام حرکات آنها را زیر نظر گرفتهاند. حالا بیش از ۸۰ درصد شاغلان خواستار تصویب قانونی شدهاند که شرکتها را مجبور کند هرگونه مچگیری و نظارت هوش مصنوعی در محیط کار را رسماً اعلام کنند.

گزارش داغ مایکروسافت از نفوذ جهانی هوش مصنوعی؛ امارات در صدر و رتبه عجیب آمریکا!
مایکروسافت در تازهترین گزارش خود از ضریب نفوذ هوش مصنوعی در جهان پرده برداشت؛ آماری شگفتانگیز که نشان میدهد امارات و سنگاپور با فاصلهای خیرهکننده پیشتاز دنیا هستند و در مقابل، آمریکا در رتبه ۲۱ جا مانده است. همچنین الگوی استفاده از هوش مصنوعی میان کشورهای غربی و کشورهای در حال توسعه، از تفاوتی عمیق میان کاربردهای روزمره و آموزش پرده برمیدارد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.