دیفیوژن کنترلر گوگل وارد میدان شد؛ شکست سنگین LoRA و پیروزی در ۹۰ درصد رقابتهای کیفیت تصویر
محققان گوگل ریسرچ با معرفی معماری «دیفیوژن کنترلر» (Diffusion Controller)، روش تازهای برای هدایت مدلهای تبدیل متن به تصویر ابداع کردند که بدون دستزدن به وزنهای اصلی مدل، کیفیت خروجی را دگرگون میکند. این شبکه جانبی در آزمایشها توانسته رقیب نامآشنای خود یعنی LoRA را پشت سر بگذارد و در ۹۰ درصد بررسیهای کیفی پیروز میدان شود. این دستاورد میتواند نحوه شخصیسازی و کنترل دقیق مدلهای تصویری را برای همیشه متحول کند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- گوگل ریسرچ با چارچوب Diffusion Controller فرایند تولید تصویر را مثل یک سیستم کنترل هوشمند میبیند؛ یک شبکه کمکی که در هر مرحله نویززدایی مسیر ساخت عکس را اصلاح میکند تا مدل دقیقاً همان چیزی را بسازد که کاربر خواسته است.
- این روش هوشمندانه مدل پایه را کاملاً دستنخورده (فریز) نگه میدارد، اما در عمل توانسته روش محبوب LoRA را شکست دهد و در ۹۰ درصد ارزیابیهای کیفی کاربران (معیار HPS-v2) سربلند بیرون بیاید.
- بزرگترین چالش استفاده از این فناوری در حال حاضر، نیاز به دسترسی مستقیم به مراحل میانی سمپلر (رویکرد جعبهخاکستری) است؛ یعنی پلتفرمهای ابری برای استفاده از آن باید سیستمهای پردازش تصویر خودشان را از پایه بازطراحی کنند.
گوگل مسیر هدایت مدلهای دیفیوژن را به چشم یک «مسئله کنترل» میبیند
تیم تحقیقاتی گوگل ریسرچ (Google Research) بهتازگی از چارچوب جدیدی به نام «دیفیوژن کنترلر» (Diffusion Controller) رونمایی کرده است؛ روشی نوآورانه برای هدایت مدلهای تبدیل متن به تصویر با کمک یک شبکه کمحجم که دوشادوش فرایند نویززدایی فعالیت میکند. این کنترلکننده بدون آنکه به وزنهای مدل پایه دست بزند یا آنها را تغییر دهد (فریز بودن مدل پایه)، در هر مرحله از نمونهبرداری مسیر تولید تصویر را به سمت پاداش دلخواه تنظیم و هدایت میکند.
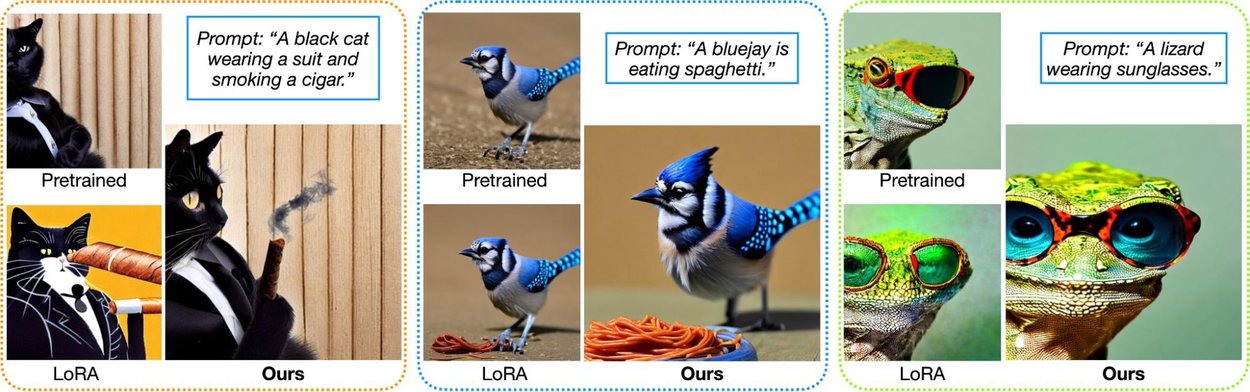
آزمایشهای گزارششده روی مدل محبوب «استیبل دیفیوژن» (Stable Diffusion v1.4) نشان میدهد که قدرتمندترین نسخه جعبهسفید (White-box) این کنترلر توانسته در معیار سنجش ترجیح انسانی (HPS-v2) به نرخ پیروزی خیرهکننده ۹۰ درصدی در برابر مدل پیشفرض برسد. نسخه جعبهخاکستری (Gray-box) هم در فاینتیونینگ نظارتشده و هم در آموزش مبتنی بر پاداش، عملکردی بسیار بهتر از LoRA به نمایش گذاشته است. این دستاورد یک چارچوب یکپارچه در اختیار توسعهدهندگان میگذارد؛ در حالی که قبلاً دنیای هدایت مدلها میان «تنظیمات زمان استنتاج» و «فاینتیونینگ مدل» دوپاره شده بود.
اصلاحات لحظهای درون چرخه نویززدایی
مدلهای دیفیوژن کار خود را با نویز خالص آغاز میکنند و با پیشبینی مکرر نمایشهای نهفته پاکتر، کمکم تصویر نهایی را شکل میدهند. حالا دیفیوژن کنترلر این توالی مرحلهبهمرحله را شبیه یک سیستم پویا (دینامیکی) میداند که مسیر حرکت آن در تکتک گامها قابل اصلاح و تنظیم است.
در طول فرایند نمونهبرداری، این شبکه جانبی وضعیت نهفته میانی را با دقت رصد میکند و بر اساس هدفی مشخص مانند همخوانی دقیق با پرامپت، زیباییشناسی بصری، سبک نقاشی یا هر ترجیح یادگرفتهشده دیگر، یک تصحیح فوری اعمال مینماید. این تصحیح، انتقال گام بعدی نویززدایی را جهتدهی میکند، بدون اینکه کوچکترین تغییری در وزنهای اصلی مدل ایجاد شود.
یک نگاه کنترلی یکپارچه برای جعبهابزاری چندتکه
تا پیش از این، روش هدایت بدون طبقهبندیکننده (Classifier-free guidance یا همان CFG) تعیین میکرد که سمپلر دیفیوژن در زمان استنتاج چقدر سفتوسخت از پرامپت پیروی کند. از آن طرف، LoRA مسیر دیگری را میرفت و با تزریق ماتریسهای رتبهپایین و قابلآموزش به لایههای خاصی از مدل، آن را شخصیسازی میکرد. علاوه بر اینها، روشهای رگرسیون وزندار با پاداش و گرادیان خطمشی هم راههای دیگری برای بهینهسازی خروجیها بر اساس سیگنالهای ترجیحی بودند.
دیفیوژن کنترلر تمام این ابزارهای پراکنده را زیر چتر یک فرمولبندی مشترک در «نظریه کنترل» جمع کرده است. در این دیدگاه، وضعیت نویززدایی به عنوان وضعیت سیستم، اصلاحات کنترلر به عنوان اکشن (Action) و پاداش تصویر نهایی به عنوان هدف بهینهسازی تعریف میشوند. چنین فرمولبندی دقیقی یک زبان و بستر مشترک به پژوهشگران میدهد تا اهداف آموزشی، رفتار نمونهبرداری و میزان انحراف از مدل پیشفرض را به بهترین شکل تجزیه و تحلیل کنند.
دو مسیر مستقیم از پاداش تا کنترل خروجی
مقاله پژوهشی گوگل دو روش کاربردی برای آموزش این کنترلر بر اساس پاداش دریافتی در پایان تولید تصویر معرفی کرده است:
- بهینهسازی پروگزیمال خطمشی (PPO): این الگوریتم مسیرهای نویززدایی را نمونهبرداری میکند، به تصویر نهایی آنها امتیاز میدهد و سپس با تغییرات برشخورده و کنترلشده در خطمشی، کنترلر را آپدیت میکند تا فرایند آموزش پایدار و بدون نوسان باقی بماند.
- تابع زیان وزندار با پاداش (RWL): در این روش، وزن بیشتری به مسیرهایی داده میشود که پاداش بالاتری گرفتهاند؛ بدین ترتیب کنترلر میتواند مستقیماً از طریق یک تابع رگرسیون ساده و سرراست، از تولیدات موفق تصویر درس بگیرد.
هر دو روش میتوانند از بازخوردهای انسانی، مدلهای یادگیرنده پاداش یا توابع امتیازدهی مشتقپذیر استفاده کنند. البته میزان کارآمدی آنها کاملاً به این بستگی دارد که آیا سیگنال پاداش واقعاً رفتار مطلوب را تشخیص میدهد یا به اشتباه به ناهنجاریهای تصویری و میانبُرهای گمراهکننده امتیاز بالا میدهد.
مرز دسترسی: کنترلر کجا و چگونه کار میکند؟
سطح دسترسی به چرخه نویززدایی نقشی حیاتی در تعیین محل پیادهسازی این چارچوب دارد. در استقرار جعبهخاکستری، وزنهای اصلی مدل میتوانند کاملاً محرمانه باقی بمانند، اما سیستم حتماً باید وضعیتهای میانی نمونهبرداری را در دسترس بگذارد و اجازه دهد در میان گامها اصلاحاتی انجام شود. بنابراین، رابطهای برنامهنویسی (API) معمولی که صرفاً یک پرامپت متنی میگیرند و یک عکس تحویل میدهند، دسترسی لازم برای اجرای چنین کنترلی را ندارند.
محققان گوگل در این پژوهش چهار نسخه مختلف را زیر ذرهبین بردهاند:
نسخه مدل | سطح دسترسی | طراحی و معماری |
|---|---|---|
دیفیوژن کنترلر (Diffusion Controller) | جعبهخاکستری | از میانگین معکوس میانی و جریان آداپتور جانبی استفاده میکند؛ در حالی که مدل پایه کاملاً فریز و دستنخورده باقی میماند. |
دیفیوژن کنترلر ساده (Naive) | جعبهخاکستری | ورودی میانگین معکوس و جریان آداپتور را حذف میکند تا میزان تأثیرگذاری آنها را بسنجد. |
دیفیوژن کنترلر مشترک (Diffusion Controller-J) | جعبهسفید | کنترلر و مدل پایه را بهصورت همزمان و مشترک آموزش میدهد. |
دیفیوژن کنترلر مستقل (Diffusion Controller-S) | جعبهسفید | کنترلر و مدل پایه را به شکل کاملاً جداگانه آموزش میدهد. |
همین تفاوتها باعث میشود که استفاده از این فناوری روی سرویسهای ابری و میزبانیشده فعلی با محدودیت روبهرو شود؛ چرا که ارائهدهندگان خدمات یا باید هوکهای سطح سمپلر را باز کنند یا این کنترلر را مستقیماً درون زیرساختهای پردازشی خود بگنجانند.
نتایج خیرهکننده: پیروزیهای پیاپی در ارزیابیها
آزمایشها روی بدنه اصلی مدل Stable Diffusion v1.4 و با استفاده از فاینتیونینگ نظارتشده، تابع زیان وزندار با پاداش و PPO انجام شده است. برای سنجش کیفیت، محققان هم از شاخص HPS-v2 (معیار سنجش ترجیح انسانی) و هم از قضاوت مستقیم کاربران روی پرامپتهای پیچیده کمک گرفتهاند.
یافته گزارششده | مقایسه عملکرد | دامنه و شرایط |
|---|---|---|
۹۰ درصد نرخ پیروزی HPS-v2 | نسخه مشترک (Diffusion Controller-J) در برابر مدل پایه پیشفرض | قدرتمندترین پیکربندی جعبهسفید |
نرخ پیروزی بالاتر در HPS-v2 | نسخه جعبهخاکستری دیفیوژن کنترلر در مقایسه با LoRA | آموزش نظارتشده و آموزش مبتنی بر پاداش |
بیشترین انتخاب و ترجیح کاربران | نسخههای مختلف کنترلر در ارزیابی انسانی | پرامپتهای پیچیده با چندین ویژگی همزمان |
آمار پیروزی ۹۰ درصدی حاصل رقابت رودررو با مدل پایه این آزمایش بوده است. با این حال، نتیجه نسخه جعبهخاکستری برای توسعهدهندگانی جذابتر و کاربردیتر است که میتوانند خط لوله نمونهبرداری را دستکاری کنند، اما اجازه بازبینی یا دستکاری وزنهای اصلی مدل را ندارند.
در زمان استنتاج، همهچیز بسیار ساده مدیریت میشود: تنها یک پارامتر شدت هدایت، میزان تصحیحات کنترلر را مشخص میکند. توسعهدهندگان میتوانند درست مثل ضریب CFG که قدرت پرامپت را کم و زیاد میکند، با تنظیم این پارامتر، تعادل دلخواه خود میان اطاعت از پاداش و حفظ رفتار طبیعی مدل پایه را برقرار کنند.
چکلیست کاربردی برای پیادهسازی و بهکارگیری
تیمهایی که قصد دارند دیفیوژن کنترلر را در پروژههای واقعی خود پیادهسازی کنند، باید این پنج شرط و نیاز فنی را مد نظر قرار دهند:
- دسترسی به سمپلر: باید وضعیتهای نهفته میانی در دسترس باشند و امکان اعمال تصحیح در هر گام از نویززدایی فراهم شود.
- یک سیستم پاداش قابلاعتماد: باید سیستمی برای امتیازدهی تعریف شود که سبک، سلیقه بصری، خطمشی یا نتیجه نهایی مدنظر را بهدرستی بازتاب دهد.
- دادههای آموزشی: جمعآوری مسیرهای تولیدشده تصاویر همراه با پاداش آنها، امتیازهای کاربران انسانی یا اهداف نظارتشده ضروری است.
- تست عملکرد در زمان اجرا: سنجش میزان تأخیر (Latency) و مصرف حافظه تحمیلشده توسط شبکه جانبی در تمام طول نمونهبرداری باید با دقت اندازهگیری شود.
- ارزیابی مستقل و بیطرفانه: میزان پایبندی به پرامپت، کیفیت بصری، تنوع تصاویر و احتمال تقلب در دریافت پاداش (Reward Hacking) باید روی توزیع پرامپتهای واقعی تست شود.
این چارچوب نوین میتواند بدون نیاز به کپیکردن یا تغییر مدل اصلی، امکاناتی مانند شخصیسازی، هماهنگی با هویت بصری برندها و نظارت بر رعایت خطمشیها را فراهم آورد. البته در زمینه ایمنی هوش مصنوعی به بررسیهای موشکافانهتری نیاز است؛ زیرا صرف بهینهسازی بر اساس مدل پاداش، تضمین صددرصدی برای مسدودسازی تمام خروجیهای نامناسب یا خطرناک ایجاد نمیکند.
شایان ذکر است که تمام یافتههای فعلی روی مدل نسبتاً قدیمی Stable Diffusion v1.4 آزمایش شدهاند؛ بنابراین عملکرد آن روی معماریهای مدرنتر، سیستمهای اختصاصی و مدلهای دیفیوژن ویدیویی هنوز در هالهای از ابهام است. علاوه بر این، گوگل هنوز کد منبع عمومی این پژوهش را منتشر نکرده و تیمها برای تست آن روی مدلها و سیگنالهای پاداش خود، در حال حاضر باید این معماری را از روی مقاله بازپیادهسازی کنند.
مطالب مرتبط و پیشنهادی
ترفند ۳.۹ میلیارد دلاری متا؛ تبدیل دیتاسنترهای هوش مصنوعی به تخفیف مالیاتی نجومی!
شرکت متا با یک ترفند حسابداری زیرکانه و ثبت رکهای سرور هوش مصنوعی به عنوان «تجهیزات آزمایشی»، توانسته معافیت مالیاتی پژوهشی خود را به رقم سرسامآور ۳.۹ میلیارد دلار برساند. کارشناسان مالیاتی این اقدام را از نظر قانونی بسیار پرریسک و مشکوک میدانند، اما در صورت تأیید، راه برای معافیتهای مالیاتی نجومی سایر غولهای هوش مصنوعی نیز هموار خواهد شد.
رونمایی AMD از ایجنت هوش مصنوعی Ross؛ انقلابی در طراحی سختافزار و سیستمهای امبدد
شرکت AMD با رونمایی از ایجنت هوش مصنوعی Ross، به سراغ دگرگونکردن چرخه توسعه سیستمهای امبدد و سختافزارهای پیشرفته رفته است. این دستیار هوشمند با اتصال مستقیم به زنجیره ابزارهای مهندسی، فرآیندهای چندهفتهای طراحی و بستن زمانبندی تراشهها را به چند ساعت کاهش میدهد و همکاری بین مهندسان سختافزار و نرمافزار را از همیشه سادهتر میکند.
آموزش فیزیک واقعی به هوش مصنوعی ویدیوساز؛ فریمورک Physis-Lang انویدیا مدل Veo 3.1 گوگل را شکست داد
انویدیا با معرفی فریمورک متنباز Physis-Lang، یکی از بزرگترین نقطهضعفهای هوش مصنوعی در تولید ویدیو را هدف گرفته و قوانین دنیای واقعی مثل جاذبه و گرما را به مدلها آموزش میدهد. این سیستم با غنیسازی پرامپتها و دادههای آموزشی بر اساس علت و معلول، توانسته حتی از مدل قدرتمند Veo 3.1 گوگل هم در درک فیزیک پیشی بگیرد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.