آموزش فیزیک واقعی به هوش مصنوعی ویدیوساز؛ فریمورک Physis-Lang انویدیا مدل Veo 3.1 گوگل را شکست داد
انویدیا با معرفی فریمورک متنباز Physis-Lang، یکی از بزرگترین نقطهضعفهای هوش مصنوعی در تولید ویدیو را هدف گرفته و قوانین دنیای واقعی مثل جاذبه و گرما را به مدلها آموزش میدهد. این سیستم با غنیسازی پرامپتها و دادههای آموزشی بر اساس علت و معلول، توانسته حتی از مدل قدرتمند Veo 3.1 گوگل هم در درک فیزیک پیشی بگیرد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- انویدیا فریمورک Physis-Lang رو معرفی کرده که با افزودن استدلالهای فیزیکی به توضیحات ویدیو، سوتیهای معروفی مثل ذوب شدن کره رو به بالا یا رد شدن اجسام از دل هم رو کاملاً برطرف میکنه.
- این نوآوری حتی بدون تغییر وزنهای مدل و صرفاً با غنیسازی پرامپتها، جهش ۵.۶۲ امتیازی ایجاد کرده و در مدل Cosmos 3 Nano موفق شده مدل مشهور Veo 3.1 گوگل رو شکست بده.
- سیستم با داشتن یک هوش مصنوعی منتقد، خطاهای ویدیویی رو شناسایی میکنه و با یک چرخه بازخورد هوشمند، فیزیک پدیدههای دشواری مثل گرما، تغییر فاز و تغییر شکل اجسام رو ارتقا میده.
آموزش قوانین فیزیک به مدلهای ویدیویی با کپشنهای هوشمند Physis-Lang انویدیا
محققان شرکت انویدیا (NVIDIA) بهتازگی از یک فریمورک متنباز به نام Physis-Lang رونمایی کردهاند که توضیحات و مفاهیم فیزیکی را وارد کپشنها و پرامپتهای مدلهای هوش مصنوعی تولید ویدیو میکند. این دستاورد مستقیماً روی یکی از باگها و نقطهضعفهای همیشگی ویدیوهای هوش مصنوعی دست گذاشته است؛ جایی که حتی در طبیعیترین فریمها هم ممکن است کرهای را ببینید که خلاف جهت جاذبه به سمت بالا ذوب میشود، اجسام جامد از دل هم رد میشوند یا پارچهها طوری حرکت میکنند که گویی هیچ وزن، اصطکاک و کششی ندارند.
بهطور سنتی، کپشنهای آموزشی تنها اشیا، اعمال و تغییرات زمانی را برای مدل توصیف میکنند؛ اما Physis-Lang این نظارت را با افزودن «علت»، «قوانین حاکم فیزیکی» و «معلول» حسابی ارتقا میدهد. برای نمونه، در صحنه ذوب شدن کره، کپشن جدید بهدقت توضیح میدهد که چگونه گرما دما را بالا میبرد، ماده دچار تغییر فاز میشود، نیروی گرانش توده نرمشده را شکل میدهد و در نهایت یک لایه مایع تشکیل میشود. این فریمورک از این ادبیات دقیق برای بازنویسی کپشن ویدیوهای آموزشی و همچنین بسط دادن پرامپتهای کاربران پیش از آغاز فرآیند تولید ویدیو استفاده میکند.
پرامپتهای دقیقتر، نمرات فیزیک هوش مصنوعی را بالا میبرند
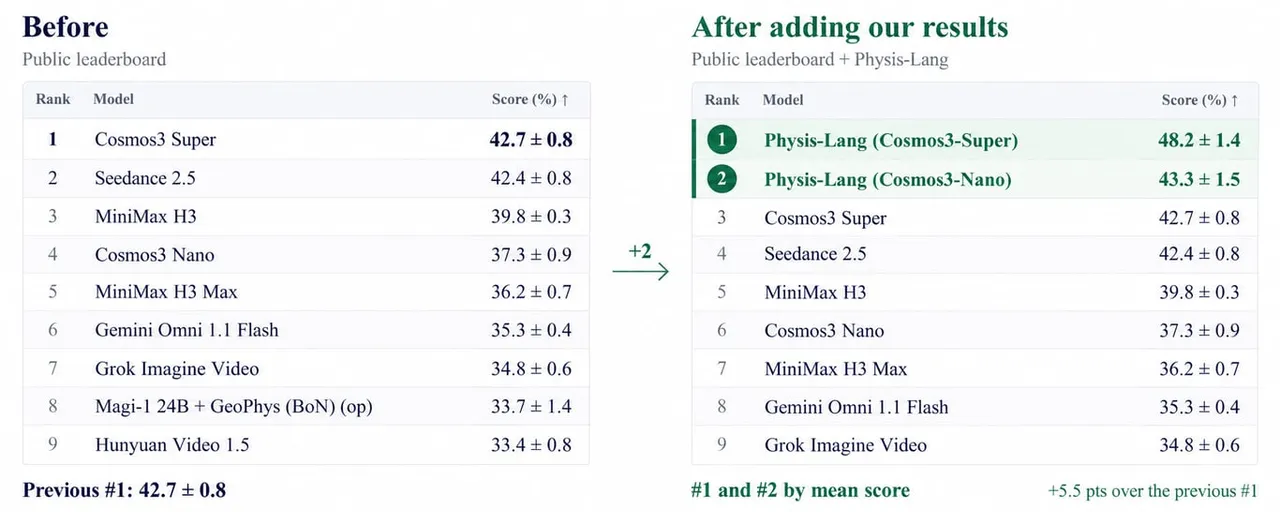
در بررسی بنچمارک معتبر Physics-IQ Verified، نسخههای ارتقایافته مدلهای Cosmos 3 Super و Cosmos 3 Nano با کمک Physis-Lang توانستهاند جایگاه اول و دوم جدول را تصاحب کنند. این بنچمارک با دقت میسنجد که ویدیوهای تولیدشده چقدر به رفتارهای فیزیکی دنیای واقعی وفادار ماندهاند.
پیکربندی | امتیاز |
|---|---|
ترکیب Physis-Lang با Cosmos 3 Super | ۴۸.۲٪ |
ترکیب Physis-Lang با Cosmos 3 Nano | ۴۳.۳٪ |
مدل پایه Cosmos 3 Super | ۴۲.۷٪ |
مدل Seedance 2.5 | ۴۲.۴٪ |
یک آزمایش جداگانه در زمان استنتاج (بدون آموزش مجدد مدل) تأثیر چشمگیر بسط پرامپت را اثبات کرده است. جالب اینجاست که تنها با افزودن استدلالهای فیزیکی به ورودی کاربر، امتیاز بنچمارک PhyGenBench در مدل Cosmos 3 به میزان ۵.۶۲ امتیاز رشد کرده است؛ آن هم با وزنهای کاملاً ثابت مدل و بدون نیاز به آموزش اضافی. از آنجا که این روش تنها متن ورودی فرستادهشده به مدل ویدیوساز را دگرگون میکند، میتوان آن را مستقیماً روی مدلها و چکپوینتهای موجود در بازار پیادهسازی کرد.
یک منتقد هوشمند قوانین کپشننویسی را بازنویسی میکند
این فریمورک یک زبان واحد و ساختاریافته فیزیکی را در سه مرحله متوالی به اشتراک میگذارد تا از طریق بازخورد هوش مصنوعی منتقد و تحلیل خطاها، متنهای بهکاررفته در آموزش و تولید ویدیو مدام بهبود پیدا کنند:
- بهینهسازی زبان توصیف: یک منتقد آگاه به فیزیک تکتک کپشنها را زیر ذرهبین میگذارد تا ادعاهای مفقود یا گزارههایی را که در ویدیو دیده نمیشوند شناسایی کند. سپس یک ایجنت هوشمند دستورالعملهای کپشننویسی را بهروزرسانی میکند، در حالی که مدل کپشننویس در طول این فرآیند دستنخورده و ثابت میماند.
- شناسایی و بازیابی پدیدههای ضعیف: ویدیوهایی که مدل در تولید آنها ناموفق بوده، به کوئریهای جستجو تبدیل میشوند. سپس سیستم بازیابی مبتنی بر زبان، ویدیوهای متفاوتی را که دقیقا شامل همان پدیدههای فیزیکی چالشبرانگیز هستند، برای آموزش گلچین میکند.
- آموزش و تولید: دستورالعملهای بازبینیشده دادههای آموزشی را بازنویسی کرده و پرامپتهای استنتاج را بسط میدهند. همچنین توصیفهای منفی اختصاصی برای هر صحنه، رفتارهای غیرواقعی فیزیک را مشخص میکنند تا ژنراتور مدل جلوی ایجاد آنها را بگیرد.
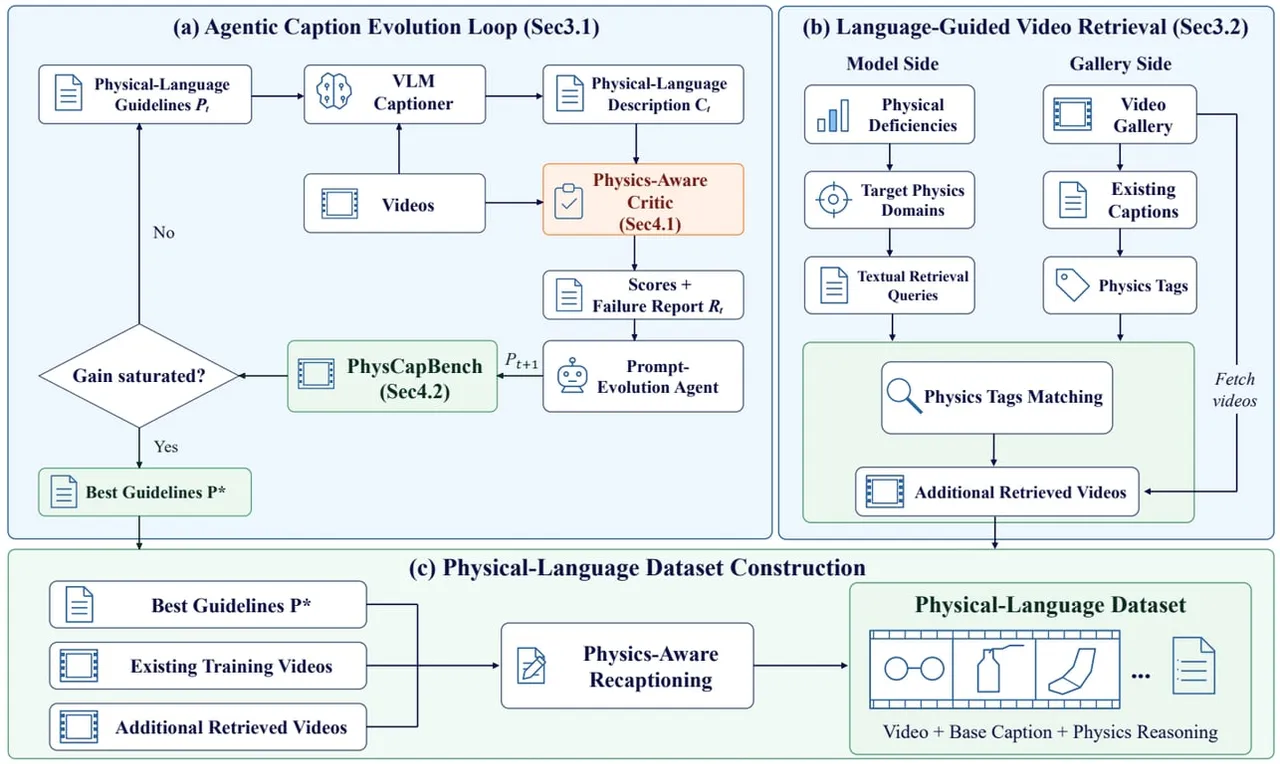
بنچمارک PhysCapBench بررسی میکند که آیا کیفیت کپشنها مستقل از فرآیند تولید ویدیو ارتقا یافته است یا خیر. این ارزیابی شامل ۲۴۶ ویدیوی بازبینیشده و ۳۷۹۴ گزاره فیزیکی تأییدشده توسط انسان است که به طور میانگین به ۱۵.۴ گزاره برای هر ویدیو میرسد. ارزیابها هر کپشن تولیدشده را به ادعاهای جزئی تفکیک میکنند، این ادعاها را با ویدیوی اصلی تطبیق میدهند و سپس معیارهای دقت (Precision)، فراخوانی (Recall) و نمره متوازن F1 را محاسبه میکنند.
معیار | امتیاز اولیه | امتیاز نهایی |
|---|---|---|
امتیاز F1 کپشن در PhysCapBench | ۷۸.۶۴ | ۸۷.۸۲ |
امتیاز نهایی در PhyGenBench | ۶۴.۱۷ | ۶۷.۲۹ |
خطاها کلیپهای آموزشی بعدی را تعیین میکنند
در آزمون دشوار VideoPhy-2 Hard، فرآیند بازیابی هدفمند توانست نمرات ترکیبی را در هر هشت دستهبندی مورد ارزیابی ارتقا دهد. میزان این رشد چشمگیر از ۱.۲۳ امتیاز در حوزه خاصیت کشسانی و الاستیسیته آغاز شده و تا ۸.۰۰ امتیاز در فرآیندهای حرارتی و شیمیایی افزایش یافته است.
دستهبندی | میزان رشد نمره ترکیبی |
|---|---|
فرآیندهای حرارتی | +۸.۰۰ |
فرآیندهای شیمیایی | +۸.۰۰ |
مکانیک شکست و ترک | +۷.۴۵ |
حرکت اجسام انعطافپذیر (Soft-body) | +۷.۴۱ |
تغییر شکل پارچه | +۷.۱۹ |
حرکت اجسام صلب (Rigid-body) | +۶.۰۶ |
برخورد و اصطکاک | +۳.۴۵ |
الاستیسیته و کشسانی | +۱.۲۳ |
بیشترین میزان جهش در فرآیندهایی رخ داده که توسط متغیرهای پنهان و نامرئی هدایت میشوند؛ متغیرهایی مانند دما، فاز ماده یا ترکیبات شیمیایی. توصیفهای دقیق علت و معلولی سیگنالهای هدایتکنندهای را فراهم میکنند که حتی پیشرفتهترین فریمها نیز به تنهایی قادر به نشان دادن مستقیم آنها نیستند.
موفقیت روی معماریها و مدلهای مختلف
بر اساس جدول پنجم مقاله منتشرشده، این متد روی تمام معماریهای آزمایششده—از مدلهای کوچک ۴ میلیارد پارامتری گرفته تا غولهای ۶۴ میلیارد پارامتری—رشد کاملاً مثبتی را به ثبت رسانده است.
مدل پایه (Backbone) | تعداد پارامترها | میانگین رشد امتیاز |
|---|---|---|
مدل Wan 2.1 | ۱۴ میلیارد | +۷.۰۵ |
مدل Cosmos 3 Edge | ۴ میلیارد | +۳.۲۴ |
مدل Cosmos 3 Nano | ۱۶ میلیارد | +۶.۲۲ |
مدل Cosmos 3 Super | ۶۴ میلیارد | +۵.۰۲ |
نکته شگفتانگیز اینجاست که ترکیب Physis-Lang با مدل ۱۶ میلیارد پارامتری Cosmos 3 Nano توانسته در بنچمارک PhyGenBench حتی از مدل قدرتمند Veo 3.1 گوگل هم جلو بزند، هرچند در آزمون جامع VideoPhy-2 All فاصلهای بسیار اندک با آن دارد.
سیستم | PhyGenBench | VideoPhy-2 Hard |
|---|---|---|
مدل Cosmos 3 Nano با فریمورک Physis-Lang | ۷۱.۰۴ | ۶۲.۳۶ |
مدل Veo 3.1 گوگل | ۶۵.۶۳ | ۵۸.۴۳ |
مرزها و محدودیتهای بنچمارکها
افزایش ۵.۶۲ امتیازی نشاندهنده قدرت جادویی بسط پرامپت با وزنهای ثابت مدل است. البته خط لوله کامل Physis-Lang از دادههای بازکپشنشده و بازیابی مبتنی بر شکست نیز بهره میبرد؛ بنابراین دستاوردهای نهایی حاصل ترکیب پالایش زبانی، انتخاب هوشمندانه داده، آموزش مدل و پرامپتنویسی دقیق در لحظه استنتاج است.
با تمام این پیشرفتها، باید واقعبین بود؛ شواهد کمّی به پدیدههای منتخب بنچمارکها محدود است و بالاترین امتیاز بنچمارک Physics-IQ Verified هنوز روی ۴۸.۲ درصد ایستاده است. شبیهسازی همهجانبه فیزیک، حفظ ثبات در ویدیوهای طولانیمدت و نحوه عملکرد مدل در برابر قوانین فیزیکی نادیدهگرفتهشده، همچنان سوالاتی بزرگ و بیپاسخ هستند و نیازمند بررسیهای انسانی و آزمایش روی پدیدههای پیچیدهتر خواهند بود.
کپشنها؛ اهرم جدید کنترل در دستان توسعهدهندگان
کپشنهای آگاه به قوانین فیزیک، راهکاری مستقل از مدل در اختیار توسعهدهندگان میگذارند تا ساختار علّی و معلولی را به هوش مصنوعی تزریق کنند. کپشنی که نیروها، تغییرات حالت ماده و پیامدهای مورد انتظار را نام میبرد، راهنمایی زمانی بسیار عمیقتری نسبت به توصیف ظاهری اشیا و حرکات سطحی ارائه میدهد. این رویکرد مستقیماً روی لایه داده و پرامپت مینشیند و به همین دلیل میتوان از آن روی مدلهای فعلی بدون دردسر استفاده کرد.
توسعهدهندگان میتوانند کار را خیلی ساده و با بسط پرامپت در زمان استنتاج شروع کنند: یک ساختار علت و معلولی مشخص تعریف کنید، پرامپتهای ورودی را غنیتر سازید، مدل اصلی را دستنخورده نگه دارید و عملکرد آن را بسنجید. برای پیادهسازی عمیقتر در فاز آموزش نیز میتوان بازکپشننویسی با نظارت منتقد و بازیابی موارد شکست را برای آموزش مدل به کار گرفت. همین جریان کاری جذاب را میتوان در سایر سیستمهای هوش مصنوعی مولد که متکی به توصیف صحنهها هستند نیز پیاده کرد.
جزئیات کامل فریمورک، تعریف بنچمارکها، نتایج آزمایشها و گالری ویدیوهای خیرهکننده شامل پدیدههایی مثل برخوردها، پاره شدن اجسام، خیس شدن سطوح و تغییر شکل تحت فشار، در صفحه رسمی پروژه و مقاله انویدیا در دسترس علاقهمندان قرار گرفته است.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
آپدیت هیجانانگیز ویرایشگر Zed: انتخاب مدل هوش مصنوعی برای هر سابایجنت حین کدنویسی!
ویرایشگر محبوب Zed در نسخه ۱.۲۲ سیستم چندایجنت (Multi-Agent) خود را به سطحی کاملاً تازه برده است. در این بهروزرسانی، ایجنت اصلی میتواند به دلخواه خود برای هر سابایجنت یک مدل مجزا تعیین کند تا هزینه و سرعت توسعه به شکل چشمگیری بهینهسازی شود. همچنین با اضافه شدن فشردهسازی خودکار کانتکست، پردازش وظایف طولانی و پیچیده بدون وقفه انجام خواهد شد.
درگاه Monid متنباز شد؛ دسترسی ایجنتهای هوش مصنوعی به بیش از ۲۰۰۰ ابزار فقط با یک API
پلتفرم Monid درگاه یکپارچه ابزارهای هوش مصنوعی خود را در گیتهاب متنباز کرد تا ایجنتها بتوانند تنها با یک کلید API به بیش از ۲۰۰۰ ابزار کاربردی از ۷۲ ارائهدهنده متصل شوند. این پروژه همانند پلتفرم OpenRouter عمل میکند، با این تفاوت که به جای مدلهای زبانی، دسترسی ایجنتها به ابزارهای وب، منابع داده و سرویسهای تولید محتوا را در قالب یک درگاه واحد مدیریت میکند.
ترفند ۳.۹ میلیارد دلاری متا؛ تبدیل دیتاسنترهای هوش مصنوعی به تخفیف مالیاتی نجومی!
شرکت متا با یک ترفند حسابداری زیرکانه و ثبت رکهای سرور هوش مصنوعی به عنوان «تجهیزات آزمایشی»، توانسته معافیت مالیاتی پژوهشی خود را به رقم سرسامآور ۳.۹ میلیارد دلار برساند. کارشناسان مالیاتی این اقدام را از نظر قانونی بسیار پرریسک و مشکوک میدانند، اما در صورت تأیید، راه برای معافیتهای مالیاتی نجومی سایر غولهای هوش مصنوعی نیز هموار خواهد شد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.