سیستم Dream-RSI شرکت Google فراخوانی ایجنتهای اکتشافی را با بازپخش جستجوهای قبلی تا ۱۶۲ برابر کاهش میدهد
تیمهای هوش مصنوعی چگونه هزینههای ایجنتها را کاهش میدهند؟ سیستم جدید Dream-RSI شرکت Google با بررسی تاریخچه جستجوهای ذخیرهشده برای آزمایش استراتژیهای جدید، نیاز به فراخوانی ایجنتهای اکتشافی را تا ۱۶۲ برابر کمتر میکند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- سیستم Dream-RSI شرکت Google با استفاده از بازپخش تاریخچه جستجوهای قبلی، نیاز به فراخوانی مکرر ایجنتهای اکتشافی را بهشدت کاهش میدهد.
- این رویکرد به مدلها اجازه میدهد بدون اجرای مجدد جستجوهای پرهزینه در محیط آنلاین، استراتژیهای جدید را آزمایش کرده و فراخوانیها را تا ۱۶۲ برابر کمتر کنند.
- دستاورد جدید Google میتواند هزینههای محاسباتی تیمهای توسعهدهنده هوش مصنوعی را در حلقههای اکتشافی و فرایندهای بهبود خودکار بازگشتی (RSI) به شکل چشمگیری بهینهسازی کند.
تیمهای توسعهدهنده برای بهبود حلقههای اکتشافی خود همچنان دهها هزار توکن و فراخوانی ایجنت را مصرف میکنند. به گفته پژوهشگران Google، بخش عمدهای از این هزینه صرف مسیرهایی میشود که پیش از این با شکست مواجه شدهاند. راهکار آنها این است که به جای تکرار این مسیرها، به ایجنتها اجازه دهند تا در این حلقهها «رؤیاپردازی» کنند و با یادگیری از تلاشهای قبلی، جستجوهای آینده را هدایت کنند. این سیستم که Dream-RSI نام دارد، در آزمایشها توانست تا ۱۶۲ برابر کمتر از سیستم اکتشافی موجود یعنی SimpleTES به فراخوانی ایجنتهای اکتشافی نیاز داشته باشد.
این سیستم بر پایه یک لایه هماهنگکننده سبک ساخته شده است که انشعابها، اکتشافات موازی و تصمیمگیری برای توقف را بدون تغییر در ایجنت کدنویسی پایه کنترل میکند. روند اکتشاف در این مدل «صریح و قابلبرنامهریزی» است و سیستم بدون نیاز به اجرای مجدد و پرهزینه آنلاین، سیاستهای خود را ارزیابی و اصلاح میکند.
سیستم Dream-RSI در چندین حوزه مختلف توانست ضمن کاهش چشمگیر هزینههای محاسباتی، کیفیت اکتشاف را حفظ کرده یا حتی بهبود بخشد.
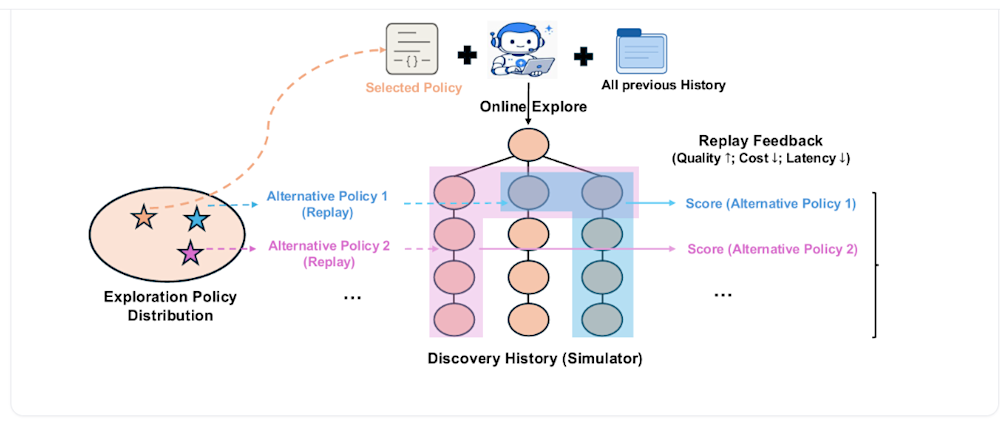
پژوهشگران در این باره توضیح میدهند: «از آنجا که تمام نتایج اجراها پیشتر در ساختار درختی سیستم ذخیره شدهاند، ارزیابی یک استراتژی جدید تنها به خواندن سوابق گذشته نیاز دارد و هیچ نیازی به اجرای مجدد ایجنت اکتشافی پایه یا ارزیاب نیست.»
این پژوهش تنها چند روز پس از انتشار مقاله «ما باید سرعت مرزها را کنترل کنیم» به قلم داریو آمودی (Dario Amodei) منتشر شده است. همبنیانگذار Anthropic از مفهوم بهبود خودکار بازگشتی (RSI) به عنوان یکی از دو پیشرفتی یاد کرد که نظر او را درباره لزوم کند کردن روند توسعه هوش مصنوعی تغییر داده است، چرا که این فناوری میتواند به سیستمهایی منجر شود که کنترل آنها از توان انسان خارج است.
اما این آزمایش جدید، بر اساس نتایج بنچمارکها، شکاف میان تهدیدات وجودی که آمودی و دیگران درباره آن هشدار میدهند و کاربردهای محدودتر و عملگرایانه حلقههای اکتشافی ایجنتها را برجسته میکند.
ساخت «درختهای اکتشاف تاریخی»
مفهوم RSI کاملاً به اکتشاف مؤثر وابسته است؛ اینکه کجا و چه زمانی انشعاب ایجاد شود، به صورت موازی اجرا گردد یا یک مسیر متوقف شود. اما با گسترش حلقههای اکتشافی به هزاران چرخه، مدیریت این فرایند میتواند چالشبرانگیز باشد. پژوهشگران مینویسند که روند اکتشاف هنوز «دستی و ثابت» است و یک استراتژی مشخص از تجربیات انباشتهشده درس نمیگیرد، بنابراین توسعهدهندگان مدام برای مسیرهایی که پیشتر شکست خوردهاند، هزینه میپردازند.
آنها خاطرنشان میکنند: «اکتشاف ضعیف میتواند محاسبات و زمان قابلتوجهی را هدر دهد و کارایی و مقیاسپذیری RSI را بهشدت محدود کند.» گلوگاه اصلی این فرایند، «بازخورد در سطح متا» است، زیرا با تأخیر همراه بوده، پرهزینه است و در نهایت ضرورتی ندارد. در واقع، توسعهدهندگان در حال تولید مجدد بازخوردهایی هستند که قبلاً هزینه آنها را پرداختهاند.
این تیم تحقیقاتی متشکل از ۱۷ پژوهشگر از Google، Google DeepMind و دانشگاههای مریلند و ویرجینیا، استدلال میکنند که روند اکتشاف باید به صورت یک «درخت اکتشاف تاریخی» ساختاریافته ارائه شود که شامل تمام تصمیمات ایجنت و نتایج آنها باشد. این رویکرد به مدل توانایی میدهد تا بدون نیاز به اجرای مجدد هیچ فرایندی، مسیر بعدی خود را انتخاب کند.
پژوهشگران مینویسند: «سیستم همان درخت ثبتشده را با ترتیبی متفاوت طی میکند و هر نتیجهای که درخواست میکند، از پیش روی دیسک ذخیره شده است.» این معماری میتواند هزاران کشف گذشته را بدون اجرای اضافی بررسی کرده و بهترین گزینه را برای پیادهسازی نهایی انتخاب کند. در عمل، این فرایند یک «شبیهساز بازپخش» بر اساس تاریخچه جستجوهای انباشتهشده قبلی ایجاد میکند.
نکته مهم این است که سیاست اکتشافی تنظیمشده توسط انسان تعیین میکند که یک ایجنت کجا را جستجو کند، کدام تلاشها باید به صورت موازی اجرا شوند و چه زمانی فرایند اکتشاف باید متوقف شود.
عملکرد Dream-RSI در سه مرحله انجام میشود: «اکتشاف آنلاین» که در آن سیاستها یک ایجنت را برای ساخت درخت اکتشاف و ثبت سوابق تاریخی هدایت میکنند؛ «ساخت شبیهساز بازپخش» که در آن درخت و سوابق آن به یک مخزن قابلاستفاده مجدد اضافه میشوند؛ و «بهبود سیاست مبتنی بر رؤیاپردازی» که در آن ایجنت اساساً سیاستهای جایگزین را در ذهن خود شبیهسازی میکند.
ایجنت پس از اکتشاف، در صورت نیاز درخت خود را گسترش میدهد، سیاستها را بازنویسی میکند، به هر نسخه امتیاز میدهد و سپس بهترین گزینه را مستقر میسازد. هر چرخه در واقع «یک دنیای جدید اضافه میکند» و سیاستهای برنده برای ایجاد یک درخت اکتشافی جدید دوباره آنلاین میشوند.
پژوهشگران توضیح میدهند: «این تاریخچه همیشه در آنجا وجود داشته است؛ اما در کارهای قبلی به چشم دیگری دیده میشد، یعنی صرفاً به عنوان یک بستر متنی ثابت برای پرامپتها یا دادههای آموزشی برای تنظیم دقیق وزنهای شبکه.»
نویسندگان مقاله استدلال میکنند: «تاریخچه، دنیایی برای رؤیاپردازی است. درخت اکتشافی که ایجنت از پیش ساخته، یک شبیهساز دقیق از فضای جستجویی است که به آن دست یافته است.» این مدل از طریق رؤیاپردازی بهبود مییابد و به جای تجربه مکرر شرایط، یک سیاست اکتشافی جدید را با «تصور کردن» آن آزمایش میکند.
آنها مینویسند: «شبیهساز هر چیزی است که بتواند بدون نیاز به اجرای واقعی جهان، به سؤال 'چه میشد اگر...' پاسخ دهد.»
عملکرد Dream-RSI در بنچمارکهای کلیدی
در طیف وسیعی از وظایف الگوریتمی، هسته پردازنده گرافیکی (GPU-kernel) و بهینهسازی ریاضی در دورههای متوالی اکتشاف، پژوهشگران دریافتند که سیاست اکتشافی آموزشدیده در Dream-RSI میزان استفاده از منابع محاسباتی را تطبیق داده و نتایج بهتری را با فراخوانی ایجنت کمتری نسبت به رویکردهای موجود ارائه میدهد.
در تستهای اکتشافی Lasso، جایی که به ایجنتها یک مسئله کدنویسی و بهینهسازی داده میشود، سیستم Dream-RSI تعادل بهتری میان کیفیت و توان محاسباتی در مقایسه با «اکتشاف ثابت بازگشتی» (RFE) ارائه داد. رویکرد RFE زمانی رخ میدهد که یک ایجنت هوش مصنوعی فضای جستجو را به جای تطبیق در طول زمان، با استفاده از یک هماهنگکننده ثابت کاوش کند.
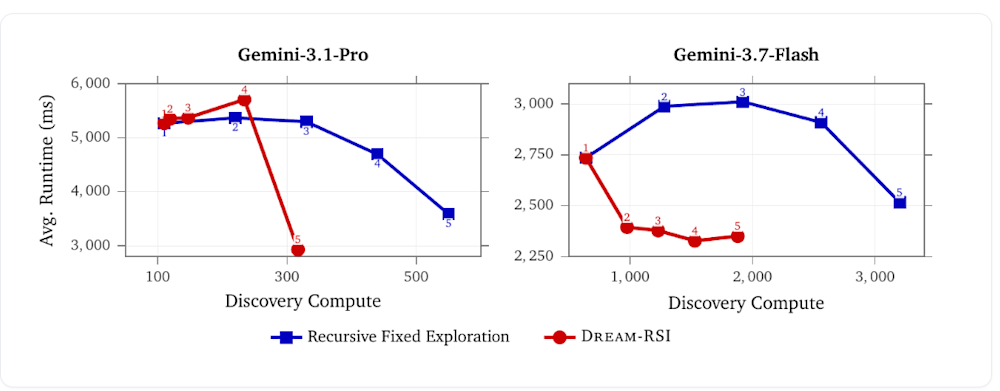
با استفاده از مدل Gemini-3.1-Pro، سیستم Dream-RSI میانگین زمان اجرا در ۶ مجموعه داده را از ۳۵۸۷٫۱ به ۲۹۳۱٫۰ میلیثانیه کاهش داد و فراخوانی ایجنتهای اکتشافی را از ۵۵۰ به ۳۱۷ مورد رساند. همچنین با مدل Gemini-3.7-Flash، میانگین زمان اجرا از ۲۵۱۶٫۷ به ۲۳۵۰٫۶ میلیثانیه و تعداد فراخوانیها از ۳۲۰۰ به ۱۸۷۹ رسید. در مقایسه، سیستم SimpleTES که معیار ثبت رقم چشمگیر کاهش ۱۶۲ برابری بود، از یک مدل پایه متفاوت به نام gpt-oss-120b در ۵۱٬۲۰۰ نسل استفاده کرد.
پژوهشگران عملکرد Dream-RSI را در حوزه مهندسی هسته GPU نیز ارزیابی کردند؛ حوزهای که ایجنتها وظیفه دارند پیادهسازیهای با کارایی بالا را بدون از بین بردن صحت محاسبات عددی کشف کنند. این کار نیازمند استدلال همزمان پیرامون دسترسی به حافظه، موازیسازی، الگوریتمها و بهینهسازیهای خاص سختافزار است. همین موضوع این بنچمارک را به گزینهای مناسب برای اثبات توانایی Dream-RSI در تعمیم فراتر از اکتشافات صرفاً ریاضی تبدیل میکند.
در وظیفه ConvDiv برای هسته GPU، که میزان کارایی اجرای بارهای کاری سطح سختافزار یادگیری ماشین روی کارت گرافیک را ارزیابی میکند، عملکرد Dream-RSI بهطور متوالی بهبود یافت و تلاشهای ارزیابیشده را پیش از هزینهکرد مجدد، از ۱۱۰ به ۵۰ مورد کاهش داد؛ فرایندی که تا رسیدن به حدود عدد ۹۰ و توقف پیشرفت ادامه داشت.
در وظایف برنامهنویسی پردازندههای گرافیکی مانند VGG16 و LayerNorm، سیستم Dream-RSI با استفاده از نسلهای کمتر (به ترتیب ۲٫۴۳ و ۱٫۷۹ برابر کمتر) به عملکرد مشابهی دست یافت. در تسکهای ConvDiv و ConvMax نیز با بودجه محاسباتی قابل مقایسه، عملکردی ۲٫۰۹ و ۱٫۴۴ برابر بالاتر را به ثبت رساند.
پژوهشگران در پایان مینویسند: «رؤیاپردازی درون شبیهساز بازپخش که از روی درختهای اکتشافی تاریخی ساخته شده است، بازخورد فوری و کمهزینهای را برای ارزیابی و اصلاح سیاستهای اکتشافی فراهم میکند؛ آن هم بدون نیاز به تکرار ارزیابیهای پرهزینه آنلاین.» برای تیمهایی که هماکنون در حال مصرف فراوان فراخوانیهای ایجنت هستند، این دستاورد بر پایه سوابقی استوار است که پیش از این برای تولید آنها هزینه کردهاند؛ علاوه بر این، کدهای این سیستم نیز به صورت عمومی در دسترس قرار گرفته است.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی

رکورد ۸۳۳ هزار دانلود ماهانه برای LEGAL-BERT؛ وقتی توسعهدهندهها قید مدلهای گرانقیمت را میزنند!
مدل زبانی تخصصی LEGAL-BERT با ثبت بیش از ۸۳۳ هزار دانلود در ماه روی پلتفرم هاگینگ فیس حسابی خبرساز شده است. این ابزار جمعوجور و تخصصی نشان میدهد که برای پردازش و تحلیل متون حقوقی، حتماً نیازی به مدلهای غولپیکر و پرهزینه ندارید و گزینههای بهینه همچنان در اوج هستند.

جاسوسی هوش مصنوعی در محل کار؛ کارمندان میگویند کارفرماها باید قانوناً مچگیریهایشان را لو بدهند!
نظرسنجیهای تازه نشان میدهد که بیشتر کارمندان حس میکنند مدیرانشان با ابزارهای هوش مصنوعی تمام حرکات آنها را زیر نظر گرفتهاند. حالا بیش از ۸۰ درصد شاغلان خواستار تصویب قانونی شدهاند که شرکتها را مجبور کند هرگونه مچگیری و نظارت هوش مصنوعی در محیط کار را رسماً اعلام کنند.

گزارش داغ مایکروسافت از نفوذ جهانی هوش مصنوعی؛ امارات در صدر و رتبه عجیب آمریکا!
مایکروسافت در تازهترین گزارش خود از ضریب نفوذ هوش مصنوعی در جهان پرده برداشت؛ آماری شگفتانگیز که نشان میدهد امارات و سنگاپور با فاصلهای خیرهکننده پیشتاز دنیا هستند و در مقابل، آمریکا در رتبه ۲۱ جا مانده است. همچنین الگوی استفاده از هوش مصنوعی میان کشورهای غربی و کشورهای در حال توسعه، از تفاوتی عمیق میان کاربردهای روزمره و آموزش پرده برمیدارد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.