فریمورک متنباز EnvHarness گوگل؛ تحولی در آموزش ایجنتهای هوش مصنوعی با محیطهای پویا
گوگل از فریمورک جدیدی رونمایی کرده است که به جای ساخت مداوم شبیهسازهای جدید، محیطهای آموزشی را بهطور پویا بر اساس نقاط ضعف فعلی ایجنتهای هوشمند تغییر شکل میدهد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- گوگل فریمورک متنباز EnvHarness را برای تطبیقپذیری محیطهای آموزشی با نقاط ضعف ایجنتهای هوش مصنوعی معرفی کرد.
- این فریمورک بدون دستکاری شبیهساز اصلی، شرایط تعامل ایجنت با محیط را تغییر میدهد تا مهارتهای آن را در مواجهه با چالشهای جدید بسنجد.
- توسعهدهندگان و تیمهای سازمانی میتوانند با استفاده از این ابزار، هزینهها و زمان ساخت محیطهای آموزشی جدید را بهطور چشمگیری کاهش دهند.
آموزش ایجنتها برای وظایف خاصی مانند کدنویسی یا ناوبری وب نیازمند محیطهایی است که در آنها بتوانند با خیال راحت تمرین کنند، شکست بخورند و عملکرد خود را بهبود بخشند. اما ساخت این محیطها پرهزینه است و پس از ایجاد، معمولاً حتی با وجود پیشرفت ایجنت، بدون تغییر و ثابت باقی میمانند.
پژوهشگران مرکز تحقیقات هوش مصنوعی Google Cloud به همراه شرکای دانشگاهی خود، یک فریمورک متنباز (با مجوز Apache 2.0) توسعه دادهاند که این محیطهای ایستا را به محیطهایی تبدیل میکند که میتوانند خود را با نقاط ضعف ایجنتِ در حال آموزش تطبیق دهند.
این فریمورک که EnvHarness نام دارد، یک لایه برنامهپذیر در اطراف محیط موجود قرار میدهد. این لایه میتواند نقطه شروع ایجنت، آنچه را که میبیند، اقداماتی که میتواند انجام دهد و مدت زمان انجام یک کار را تغییر دهد، در حالی که محیط پایه و سیستم اعتبارسنجی آن دستنخورده باقی میماند.
در پنج بنچمارک مختلف شامل مهندسی نرمافزار، ناوبری وب، کارهای اداری و وظایف تجسمیافته، ایجنتهایی که از محیطهای EnvHarness یاد میگرفتند، در وظایف آزمایشنشده تا ۹ امتیاز بهبود یافتند. در بنچمارکهای مهندسی نرمافزار، آنها همچنین توانستند وظایف را در مراحل کمتری نسبت به ایجنتهای آموزشدیده در محیطهای اصلی به پایان برسانند.
برای تیمهای سازمانی فعال در حوزه هوش مصنوعی، این رویکرد جایگزینی برای ساخت مداوم شبیهسازها و وظایف آموزشی جدید از پایه است: کار با یک محیط قابلاعتماد آغاز میشود و سپس بهطور پویا پیرامون نقاط ضعف فعلی ایجنت تغییر شکل مییابد.
چرا محیطهای آموزشی ثابت به یک گلوگاه تبدیل میشوند؟
ایجنتها از طریق تعامل با محیطها یاد میگیرند. برای یک ایجنت کدنویس، محیط ممکن است شامل یک مخزن، پوسته (shell) و مجموعه تست باشد. یک ایجنت مرورگر ممکن است روی یک وبسایت کار کند و یک ایجنت اتوماسیون سازمانی میتواند در یک نسخه ایزولهشده از یک برنامه داخلی فعالیت داشته باشد.
محیط، وظیفه را ارائه میدهد، وضعیت آن را حفظ میکند، به اقدامات ایجنت پاسخ میدهد و موفقیتآمیز بودن آن را تعیین میکند. ساخت تمام این موارد نیازمند کار مهندسی است، بهویژه زمانی که محیط به یک اعتبارسنج قابلاعتماد نیاز دارد تا مشخص کند آیا ایجنت کار را بهدرستی انجام داده است یا خیر.
مشکل اینجاست که بیشتر محیطها پس از ساخته شدن، ثابت باقی میمانند و بر اساس ایجنتی که از آنها استفاده میکند، تغییری نمیکنند. اگر یک ایجنت به دلیل عدم بررسی تستها پیش از ویرایش کد بهطور مداوم شکست بخورد، محیط بهطور خودکار موقعیتهایی را ایجاد نمیکند که ایجنت را مجبور به تمرین آن مهارت کند. و هنگامی که ایجنت وظایف موجود را یاد میگیرد، شبیهساز کارایی خود را از دست میدهد و احتمال اینکه باعث پیشرفت بیشتر ایجنت شود، کاهش مییابد.
با پیشرفت ایجنت، یافتن موارد حاشیهای (edge cases) مفید نیز دشوارتر میشود. زیفنگ وانگ (Zifeng Wang)، دانشمند پژوهشی در Google و یکی از نویسندگان این مقاله در این باره میگوید: «با بهبود ایجنت، محیطهای واقعاً چالشبرانگیز میتوانند در آن فضای ثابت بسیار نادر شوند، بنابراین تیمها باید نمونههای به مراتب بیشتری از محیطها را بررسی کنند تا موارد حاشیهای معناداری بیابند.»
یک راهحل برای این مشکل، تولید محیطهای بیشتر با استفاده از هوش مصنوعی است.
به عنوان مثال، GenEnv فریمورکی است که از یک مدل زبانی (LLM) به عنوان شبیهسازی استفاده میکند که انتقالها، مشاهدات و سیگنالهای موفقیت را تولید میکند و در عین حال سعی دارد وظایف را در مرز تواناییهای ایجنت نگه دارد. تکنیک دیگر Agent-World است که بهطور برنامهریزیشده ابزارهای اجرایی، پایگاههای داده و وظایف را برای ساخت محیطهای جدید ترکیب میکند.
اما تولید محیط، مشکلات خاص خود را ایجاد میکند. این خطوط لوله معمولاً به دامنههای خاصی محدود میشوند و صحت محیطهای تولیدشده باید بررسی شود. یک LLM که به عنوان شبیهساز عمل میکند، ممکن است انتقالهای نادرست یا سیگنالهای بازخورد انحرافی تولید کند. از سوی دیگر، محیطهای اجرایی که از پایه ساخته شدهاند ممکن است دارای خطاهای منطقی باشند.
همچنین تولید محیطهای بیشتر لزوماً مشکل انطباقپذیری را حل نمیکند. به گفته وانگ، اگر این محیطها همچنان از یک توزیع ثابت به دست آیند، تیمها ممکن است در نهایت یک مجموعه ثابت را با مجموعه ثابت دیگری جایگزی�� کنند. با پیشرفت ایجنت، یافتن نمونههای آموزشی مفید دوباره دشوار میشود.
EnvHarness چگونه یک محیط را برنامهپذیر میکند؟
رویکرد EnvHarness متفاوت است. این فریمورک به جای تولید محیطهای جدید، نحوه ارائه یک محیط موجود به ایجنت را تغییر میدهد.
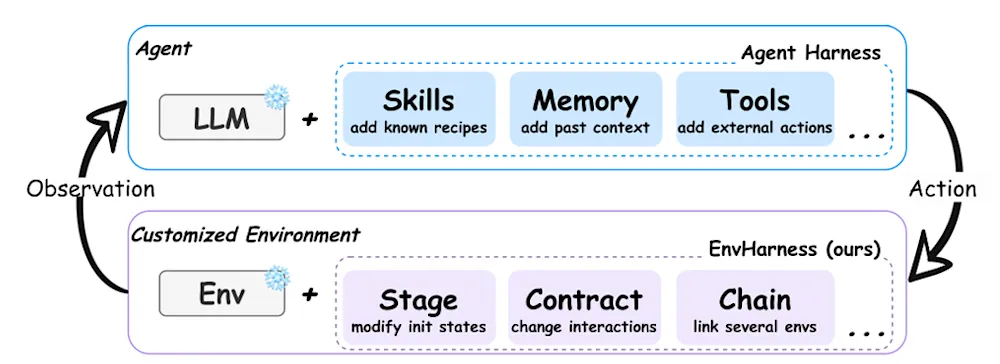
پژوهشگران این سیستم را با هارنس ایجنت (agent harness) مقایسه میکنند؛ لایه نرمافزاری که یک LLM را با ابزارها، حافظه، مدیریت زمینه و حلقههای اجرایی احاطه میکند.
به بیان ساده:
ایجنت = مدل + هارنس ایجنت
فریمورک EnvHarness همین ایده را در سمت دیگر تعامل پیادهسازی میکند:
محیط سفارشی = محیط ثابت + EnvHarness
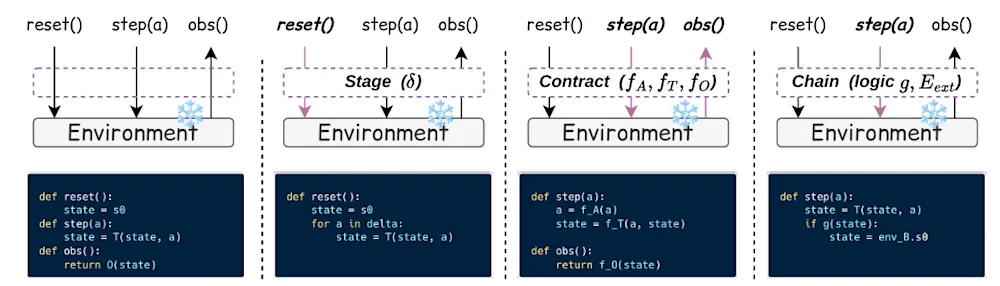
ایجنت همچنان از طریق همان رابط قبلی تعامل میکند. EnvHarness بین ایجنت و محیط قرار میگیرد و بدون تغییر در خود شبیهساز، تجربه آموزشی را تغییر شکل میدهد.
این فریمورک سه مؤلفه اصلی را ارائه میدهد.
یک مرحله (Stage) وضعیت شروع محیط را تغییر میدهد. برای مثال، یکی از وظایف در بنچمارک ALFWorld ایجاب میکند که ایجنت یک لیوان تمیز را روی میز قرار دهد. معمولاً لیوان از ابتدا در معرض دید قرار دارد. اما یک Stage میتواند ابتدا لیوان را داخل یک کشوی بسته قرار دهد که ایجنت را مجبور میکند قبل از تکمیل کار به جستجو بپردازد. یک Stage همچنین میتواند برعکس عمل کرده و بخش اولیه کار را از قبل تکمیل کند تا آموزش روی مرحله بعدی متمرکز شود.
یک قرارداد (Contract) خود تعامل را تغییر میدهد. این مؤلفه میتواند اقدامات را فیلتر کند، پاسخها را تغییر دهد یا آنچه را که ایجنت میبیند کنترل کند. در همان وظیفه قبلی، یک Contract میتواند توضیحات اتاق را تغییر داده و برخی جزئیات را حذف کند تا ایجنت مجبور شود اطلاعات را در طی چند مرحله جمعآوری کند، یا میانبرهای ناوبری را حذف کند تا مجبور شود اتاق به اتاق جستجو کند.
یک زنجیره (Chain) وظایف را به هم متصل میکند. برای مثال، پس از قرار دادن لیوان روی میز، ممکن است از ایجنت خواسته شود که یک سیبزمینی را گرم کرده و روی پیشخوان بگذارد. اکنون موفقیت نیازمند تکمیل هر دو وظیفه است و یک مسیر طولانیتر ایجاد میشود که در آن ایجنت باید اهداف خود را حفظ کرده و اقداماتش را بودجهبندی کند.
بخش دیگر این فریمورک، EnvRigger نام دارد که فرآیند تصمیمگیری درباره نحوه اصلاح محیط توسط EnvHarness بر اساس نقاط ضعف ایجنت را خودکار میکند.
سیستم EnvRigger از یک حلقه «مشاهده ➔ تشخیص ➔ نوشتن ➔ اعتبارسنجی» پیروی میکند. ابتدا، ایجنت را چندین بار اجرا کرده و مسیرهای موفق و ناموفق آن را برای یافتن الگوهای تکرارشونده شکست بررسی میکند. بر اساس یافتهها، مؤلفههای EnvHarness را برای افشا یا اصلاح شکستها ترکیب کرده و مسیرهای جدیدی را اجرا میکند تا بررسی کند آیا تغییرات آن یک نمونه آموزشی مفید و قابلحل ایجاد کرده است یا خیر.
وانگ مثال یک ایجنت کدنویس را میزند که از میانبرها استفاده کرده و بدون اجرای تستها، یک پچ را ارسال میکند. او در این باره توضیح میدهد: «وقتی سیستم متوجه میشود که ایجنت از یک میانبر اشتباه استفاده کرده است، مانند ارسال یک پچ کد بدون اجرای هیچ تستی، بهطور خودکار یک قانون پلاگین ایجاد میکند تا از آن ارسال زودهنگام جلوگیری کرده و یک هشدار برگرداند؛ به این ترتیب ایجنت مجبور میشود ابتدا مجموعه تست را بهدرستی اجرا کند.»
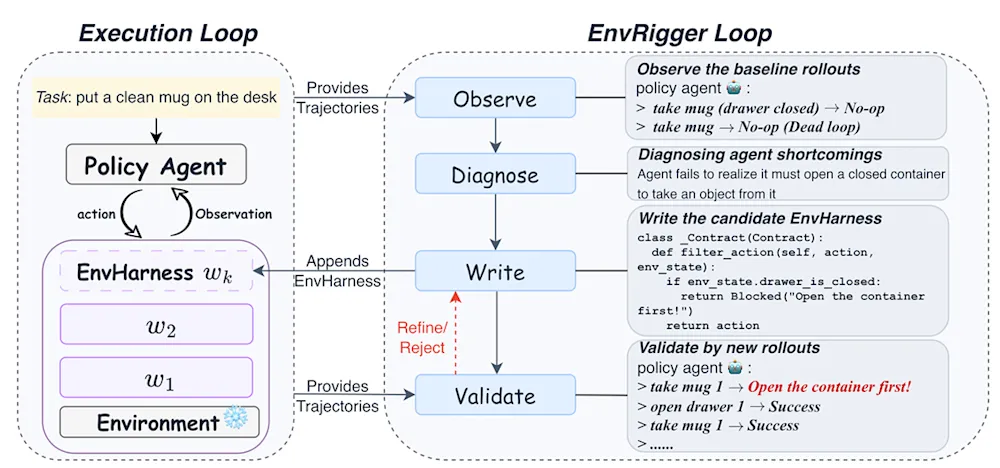
نکته مهم این است که پلاگین، شرایطی را که ایجنت تحت آن فعالیت میکند تغییر میدهد، نه وظیفه اصلی یا سیستم امتیازدهی آن را.
در این مثال، مخزن منبع و تستهای واحد نوشتهشده توسط انسان دستنخورده باقی میمانند. مؤلفه Contract از ارسال زودهنگام جلوگیری میکند، اما تستهای اصلی همچنان صحت پچ را تعیین میکنند. این کار باعث میشود اعتبارسنج مورد اعتماد حفظ شود در حالی که رفتار جدیدی برای تمرین به ایجنت داده شده است.
همچنین EnvRigger پیش از حفظ تغییرات، آنها را اعتبارسنجی میکند. در آزمایشهای این مقاله، چرخه پایه با پنج اجرای اولیه از وظیفه اصلی و پنج اجرای جدید از یک اصلاح پیشنهادی آغاز میشود. اگر تغییر پیشنهادی باعث غیرقابلحل شدن یا بیش از حد آسان شدن وظیفه شود، یا نتواند سیگنال مفیدی تولید کند، EnvRigger میتواند آن را بازبینی کرده و تا پنج دور نوشتن و اعتبارسنجی، مراحل را تکرار کند.
عملکرد EnvHarness در عمل
پژوهشگران EnvHarness را روی بنچمارکهای ALFWorld ،WebArena ،SWE-bench Verified ،OfficeQA و SpreadsheetBench آزمایش کردند.
در آزمایشهای اصلی، آنها مسیرهایی را از محیطها جمعآوری کرده و اسکیلهای قابل استفاده مجدد را از آنها استخراج کردند. اسکیلهای آموختهشده از محیطهای EnvHarness در تمامی پنج بنچمارک، عملکرد بهتری نسبت به محیطهای بدون تغییر داشتند.
در بنچمارک SWE-bench Verified، علاوه بر افزایش دقت، آموزش با EnvHarness منجر به کوتاه شدن میانگین مسیر از ۵۵٫۰۱ به ۴۹٫۶۱ مرحله شد.
فریمورک EnvHarness همچنین در مقایسه با سیستمهایی که بهطور خاص برای تولید محیطهای آموزشی ساخته شدهاند، عملکرد مطلوبی داشت. در SWE-bench Verified، این سیستم با ۲٫۴۶ درصد عملکرد بهتر از SWE-smith، به ۵٫۱۱ مرحله کمتر در هر اپیزود نیاز داشت. در بنچمارک ALFWorld نیز این فریمورک بهطور میانگین ۵٫۷ امتیاز بهتر از GenEnv عمل کرد.
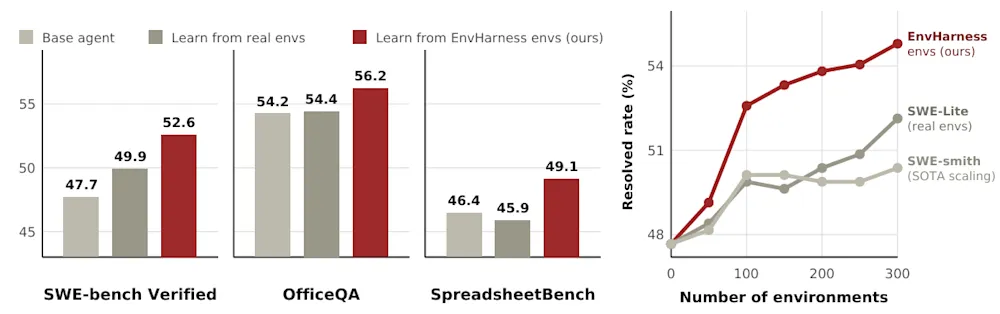
نتیجه جالبتر زمانی مشخص میشود که پژوهشگران حلقه انطباق را بهطور مکرر اجرا میکنند. هر دسته جدید از EnvHarness پس از یادگیری ایجنت از دستههای قبلی، برای آن طراحی میشود. به عنوان مثال، در محیط کدنویسی، دورهای اولیه مشکلات اساسی مانند اجرای تستها و ویرایش فایلها را آشکار میکنند. دورهای بعدی با نقاط ضعف متفاوتی روبرو میشوند، از جمله اجراکنندههای تست خراب، محدودیتهای منابع و یافتن مفسر صحیح پایتون.
آزمایشهای مقیاسپذیری گزارش منتشرشده، تأثیر این انطباق را نشان میدهند. در بنچمارک SWE-bench Verified، ایجنت پایه از ۴۷٫۶۷ درصد شروع کرد و با گسترش مجموعه آموزشی EnvHarness به ۳۰۰ محیط، به ۵۴٫۷۹ درصد رسید. یادگیری از همان تعداد محیطهای اصلی به ۵۲٫۱۳ درصد رسید، در حالی که محیطهای تولیدشده توسط SWE-smith عدد ۵۰٫۳۷ درصد را ثبت کردند. منحنیهای محیط اصلی و تولیدشده زودتر مسطح شدند، در حالی که EnvHarness به ایجاد محیطهای آموزشی پیرامون جدیدترین قابلیتهای ایجنت ادامه داد.
همین اصل فراتر از حوزه کدنویسی نیز صدق میکند. در WebArena، پژوهشگران نقطه ضعفی را مشخص کردند که در آن ایجنت بدون اسکرول کردن پاسخ میداد و اطلاعات بخشهای پایینتر صفحه را از دست میداد. EnvHarness یک Contract ایجاد کرد که از اقدامات بازیابی تا زمان اسکرول کردن ایجنت جلوگیری میکرد و مسیرهایی را به وجود آورد که به ایجنت آموزش میداد قبل از پاسخ دادن، کل صفحه را بررسی کند.
سازمانها برای استفاده از EnvHarness به چه چیزی نیاز دارند؟
فریمورک EnvHarness خودِ ایجنت را آموزش نمیدهد، بلکه تجربیاتی را خلق میکند که مکانیسم یادگیری دیگری باید از آنها استفاده کند.
در آزمایشهای اصلی، پژوهشگران از یک خط لوله مشابه ReasoningBank برای تبدیل مسیرها به اسکیلهای قابل استفاده مجدد بهره بردند. استقرار در سطح سازمانی نیز به همین ترتیب نیازمند ترکیب EnvHarness با استخراج اسکیل یا حافظه، فاینتیون (fine-tuning)، یادگیری تقویتی یا مکانیزم دیگری است که ایجنت را بر اساس تجربهاش تغییر دهد.
این ویژگی همچنین باعث میشود EnvHarness مکمل کلاس رو به رشدی از فریمورکها مانند Self-Harness ،HarnessX و DarwinX باشد که بهطور خودکار هارنس ایجنت را اصلاح میکنند.
این تکنیکها با بهبود قوانین، جریانهای کاری، اسکیلها یا سایر داربستهای ایجنت، بخش سمت ایجنت تعامل را تغییر میدهند. اما EnvHarness شرایطی را که ایجنت تحت آن یاد میگیرد تغییر میدهد. به گفته وانگ، «بهینهسازی سمت ایجنت نمیتواند در خلأ اتفاق بیفتد؛ برنامهریزی داخلی، بازتاب و تصمیمگیری ایجنت توسط تعاملات آن با دنیای بیرون شکل میگیرد.» محدودیتهای محیطی پویا میتوانند هارنسِ بهبودیافته را مجبور به رویارویی با رفتارهایی کنند که در غیر این صورت ممکن بود از آنها اجتناب کند یا از طریق میانبرهای شکننده آنها را حل کند.
اگرچه فریمورکهای ایجنتهای خودتکاملیافته بهطور همزمان با EnvHarness آزمایش نشدهاند، اما این رویکردها بر روی بخشهای متفاوتی از پشته (stack) عمل میکنند و در اصل میتوانند یک حلقه بازخورد تشکیل دهند: EnvHarness یک نقطه ضعف را آشکار میکند، یک سیستم سمت ایجنت هارنس را بهبود میبخشد، و سپس EnvHarness چالشهای جدیدی پیرامون ایجنت بهروزرسانیشده ایجاد میکند.
در اینجا دو هزینه اصلی برای پیادهسازی وجود دارد. اولی ادغام یک محیط موجود با EnvHarness است. تیمها باید یک پل (Bridge) بنویسند که محیط را از طریق رابط مشترک ActionableEnv در فریمورک در دسترس قرار دهد. توسعهدهندگان در حال حاضر شامل Bridgeهایی برای چندین نوع زمان اجرا هستند، از جمله محیطهای مبتنی بر داکر برای SWE-bench ،OfficeQA و SpreadsheetBench.
برای جریانهای کاری نرمافزاری مبتنی بر کانتینر، وانگ معتقد است که ادغام میتواند در خارج از خود محیط قرار گیرد. او گفت: «خطوط لوله CI/CD سازمانی معمولاً محیطها را در کانتینرهای ایزوله داکر یا کوبرنیتیز اجرا میکنند و EnvHarness بهسادگی به عنوان یک پلاگین بیرونی سبکوزن روی آن اجراکننده تست موجود متصل میشود.» برای محیطهایی که از قبل الگوی تعامل تنظیممجدد-و-مرحله (reset-and-step) مورد نیاز را در دسترس قرار میدهند، این بدان معناست که تیمها میتوانند ایمیج کانتینر، پایگاه کد و تستهای واحد داخلی را دستنخورده نگه دارند، در حالی که EnvHarness دستورات را در لایه رابط رهگیری میکند.
هزینه دوم مربوط به پردازش است. وانگ در این خصوص میگوید: «نقطه ضعف EnvHarness بیشتر محاسباتی است تا معماری.» هزینه عملیاتی ناشی از حلقه EnvRigger است که برای تشخیص ضعف، تولید یک اصلاحیه و بررسی قابلحل ماندن آن، به چندین بار اجرای ایجنت نیاز دارد.
الزام به بازنشانی (reset) همچنین مرز مشخصی را برای مکانهایی که استفاده از EnvHarness منطقی است، ایجاد میکند. این فریمورک برای محیطهای سندباکس دیجیتال که اجرا در آنها ارزان است و وضعیت میتواند بهسرعت بازیابی شود (مانند محیطهای کدنویسی، شبیهسازیهای استفاده از ابزار و سیستمهای تست اتوماسیون وب) مناسب است. باید از اجرای مستقیم حلقه تشخیصی بر روی سیستمهایی با اثرات جانبی غیرقابل بازگشت یا بازنشانیهای گرانقیمت (مانند پایگاههای داده تولیدی زنده، حسابهای مشتریان واقعی یا رباتهای فیزیکی) خودداری کرد. در این موارد، به یک شبیهساز ایمن، مستأجر تست (test tenant) یا نسخه قابلبازیابی از محیط تولید نیاز است.
بخش تحقیقات گوگل کد EnvHarness، پیکربندیهای آزمایش و پیادهسازی RL را در GitHub تحت مجوز متنباز Apache 2.0 منتشر کرده است.
با بهبود مدلهایی که توان EnvRigger را تأمین میکنند، پیشبینی میشود هزینه طراحی و اعتبارسنجی اصلاحات محیطی کاهش یابد، زیرا ایجنتهای طراح قویتر به تکرارهای کمتری نیاز خواهند داشت. اما هدف حذف محیطهای ساختهشده توسط انسان نیست. وانگ EnvHarness را راهی برای دریافت ارزش آموزشی بیشتر از مجموعه کوچکتری از محیطهای باکیفیت و دارای اعتبارسنجهای قابلاعتماد توصیف میکند.
وی در نهایت تأکید کرد: «EnvHarness جایگزین محیطهای پایه نمیشود، بلکه به عنوان یک تقویتکننده برای آنها عمل میکند. در حالی که محیطهای طراحیشده توسط انسان همچنان به عنوان مرجع پایه عمل خواهند کرد، رویکردهایی مانند EnvHarness ممکن است مسیر عملی مناسبی برای کاهش هزینههای توسعه و دریافت پوشش بیشتر از هر محیط ارائه دهند.»
برچسب های مرتبط
مطالب مرتبط و پیشنهادی

رکورد ۸۳۳ هزار دانلود ماهانه برای LEGAL-BERT؛ وقتی توسعهدهندهها قید مدلهای گرانقیمت را میزنند!
مدل زبانی تخصصی LEGAL-BERT با ثبت بیش از ۸۳۳ هزار دانلود در ماه روی پلتفرم هاگینگ فیس حسابی خبرساز شده است. این ابزار جمعوجور و تخصصی نشان میدهد که برای پردازش و تحلیل متون حقوقی، حتماً نیازی به مدلهای غولپیکر و پرهزینه ندارید و گزینههای بهینه همچنان در اوج هستند.

جاسوسی هوش مصنوعی در محل کار؛ کارمندان میگویند کارفرماها باید قانوناً مچگیریهایشان را لو بدهند!
نظرسنجیهای تازه نشان میدهد که بیشتر کارمندان حس میکنند مدیرانشان با ابزارهای هوش مصنوعی تمام حرکات آنها را زیر نظر گرفتهاند. حالا بیش از ۸۰ درصد شاغلان خواستار تصویب قانونی شدهاند که شرکتها را مجبور کند هرگونه مچگیری و نظارت هوش مصنوعی در محیط کار را رسماً اعلام کنند.

گزارش داغ مایکروسافت از نفوذ جهانی هوش مصنوعی؛ امارات در صدر و رتبه عجیب آمریکا!
مایکروسافت در تازهترین گزارش خود از ضریب نفوذ هوش مصنوعی در جهان پرده برداشت؛ آماری شگفتانگیز که نشان میدهد امارات و سنگاپور با فاصلهای خیرهکننده پیشتاز دنیا هستند و در مقابل، آمریکا در رتبه ۲۱ جا مانده است. همچنین الگوی استفاده از هوش مصنوعی میان کشورهای غربی و کشورهای در حال توسعه، از تفاوتی عمیق میان کاربردهای روزمره و آموزش پرده برمیدارد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.