تولید ویدیوهای ۱۰ دقیقهای منسجم با ترکیب مدلهای Gemini و Veo؛ دستاورد پژوهشی جدید Google
پژوهشگران Google Research با معرفی یک چارچوب چهارگانه و چندایجنت مبتنیبر Gemini و Veo، موفق شدند مشکل افت کیفیت و عدم تداوم کاراکترها و صحنهها را در تولید ویدیوهای بلند ۱۰ دقیقهای برطرف کنند. این رویکرد نوآورانه با افزودن حافظه دیداری پایدار، برنامهریزی دقیق استوریبورد و تصحیح مداوم خطاها، راه را برای تولید فیلمهای داستانی با هوش مصنوعی هموار میسازد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- معرفی چارچوب چندایجنت یکپارچه توسط Google Research با هدایت مدلهای Gemini و Veo برای تولید ویدیوهای داستانی پیوسته تا ۱۰ دقیقه.
- تقسیم فرایند تولید میان چهار سیستم تخصصی: AI Video Co-Director برای کارگردانی، CANVAS برای حفظ حافظه بصری، A²RD برای ترکیب بلندمدت و VQQA برای رفع نقایص و بهینهسازی پرامپت.
- رفع دو چالش بنیادین ویدیوهای هوش مصنوعی شامل دگرگونی ناخواسته ویژگیها (Feature Drift) و فروپاشی محتوایی و داستانی (Content Collapse).
- ارائه سه بنچمارک جدید برای ارزیابی تداوم هویت کاراکترها و محیط در فواصل طولانی، هرچند دسترسی عمومی به این ابزارها فعلاً در حد مقالات پژوهشی است.
معماری چندایجنت Google برای ساخت ویدیوهای بلند و پیوسته
بخش تحقیقات Google موسوم به Google Research از یک چارچوب چهاربخشی رونمایی کرده است که با هماهنگسازی مدلهای Gemini و Veo، امکان تولید ویدیوهای پیوسته و چنددقیقهای را فراهم میکند. هدف اصلی این پژوهش، حل مشکل عدم تداوم بصری در کاتهای پیاپی است؛ نقصی که معمولاً به شکل تغییر لباس شخصیتها، جابهجایی وسایل صحنه، بههمریختن ابعاد اتاقها و سرایت خطاهای جزئی اولیه به صحنههای بعدی نمایان میشود. Google جزئیات این معماری را در قالب یک گزارش تحقیقاتی و چهار مقاله تخصصی ضمیمه منتشر کرده است.
ابزارهای کنونی تولید ویدیو با هوش مصنوعی تنها میتوانند کلیپهایی واقعگرایانه با طول چند ثانیه خلق کنند. متصلکردن این کلیپها به یکدیگر در قالب یک روایت منسجم، مستلزم حفظ مداوم کاراکترها، محیطها، اشیاء و سیر پیشرفت داستان در جریان دهها بار اجرای مدل است. چارچوب جدید Google با ایجاد لایههایی از برنامهریزی، حافظه دیداری پایدار، سیستم ارزیابی و بازنگری خودکار روی مدلهای پایه، به این هدف جامه عمل میپوشاند.
تقسیم وظایف میان چهار سیستم تخصصی
تیم پژوهشی Google چهار سیستم بههمپیوسته را توسعه دادهاند که هرکدام بخش مجزایی از خط تولید ویدیو را مدیریت میکنند. شایان ذکر است که در حال حاضر هیچ محصول دانلودی مستقلی این بسته نرمافزاری کامل را در اختیار عموم قرار نمیدهد.
سیستم | نقش اصلی | سازوکار کلیدی |
|---|---|---|
AI Video Co-Director | هماهنگسازی سرتاسری فرایند | جستوجوی استراتژیهای خلاقانه و امتیازدهی به کاتهای نهایی |
CANVAS | تداوم استوریبورد | ذخیرهسازی و بازیابی وضعیت بصری کاراکترها، لوکیشنها و اشیاء |
A²RD | سنتز بلندمدت ویدیو | تولید بخشهای ویدیو از طریق چرخه بازیابی، سنتز، بازبینی و بهروزرسانی |
VQQA | ترمیم نقایص بصری | تبدیل نقدهای بصری به اصلاحات پرامپت و انتخاب بهترین گزینه خروجی |
سرایت خطاهای کوچک در پرامپتها
تولید ویدیوهای طولانی خطاها را تشدید میکند؛ زیرا هر مرحله از تولید مستقیماً به دادهها و دستورالعملهای مراحل قبلی وابسته است. یک کیفریم ناقص میتواند حرکات بعدی صحنه را دچار اعوجاج کند و یک توصیف ناکافی از شخصیت باعث تغییر لباس یا جزئیات چهره در برشهای مختلف شود. افزون بر این، در پرامپتهای جداگانه، سابقه مشترکی از وقایع قبلی داستان ذخیره نمیشود.
پژوهشگران عیبیابی این مشکل را به عنوان مسئله تخصیص سهم خطا (Credit-Assignment) تعریف میکنند. هنگامی که ویدیوی نهایی دچار نقص میشود، سیستم باید دقیقاً مشخص کند کدام تصمیم در مراحل اولیه باعث بروز این اختلال شده است. Google این شکستهای بصری را به دو دسته کلی تقسیم میکند: دگرگونی ویژگیها (Feature Drift) که در آن ظاهر شخصیتها یا محیط بهطور ناخواسته تغییر میکند، و فروپاشی محتوایی (Content Collapse) که در آن روایت داستان متوقف میشود و پیشرفت معناداری ندارد.
جستوجوی گزینههای خلاقانه با ایجنت ارکستراتور
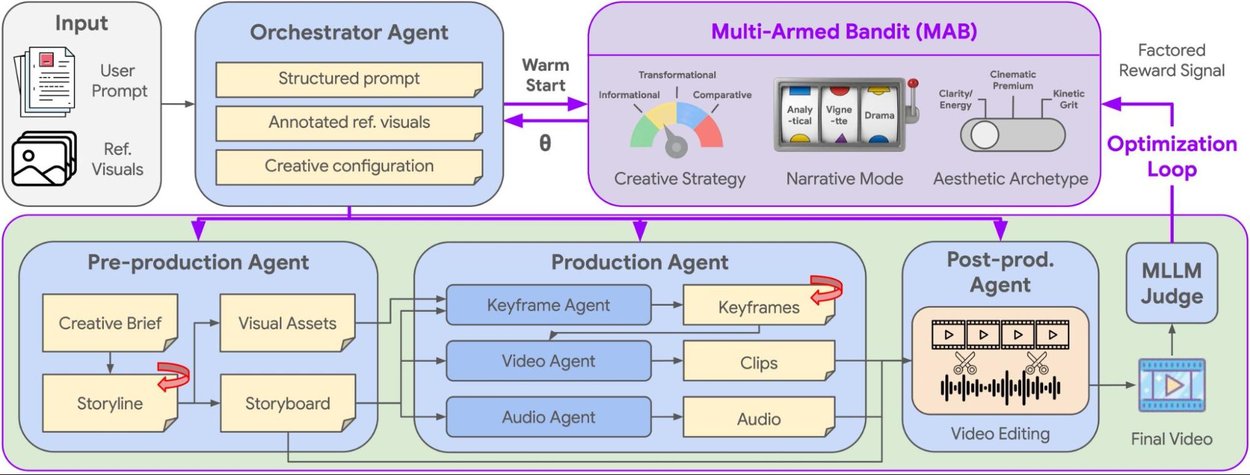
در مقاله مربوط به Co-Director، یک ایجنت هماهنگکننده (Orchestrator Agent) در رأس خط تولید قرار دارد. این ایجنت با استفاده از الگوریتم راهزن چندبازویی (Multi-Armed Bandit) که آزمایشها را بر اساس پاداشهای قبلی میان گزینههای رقیب توزیع میکند، سه بعد مختلف را بررسی میکند:
- استراتژی خلاقانه: پیام یا هدف اصلی ویدیو
- حالت روایی: ساختار مورد استفاده برای توسعه داستان
- کهنالگوی زیباییشناختی: سبک بصری و لحن صحنهها
ترکیب نهایی منتخب، به دستورالعمل مشترکی برای تمامی ایجنتهای زیرمجموعه تبدیل میشود. سپس فرایند تولید طبق یک توالی مشخص پیش میرود:
- یک ایجنت پیشتولید (Pre-Production Agent) وظیفه ساخت استوریبورد را بر عهده میگیرد.
- یک ایجنت کیفریم (Keyframe Agent) کاراکترها، اشیاء و موقعیتهای مکانی را تثبیت میکند.
- یک ایجنت ویدیو (Video Agent) حرکات لازم برای هر نما را تولید میکند.
- یک ایجنت صدا (Audio Agent) نریشن، گفتگوها و موسیقی متن را اضافه میکند.
- یک مدل چندحالته ویدیوی مونتاژشده را قضاوت کرده و سیگنالهای پاداش جداگانهای را به ایجنت ارکستراتور بازمیگرداند.
ارکستراتور از این امتیازها برای هدایت آزمونهای بعدی به سمت گزینههای موفقتر استفاده میکند و در عین حال بخشی از ظرفیت را به کاوش رویکردهای جدید اختصاص میدهد. محتوای ویدیویی تولیدشده از طریق Veo همچنان واترمارک دیجیتالی SynthID اختصاصی Google را حفظ خواهد کرد.
سیستم CANVAS؛ حافظه بصری داستان
سیستم CANVAS که کوتاهشده عبارت «روایتهای آگاه از تداوم از طریق استوریبوردینگ ایجنتی بصری» است، سوابق ساختاریافتهای از وضعیت کاراکترها، موقعیتها و اشیاء را همگام با پیشرفت داستان نگهداری میکند. هنگامی که یک صحنه یا کاراکتر پس از یک کات دوباره ظاهر میشود، سیستم ویژگیهای بصری ثبتشده پیشین را بازیابی کرده و آن را در گام بعدی تولید ادغام میکند.
آزمایش Google روی سناریوی سرقت از موزه، تداوم جزئیات تکرارشونده مانند کلاه سارق، یک سنگ قیمتی و هندسه اتاقهای نمایشگاه را ارزیابی کرد. در مقایسه منتشرشده، استفاده از یک پایپلاین مجزای Gemini 3.1 Pro به تغییر ناخواسته اشیاء و چیدمان اتاقها انجامید و مدل مبنای AutoStudio نیز جزئیات کاراکتر را در طول کاتها از دست داد؛ در حالی که CANVAS هویت تثبیتشده و ساختار فضایی را به شکلی پایدارتر حفظ کرد.
سیستم A²RD و ارتقای طول ویدیو به ۱۰ دقیقه
سیستم A²RD ویدیو را قطعه به قطعه تولید میکند و بهطور ویژه برای سکانسهایی با طول حداکثر ۱۰ دقیقه طراحی شده است. هر بخش از یک چرخه چهارمرحلهای عبور میکند که اطلاعات مرتبط را از حافظه چندحالته بازیابی، کلیپ بعدی را سنتز، آن را اصلاح و در نهایت وضعیت ذخیرهشده را بهروزرسانی میکند.
کنترلکننده این سیستم میان دو حالت تولید سوئیچ میکند: برونیابی (Extrapolation) که کنشهای جدید را معرفی کرده و طرح داستان را به جلو میبرد، و درونیابی (Interpolation) که قطعه کنونی را به شخصیتها، اشیاء و محیطهای از پیش تعیینشده متصل میکند. جابهجایی هوشمند میان این دو حالت به سیستم امکان میدهد تا ضمن ایجاد تنوع داستانی، شاخصهای هویتی بصری را در طول وقفههای طولانی حفظ کند.
تبدیل نقدها به بازنگری پرامپت با VQQA
سیستم VQQA یا «پاسخدهی به پرسشهای کیفیت ویدیو»، با بازنویسی پرامپت اولیه، آرتیفکتها و نقایص بصری را برطرف میکند. این سیستم پرسشهای هدفمندی را درباره خروجی طراحی کرده و به یک مدل بینایی-زبان ارسال میکند، سپس پاسخهای دریافتشده را به بازخوردهای متنی قابل فهم تبدیل مینماید. پژوهشگران این دستورالعملها را گرادیانهای معنایی (Semantic Gradients) مینامند؛ زیرا نقشی مشابه گرادیانهای عددی در آموزش مدل ایفا کرده و فرایند تولید گام بعدی را هدایت میکنند.
یک سازوکار گزینش جامع، از تصحیح بیشازحد جلوگیری میکند و تمامی خروجیهای نامزدشده در چرخه بهینهسازی را نگهداری مینماید. سپس یک مدل ارزیاب این گزینهها را با پرامپت اصلی مقایسه کرده و بالاترین امتیاز را برمیگزیند. از نمونههای اصلاحشده توسط Google میتوان به ترمیم یک مکعب صلب برای تبدیل آن به یک بادکنک منعطف و جلوگیری از تبادل ناخواسته سازها میان نوازندگان در میان صحنهها اشاره کرد.
بنچمارکهای جدید برای بررسی تداوم در فواصل طولانی
تیم تحقیقاتی Google علاوه بر این سیستمها، سه بنچمارک جدید معرفی کرده و عملکرد آنها را در کنار مجموعههای ارزیابی معتبر دیگر نیز سنجیده است.
بنچمارک | حوزه تحت پوشش | مقیاس یا محدودیت ارزیابی |
|---|---|---|
GenAD-Bench | ویدیوهای تبلیغاتی و مارکتینگ با الزامات دقیق خلاقانه | ۴۰۰ سناریو برای ۵۰ برند ساختگی |
HardContinuityBench | کاراکترها، لباسها، اکسسوریها، اشیاء و موقعیتهای تکرارشونده | وقفههای طولانی میان حضور دوباره در صحنه |
LVBench-C | روند تکاملی کاراکترها، اشیاء و محیطها | ۱۲۰ سناریو که در آنها داراییهای حیاتی حداقل به مدت ۱۰ سکانس ناپدید میشوند |
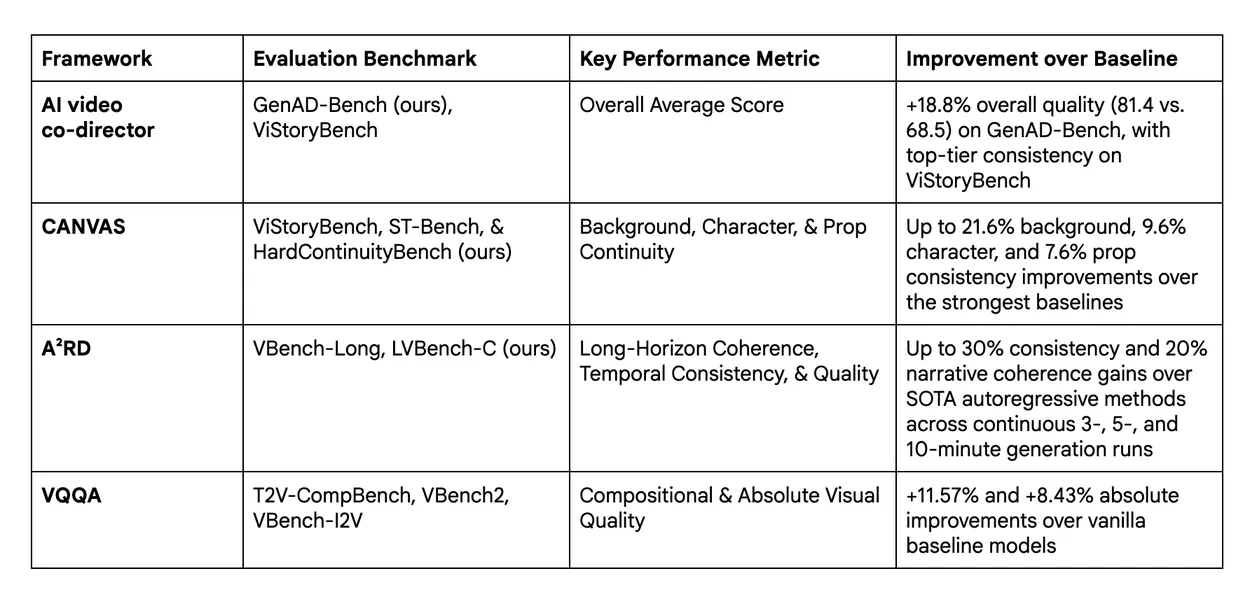
طبق نتایج اعلامشده در مقالات، سیستم AI Video Co-Director در بنچمارک GenAD-Bench به اوج امتیاز کیفیت ۸۱٫۴ دست یافته و در ViStoryBench نیز عملکرد بالاتری در تداوم داستان به ثبت رسانده است. سیستم CANVAS بهبودهای چشمگیری در پیوستگی در ST-Bench و HardContinuityBench نشان داد. همچنین A²RD ثبات شخصیتی و محیطی بهتری در VBench-Long و LVBench-C از خود نشان داد و VQQA نیز کیفیت ترکیببندی را در بنچمارکهای T2V-CompBench، VBench2 و VBench-I2V ارتقا بخشید.
با توجه به اینکه سه بنچمارک جدید توسط خود Google طراحی شده و سیستمها روی همین معیارها ارزیابی شدهاند، بازتولید مستقل این نتایج توسط تیمهای پژوهشی دیگر همچنان یک گام باز و ضروری است. البته مقالات منتشرشده تمامی تعاریف سنجهها، خطوط مبنا و نتایج دستهبندیشده را برای راستیآزمایی دقیق ارائه دادهاند.
لایهای با قابلیت استفاده مجدد فراتر از مدلهای تولیدی
معماری توسعهدادهشده، تداوم بصری را به عنوان یک متغیر صریح در سراسر خط تولید تعریف میکند. پیادهسازی سیستمی مشابه نیازمند سوابق استاندارد برای شخصیتها و اشیاء، بازیابی اطلاعات پیش از هر بار فراخوانی مدل، کنترلهای مستقل برای پیشبرد داستان در برابر حفظ تداوم، ارزیابی گزینههای نامزدشده و انتخاب نهایی بر اساس پرامپت اولیه است.
تولید مکرر فریمها، ارزیابی چندحالته و گزینش گزینهها از میان کاندیداها، مصرف منابع پردازشی، تأخیر زمانی و نیاز به فضای ذخیرهسازی را افزایش میدهد. تیمهایی که قصد دارند این الگو را به کار گیرند، باید بودجه لازم برای هزینههای استنتاج را پیشبینی کرده و معیارهای توقف روشنی برای حلقههای اصلاح مکرر تعیین کنند. هرچند آزمایشهای Google روی مدلهای Gemini و Veo متمرکز بوده است، اما این رویکردهای کنترلی میتوانند به عنوان پوستهای دور سایر مدلهای پایه ویدیویی نیز پیادهسازی شوند.
دسترسی فعلی؛ محدود به مقالات و بنچمارکها
شرکت Google نسخههای پیشنویس (Preprint) هر چهار مقاله را منتشر کرده است. در این گزارشها کنفرانسهای COLM 2026 برای سیستم AI Video Co-Director و EMNLP 2026 برای سیستم CANVAS به عنوان مقاصد انتشار تعیین شدهاند. با این حال، هنوز هیچ API عمومی یا نسخه متنبازی از این پایپلاین ارائه نشده است.
مخازن مربوط به بنچمارکها از طریق اسناد پروژه Google در دسترس قرار گرفتهاند و به توسعهدهندگان اجازه میدهند تا مدلها و خطوط تولید دیگر را در همین سناریوهای تداوم مورد سنجش قرار دهند. در حال حاضر، پیادهسازی این سیستم مستلزم بازسازی الگوهای هماهنگسازی برگرفته از مقالات و تأمین مؤلفههای مجزای برنامهریزی، تولید، حافظه و ارزیابی است.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی

رکورد ۸۳۳ هزار دانلود ماهانه برای LEGAL-BERT؛ وقتی توسعهدهندهها قید مدلهای گرانقیمت را میزنند!
مدل زبانی تخصصی LEGAL-BERT با ثبت بیش از ۸۳۳ هزار دانلود در ماه روی پلتفرم هاگینگ فیس حسابی خبرساز شده است. این ابزار جمعوجور و تخصصی نشان میدهد که برای پردازش و تحلیل متون حقوقی، حتماً نیازی به مدلهای غولپیکر و پرهزینه ندارید و گزینههای بهینه همچنان در اوج هستند.

جاسوسی هوش مصنوعی در محل کار؛ کارمندان میگویند کارفرماها باید قانوناً مچگیریهایشان را لو بدهند!
نظرسنجیهای تازه نشان میدهد که بیشتر کارمندان حس میکنند مدیرانشان با ابزارهای هوش مصنوعی تمام حرکات آنها را زیر نظر گرفتهاند. حالا بیش از ۸۰ درصد شاغلان خواستار تصویب قانونی شدهاند که شرکتها را مجبور کند هرگونه مچگیری و نظارت هوش مصنوعی در محیط کار را رسماً اعلام کنند.

گزارش داغ مایکروسافت از نفوذ جهانی هوش مصنوعی؛ امارات در صدر و رتبه عجیب آمریکا!
مایکروسافت در تازهترین گزارش خود از ضریب نفوذ هوش مصنوعی در جهان پرده برداشت؛ آماری شگفتانگیز که نشان میدهد امارات و سنگاپور با فاصلهای خیرهکننده پیشتاز دنیا هستند و در مقابل، آمریکا در رتبه ۲۱ جا مانده است. همچنین الگوی استفاده از هوش مصنوعی میان کشورهای غربی و کشورهای در حال توسعه، از تفاوتی عمیق میان کاربردهای روزمره و آموزش پرده برمیدارد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.