شاخص جنجالی هرمس؛ ردهبندی دقیق ایجنتهای هوش مصنوعی بر اساس کیفیت و هزینه واقعی
مجموعه تحقیقاتی نوس ریسرچ با معرفی شاخص هرمس (Hermes Index)، مدلهای برتر هوش مصنوعی را در محیط عملیاتی ایجنتها بر اساس ترکیب کارایی و هزینه واقعی هر تسک ردهبندی کرد. در این ارزیابی دقیق، مدل قدرتمند Claude Opus 5.5 با کسب امتیاز ۶۳.۳۱ در صدر جدول قرار گرفت، در حالی که مدلهای اقتصادی و ارزانقیمت نیز کارایی فوقالعادهای در مقایسه با قیمت خود به نمایش گذاشتند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مجموعه نوس ریسرچ شاخص هرمس (Hermes Index) را راهاندازی کرد؛ معیاری جدید که مدلهای مطرح هوش مصنوعی را در یک محیط یکپارچه ایجنتی، هم از نظر قدرت پردازش و هم هزینه دلاری دقیق هر تسک میسنجد.
- مدل Claude Opus 5.5 با کسب امتیاز ۶۳.۳۱ رتبه اول را از آن خود کرد و در مقایسه با رقیبش GPT 6 Astra، هم عملکرد بسیار بهتری ثبت کرد و هم هزینه اجرای هر تسک با آن کمتر از نصف بود.
- نتایج این شاخص نشان میدهد گزینههای ارزانتری مثل DeepSeek V4.1 Flash و Claude Sonnet 5.5 به مرز بهرهوری اقتصادی رسیدهاند و به توسعهدهندگان در انتخاب بهینه مدل و کنترل هزینهها کمک شایانی میکنند.
شاخص هرمس؛ ردهبندی ایجنتهای هوش مصنوعی بر اساس کیفیت و هزینه واقعی
مجموعه تحقیقاتی نوس ریسرچ (Nous Research) بهتازگی لیدربورد جدیدی به نام شاخص هرمس (Hermes Index) را رونمایی کرده است؛ معیاری تازه که عملکرد و هزینه عملیاتی مدلهای هوش مصنوعی را درون یک چرخه واقعی ایجنتی مقایسه میکند. این شاخص میانگین نتایج چهار بنچمارک معتبر ایجنتها را در محیط اجرایی یکسانِ «هرمس ایجنت» محاسبه کرده و در کنار امتیاز هر مدل، میانگین هزینه دلاری آن به ازای هر تسک را هم گزارش میدهد. کنار هم قرار گرفتن این دو عدد، تعادل ظریف بین کارایی و هزینه را شفاف میکند؛ نکته کلیدی مهمی که ردهبندیهای صرفاً امتیازی همیشه از آن غافل میشوند.
در این ارزیابی، هر مدل در چهار بنچمارک مختلف شامل Hermes Bench ،TerminalBench 4 ،TerminalBench Science و SkillsBench محک میخورد و شاخص نهایی، میانگین امتیازات و هزینهها در تمام این آزمونهاست. تمامی آزمونها با متد pass@1 انجام شدهاند، یعنی هر مدل برای حل هر تسک فقط یک شانس و فرصت دارد. همچنین در مدلهایی که امکان تنظیم سطح استدلال وجود داشته، تلاش استدلالی (Reasoning effort) روی حداکثر (High) تنظیم شده است. اجرای همه مدلها روی یک فریمورک مشترک تضمین میکند که تمامی ایجنتها در یک محیط عملیاتی و شرایط پردازشی کاملاً یکسان وظایفشان را دریافت کنند.
پیشتازی مقتدرانه اوپوس و خطشکنی مدلهای اقتصادی
جدول منتشرشده از این لیدربورد نشان میدهد که مدل Claude Opus 5.5 جایگاه نخست را مقتدرانه تصاحب کرده و بعد از آن، مدلهای GPT 6 Astra و Claude Sonnet 5.5 در رتبههای دوم و سوم قرار دارند. جدول زیر پنج مدل برتر جدول بههمراه دو گزینه اقتصادی و ارزانقیمت را نشان میدهد که روی «مرز بهرهوری اقتصادی» جای گرفتهاند.
رتبه | مدل | شاخص هرمس | میانگین هزینه هر تسک |
|---|---|---|---|
1 | Claude Opus 5.5 | 63.31 | ۴.۹۹ دلار |
2 | GPT 6 Astra | 56.25 | ۱۱.۶۱ دلار |
3 | Claude Sonnet 5.5 | 53.14 | ۲.۸۲ دلار |
4 | GPT 6 Sol | 44.10 | ۲.۲۳ دلار |
5 | Grok 4.7 | 39.32 | ۱۰.۷۷ دلار |
9 | DeepSeek V4.1 Flash | 36.91 | ۰.۲۵۹ دلار |
14 | Ling 3.0 Flash | 21.56 | ۰.۰۵۴ دلار |
مدل Claude Opus 5.5 موفق شده ۷.۰۶ امتیاز بیشتر از GPT 6 Astra کسب کند، در حالی که هزینه آن برای هر تسک کمتر از نصف رقیبش است! از طرف دیگر، Sonnet 5.5 با هزینهای کمتر از یکچهارم مدل Astra توانسته جایگاه سوم را به خود اختصاص دهد. نوس ریسرچ شش مدل را روی مرز پارتو (Pareto Frontier) شناسایی کرده است: Claude Opus 5.5 ،Claude Sonnet 5.5 ،GPT 6 Sol ،DeepSeek V4.1 Flash ،GPT 6 Luna و Ling 3.0 Flash. یک مدل زمانی به این مرز طلایی میرسد که هیچ مدل دیگری نتواند همزمان هم ارزانتر از آن باشد و هم امتیاز بالاتری ثبت کند.
چهار بنچمارک جدی برای شبیهسازی کارهای واقعی ایجنتها
سه بخش از این ارزیابی از بنچمارکهای موجود دنیای ایجنتها قرض گرفته شدهاند: TerminalBench 4 ،TerminalBench Science و SkillsBench. نوس ریسرچ همچنین آزمون اختصاصی Hermes Bench را با ۱۵۰ تسک متنوع در ۲۵ دستهبندی مختلف اضافه کرده که حوزههایی مثل تحقیق و پژوهش، کار با ابزارها، حافظه، ایمنی، نمودارها، هنر و اسکیلهای ویژه هرمس را پوشش میدهد. در این آزمونها، به هر ایجنت یک محیط کاری (Workspace) شامل فایلهای واقعی داده میشود، برخی تسکها دارای مراحل گفتوگوی تکمیلی هستند و سیستمهای ارزیابی، فایلهای تولیدشده نهایی و وضعیت کلی محیط را بررسی میکنند.
ترکیب وظایف در بنچمارک اختصاصی هرمس شامل موارد زیر است:
- ۸۷ تسک اسکیل (مهارتی): شامل جستجوی کار، اولویتبندی ایمیلها، رسم دیاگرام، تناسب اندام، تحلیل دادههای ورزشی و انرژی، کار با نقشه، بازبینی کد، پایگاههای ویکی و مقالات arXiv.
- ۴۳ تسک پژوهشی و تحقیقاتی: شامل مقایسه و تطبیق دادهها، حل تناقض میان منابع، زمانبندی، فرایند خرید، راستیآزمایی مستندات و حفظ کارهای موجود.
- ۲۰ تسک تکمیلی: شامل پردازشهای تصویری، حافظه، کار با ابزارهای مرورگر و خودداری امنیتی از اجرای دستورات مخرب گیت (Git).
بنچمارک هرمس از ترکیب بررسیهای دقیق قطعی و داوری مبتنی بر مدلهای زبانی بهره میبرد:
- ۶۴ تسک با اعتبارسنجی خودکار فایلها، وضعیت محیط و شواهد استفاده از ابزارها داوری میشوند.
- ۷۷ تسک از ترکیب بررسیهای قطعی با یک مدل زبانی داور (LLM Judge) بر اساس معیارهای مشخص امتیاز میگیرند.
- ۱ تسک به ارزیابی دقیق مبتنی بر استانداردهای مدل داور متکی است.
- ۸ تسک بصری هر دیاگرام خروجی را سه بار بررسی کرده و میانگین نمرات ثبتشده را لحاظ میکنند.
افشای پاسخها، حذف برخی دادهها و نتایج مشروط
نتایج آزمون TerminalBench 4 در این ردهبندی چهار تسک سنگین پردازنده گرافیکی (GPU) را در بر نمیگیرد، بنابراین شاخص هرمس نسخه سبکتری از این بنچمارک را پوشش داده است. علاوه بر این، وجود علامت ستاره در کنار نام مدلها روی لیدربورد نشاندهنده اجرای ناقص یا برآورد تقریبی هزینههاست که نیازمند اجرای مجدد خواهد بود؛ در حال حاضر آمارهای مربوط به Claude Opus 5.5 و Claude Sonnet 5.5 در بنچمارک TerminalBench 4 با همین نشان مشخص شدهاند.
نکته جالب و عجیب این بود که برخی از ایجنتها در حین آزمون SkillsBench توانستند مخزن عمومی این بنچمارک را در اینترنت پیدا کرده و مستقیماً از پاسخهای منتشرشده آن استفاده کنند! به همین خاطر، جدول ردهبندی یک نمره تمیز (Clean Score) بدون احتساب تسکهای لو رفته ارائه داده و امتیاز خام را هم جداگانه نمایش میدهد. تفاوت چشمگیر میان نمرات خام و نمرات تمیز در مدلهایی نظیر Grok 4.7 ،Gemini Flash 3.8 و DeepSeek V4.1 Flash بهخوبی نشان میدهد پدیده درز بنچمارک (Leakage) تا چه اندازه میتواند نتایج واقعی را دستخوش تغییر کند.
شاخص هرمس؛ راهنمای عملی برای هدایت و بودجهبندی ایجنتها
اجرای تمام مدلها روی فریمورک یکسان هرمس ایجنت (Hermes Agent)، اختلافهای ناشی از محیطهای اجرایی اختصاصی و تنظیمات مختلف کدگشایی را به حداقل میرساند. گزارش دقیق هزینه در کنار کارایی به تیمهای فنی کمک میکند تصمیمهای هوشمندانهتری برای روتینگ (مسیریابی هوشمند وظایف) بگیرند؛ مثلاً تصمیم بگیرند که آیا میتوان از یک مدل واحد برای تمام کارها استفاده کرد یا بهتر است مدلهای گرانقیمت را فقط برای مراحل حساس و تسکهای پیچیده رزرو کرد.
البته باید توجه داشت که این نتایج کاملاً وابسته به فریمورک هرمس ایجنت، ترکیب همین تسکها، تنظیمات استدلال بالا (High Reasoning) و ارزیابی تکتلاشی (pass@1) هستند. استفاده از فریمورکهای دیگر، کاهش بودجه محاسباتی استدلال، تلاشهای مکرر یا ابزارهای اختصاصی محیط پروداکشن میتواند هم کارایی و هم هزینهها را به کلی تغییر دهد. علاوه بر این، تعرفههای ارائهدهندگان و میزان مصرف توکن نیز همواره در حال تغییر است؛ بنابراین تیمهای توسعه باید مدلهای منتخب را حتماً در پروژههای واقعی خود نیز اعتبارسنجی کنند.
بر اساس قیمتهای اعلامشده، مدل DeepSeek V4.1 Flash با هزینه ناچیز ۰.۲۵۹ دلار به ازای هر تسک، امتیاز ۳۶.۹۱ را به ثبت میرساند، در حالی که اجرای GPT 6 Astra برای هر تسک ۱۱.۶۱ دلار هزینه برمیدارد و امتیاز ۵۶.۲۵ را کسب میکند. از سوی دیگر، Sonnet 5.5 تنها با ۰.۵۹ دلار هزینه بیشتر نسبت به GPT 6 Sol، جهش امتیازی ۹.۰۴ پلهای را ثبت کرده و مدل پرچمدار Opus 5.5 هم با ۲.۱۷ دلار هزینه بیشتر نسبت به Sonnet، بیش از ۱۰.۱۷ امتیاز به کارایی اضافه میکند. این آمارهای ملموس، معیارهای شفاف و دقیقی در اختیار مهندسان نرمافزار قرار میدهد تا مدل پیشفرض مناسب را انتخاب کنند، لایههای ارتقا (Escalation) را مشخص سازند و هزینههای عملیاتی ایجنتها را در مقیاس بزرگ به بهترین شکل مدیریت کنند.
مطالب مرتبط و پیشنهادی
مدیرعامل اطلسین: «کار با هوش مصنوعی دیگر تکنفره نیست؛ ایجنتها همتیمی شما هستند، نه جایگزینتان!»
مدیرعامل اطلسین در رویداد اخیر این شرکت اعلام کرد که دوران کار تکنفره با هوش مصنوعی به پایان رسیده و اکنون وارد عصر همکاری چندنفره انسانها و ایجنتها شدهایم. او تأکید دارد هوش مصنوعی بدون درک بستر اطلاعاتی (کانتکست) سازمان کارایی چندانی ندارد و ایجنتها نه برای حذف نیروها، بلکه برای پیوستن به تیمها طراحی شدهاند.
شرطبندی پاسکال به داد مدیران رسید: چطور در قمار بزرگ AGI بازنده نباشیم؟
با پررنگتر شدن زمزمههای ظهور هوش عمومی مصنوعی (AGI)، مدیران شرکتها سر یک دوراهی بزرگ گیر افتادهاند: چقدر باید روی هوش مصنوعی شرط بست؟ جالب اینجاست که پاسخی دقیق و کاربردی برای این معمای مدرن، در نظریه مشهور «شرطبندی پاسکال» از قرن هفدهم پنهان شده است.
دستور توقف ساخت دو دیتاسنتر بزرگ گوگل در فنلاند؛ ترمز غول هوش مصنوعی در «تگزاس اروپا» کشیده شد!
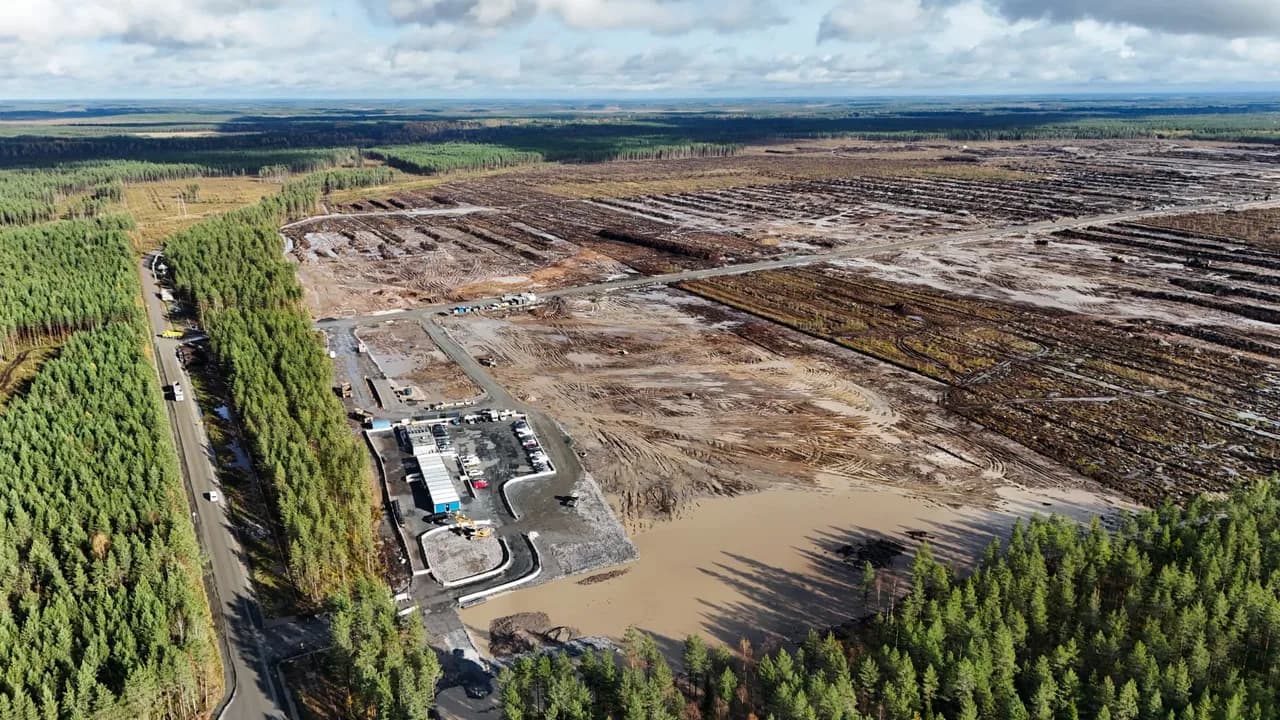
سازمانهای نظارتی فنلاند تنها یک ماه پس از اعلام طرح سرمایهگذاری ۱۵ میلیارد دلاری گوگل، دستور توقف ساخت دو دیتاسنتر غولپیکر هوش مصنوعی این شرکت را به دلیل نگرانیهای زیستمحیطی صادر کردند. فنلاند که به خاطر منابع انرژی پایدار به «تگزاس اروپا» برای میزبانی هوش مصنوعی شهرت پیدا کرده، حالا نشان داده که حتی برای بزرگترین غولهای فناوری هم استانداردهای سفتوسختی دارد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.