متا با ابزار TLX رکورد شکست: ۵۰ درصد سریعتر از FlashAttention-4 روی تراشههای بلکول انویدیا
مهندسان شرکت متا و پایتورچ با توسعه ابزار جدید TLX موفق شدند کرنل توجه مدل تبلیغاتی GEM را روی پردازندههای گرافیکی پیشرفته بلکول B200 انویدیا بازطراحی کنند. این راهکار نوآورانه تا ۵۰ درصد سریعتر از نسخه چهارم FlashAttention عمل کرده و همزمان حجم کدنویسی را تا یکسوم کاهش داده است. با انتشار متنباز این پروژه، مسیر بهینهسازی مدلهای هوش مصنوعی روی سختافزارهای جدید هموارتر از همیشه خواهد بود.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مهندسان متا و پایتورچ با ابزار اکستنشن TLX کرنل توجه رو بازنویسی کردن و تونستن روی پردازندههای غولپیکر Blackwell B200 انویدیا، در پردازش معکوس تا ۵۰ درصد سریعتر از FlashAttention-4 ظاهر بشن!
- این کرنل جدید فقط با حدود ۳۲۰۰ خط کد در پایتون و زبان تریتون نوشته شده، در حالی که رقیبش بیش از ۱۰ هزار خط کد پیچیده داشت و دست برنامهنویسها رو حسابی برای بهینهسازی سختافزاری باز میذاره.
- متا سورسکد این معماری فوقالعاده رو به صورت متنباز منتشر کرده تا همه توسعهدهندهها بتونن از این تکنیکهای جذاب و مدرن روی نسل جدید تراشههای انویدیا بهره ببرن.
مهندسان شرکت متا (Meta) و پایتورچ (PyTorch) موفق شدند کرنل توجه (Attention Kernel) مورد استفاده در مدل تبلیغات مولد متا موسوم به GEM را برای پردازندههای گرافیکی پیشرفته Blackwell B200 انویدیا از نو بازطراحی کنند. پیادهسازی تازه آنها برای «توجه ناهموار» (Jagged Flash Attention) که با استفاده از اکستنشنهای TLX توسعه یافته، در بارهای کاری واقعی مدل GEM توانسته نسخه می ۲۰۲۶ فناوری FlashAttention-4 (یا همان FA4) را شکست دهد؛ آن هم در حالی که تنها از یکسوم حجم کد آن استفاده میکند!
بر اساس گزارش فنی تیم مهندسی، محاسبات توجه همواره کندترین بخش پردازشی در مدل GEM به شمار میرود. دستیابی به توان عملیاتی بالا مستلزم آن است که جابهجاییهای حافظه، محاسبات سافتمکس (Softmax) و ضرب ماتریسی در هستههای تانسور (Tensor Cores) به صورت همزمان و موازی همپوشانی شوند. برنامهنویسان تا پیش از این برای کنترل این زمانبندی دقیق، معمولاً مجبور بودند به سراغ زبانهای سطحپایینی مثل CuteDSL یا کدنویسی مستقیم با CUDA بروند؛ اما اکستنشن TLX امکان اعمال کنترلهای سختافزاری مشابه را مستقیماً از طریق کدهای سطح پایتون در محیط Triton فراهم کرده است.
قابلیتهای سختافزاری بلکول زیر ذرهبین TLX
محیط استاندارد تریتون (Triton) از یک مدل برنامهنویسی مبتنی بر کاشی (Tile-based) بهره میبرد و زمانبندی، تخصیص حافظه اشتراکی و پایپلاینها را تا حد زیادی به کامپایلر واگذار میکند. در مقابل، افزونه TLX کنترل مستقیم و دقیقی بر حافظه اشتراکی (SMEM)، حافظه تانسور بلکول (TMEM)، تخصیص وظایف به وارپها (Warp Specialization)، موانع همگامسازی (Synchronization Barriers)، و همچنین انتقال ناهمگام دادهها و محاسبات ماتریسی در اختیار توسعهدهنده میگذارد.
- تخصیص تخصصی وارپها (Warp Specialization): دستور پایه
async_taskبه توسعهدهنده اجازه میدهد وارپهای مجزایی را برای مراحل بارگذاری داده، ضرب ماتریسی، محاسبات سافتمکس، محاسبات تصحیح و ذخیرهسازی خروجی تعیین کند. - شتابدهنده TMA: قابلیت شتابدهنده حافظه تانسور (Tensor Memory Accelerator) در انویدیا، کاشیهای چندبعدی را به صورت ناهمگام میان حافظه با پهنای باند بالا (HBM) و حافظه روی تراشه جابهجا میکند.
- دستورات MMA: دستورالعملهای ضرب و جمع ماتریسی تانسوری (Matrix Multiply-Accumulate) عملیات هستههای تانسور را برای کرنل توجه به اجرا درمیآورند.
- کنترل اجرای خوشهای (Cluster Launch Control): معماری سختافزاری بلکول میتواند بارهای کاری درون صف را بلافاصله به اولین چندپردازنده جریانی (SM) که ظرفیت خالی پیدا میکند، تخصیص دهد.
کرنل نهایی توسعهیافته با این شیوه تنها حدود ۳٬۲۰۰ خط کد در سطح تریتون دارد؛ در حالی که پیادهسازی FA4 با CuteDSL به بیش از ۱۰ هزار خط کد سنگین نیاز داشت. در آزمایشهای انجامشده روی بارهای کاری ناهموار، تیم توسعه از بهبود میانگین ۱۳ درصدی در مرحله رفت (Forward Pass) و جهش چشمگیر ۵۰ درصدی در مرحله برگشت (Backward Pass) خبر داده است.
توالیهای نامتقارن مدل GEM در یک قالب ثابت جا نمیشوند!
مدل هوش مصنوعی GEM تاریخچه فعالیت کاربران را تحلیل میکند که طول هر یک از آنها به شدت با دیگری متفاوت است. اگر قرار باشد برای یکسانسازی اندازه، تمام توالیها با دادههای خالی پدینگ (Padding) پر شوند، ممکن است تا نیمی از کل توان پردازشی سیستم صرف خانههای خالی و بیمصرف شود! به همین دلیل، مدل GEM توالیها را در قالب تانسورهای پیوسته و فشرده بستهبندی میکند و مرزهای آنها را در یک تانسور آفست (Offsets) نگه میدارد. در این سناریو، کرنل Jagged Flash Attention بدون نیاز به ایجاد پدینگهای ساختگی، مستقیماً روی همین دادههای فشرده و ناهموار کار میکند.
همچنین مدل GEM یک کوئری (Query) متراکم را در میان تمام توالیهای موجود در یک بچ به صورت سراسری برودکست (پخش) میکند. در حین مرحله پسانتشار خطا (Backpropagation)، هر توالی در گرادیان همان کوئری مشترک (یعنی dQ) سهیم میشود؛ در نتیجه کرنل باید نتایج جزئی حاصل از کل بچ را ادغام و تجمیع (Reduce) کند. از آنجایی که برنامههای همزمان برای نوشتن در این خروجی مشترک رقابت میکنند، بخش پایانی عملیات تجمیع به یکی از بزرگترین گلوگاههای سرعت در مرحله پسانتشار تبدیل میشود.
وارپهای تخصصی؛ هستههای تانسور همیشه سرگرم کار میمانند
مهندسان برای حل این مشکل، هر آرایه نخ همکاریکننده (CTA که در اصطلاح کودا همان بلوک نخی یا Thread Block نامیده میشود) را به وظایف ناهمگام با نقشهای مشخص تقسیم کردند. به این ترتیب، وارپهای اختصاصی مسئولیت بارگذاری داده با TMA، عملیات هستههای تانسور، محاسبات سافتمکس و تصحیح، ذخیره خروجی و تجمیع گرادیان dQ در مرحله برگشت را بر عهده میگیرند. این تقسیم کار هوشمندانه باعث میشود عملیات ماتریسی بدون حتی یک لحظه وقفه ادامه یابد، در حالی که وارپهای دیگر مشغول جابهجایی داده یا محاسبه سافتمکس هستند.
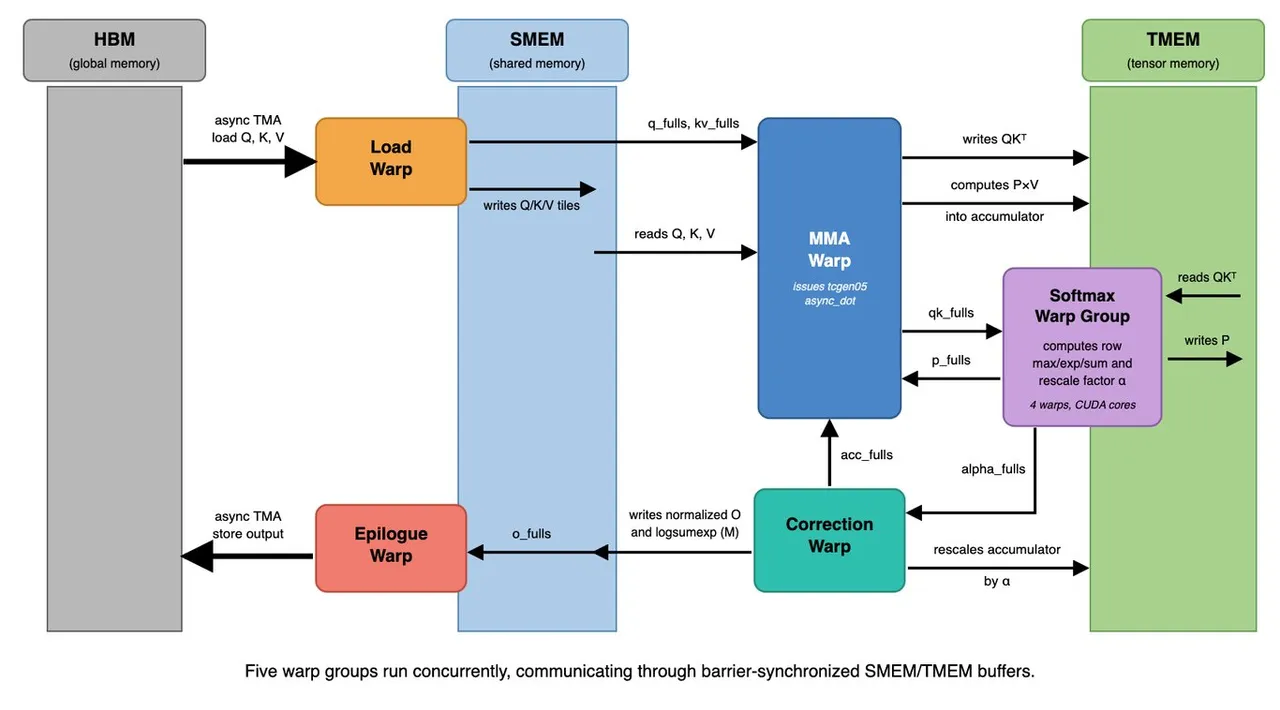
تخصیص صریح حافظه روی تراشه، یک پایپلاین سهمرحلهای برای K/V را امکانپذیر میسازد؛ به این شکل که وارپ بارگذاری داده میتواند ورودیهای آینده را دریافت کند، در حالی که هستههای تانسور مشغول پردازش کاشی فعلی هستند. بافرهایی با طول عمر غیرهمپوشان نیز ظرفیت حافظه TMEM را به اشتراک میگذارند. علاوه بر این، هر دو مرحله پردازش از الگوی اجرای پایدار (Persistent Execution) بهره میبرند؛ یعنی به جای راهاندازی یک بلوک نخ جداگانه برای هر کاشی، یک بلوک به هر پردازنده جریانی متصل شده و کاشیهای بعدی را پشت سر هم پردازش میکند.
پنج ترفند کلیدی که قفل جهش کارایی را شکستند
بررسیهای دقیق با ابزار پروفایلینگ NVIDIA Nsight Compute مشخص کرد که عدم تعادل در توزیع بار، ترافیک تجمیع دادهها، طول عمر حافظه تانسور و فشار روی ثباتها (Register Pressure)، عوامل اصلی افت کارایی بودند. تیم مهندسی برای هر کدام از این چالشها راهحل مشخصی پیاده کرد:
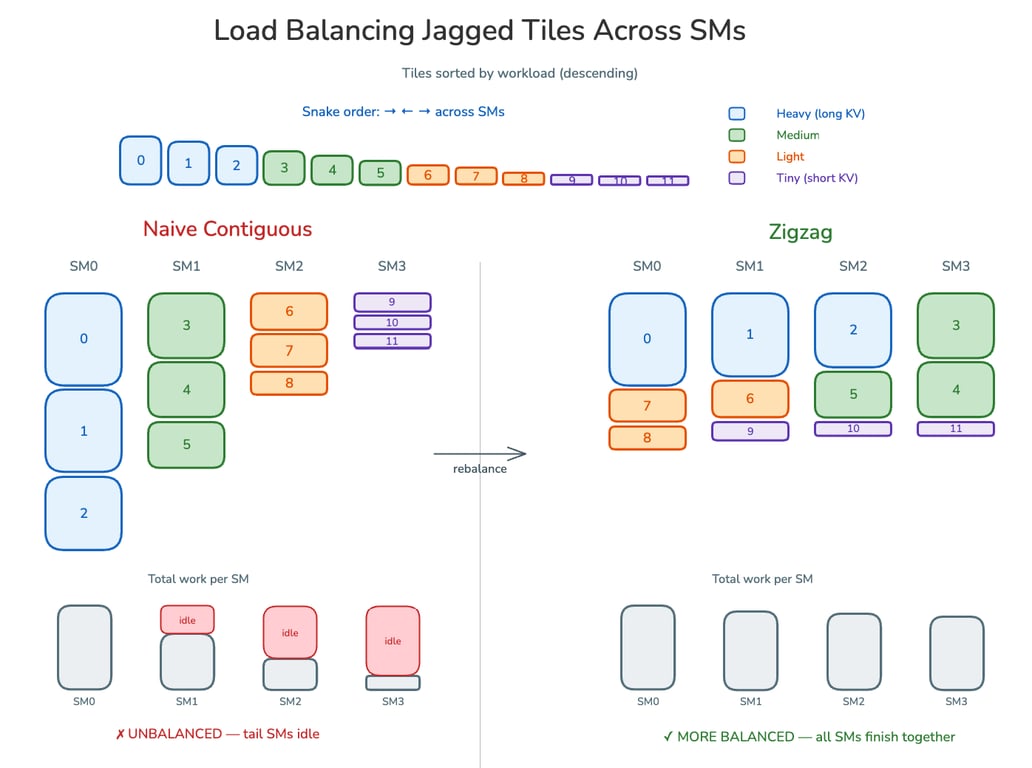
- متعادلسازی کاشیهای ناهموار پیش از اجرا: پردازنده مرکزی (CPU) ابتدا کاشیها را بر اساس حجم محاسباتی Key-Value مرتب کرده و سپس آنها را با الگوی رفتوبرگشتی یا زیگزاگی میان پردازندههای جریانی توزیع میکند؛ به طوری که هر پردازنده ترکیبی متوازن از کاشیهای کوتاه و بلند دریافت کند. همین تغییر در زمانبندی، سرعت مرحله رفت را تا حدود ۲۰ درصد ارتقا داد.
- تخصیص پویا برای کارهای باقیمانده: قابلیت کنترل اجرای خوشهای (Cluster Launch Control) به محض اینکه کار فعلی یک پردازنده به پایان برسد، کاشی بعدی صف را به آن تحویل میدهد. این سازوکار، چیدمان ایستا را تکمیل کرده و از اتلاف وقت پردازندهها در شرایط نامتقارن جلوگیری میکند.
- پایپلاینسازی تجمیع گرادیان کوئری: ثبت و تجمیع مقادیر
dQدر حافظه با پهنای باند بالا (HBM) عامل هدررفت ۹ تا ۱۱ درصدی ظرفیت هستههای تانسور بود. ایجاد یک پایپلاین دو بافره (Double-buffered) در حافظه اشتراکی SMEM باعث شد تا حین آمادهسازی مرحله بعدی، عملیات ذخیره گرادیان در پسزمینه تکمیل شود. - آزادسازی سریعتر حافظه تانسور: کرنل قبل از آزادسازی حافظه TMEM، آخرین برشهای گرادیان
dQرا به ثباتها منتقل میکند. با این کار، وارپ محاسبات ماتریسی میتواند کار روی کاشی بعدی را سریعتر آغاز کند که این امر کارایی هستههای تانسور را ۸ تا ۱۱ درصد ارتقا داده است. - جداسازی دم حلقه ماسکشده (Loop Peeling): حلقه اصلی K/V بدون ماسک اجرا میشود و یک گام نهایی مجزا برای پردازش کاشیهای ناقص در نظر گرفته شده است. حذف شاخههای شرطی از مسیر اصلی محاسبات باعث شد کامپایلر دیگر مجبور نباشد برای سناریوهای نادری که کمتر اتفاق میافتند ثبات ذخیره کند و فشار رجیسترها کاهش یابد.
علاوه بر این، یک مسیر محاسباتی همکارانه مبتنی بر دو CTA طراحی شد که دو بلوک نخی را در قالب یک خوشه جفت میکند تا ضربهای ماتریسی گستردهتر را انجام دهند. در پیکربندی عملیاتی مدل GEM با کوئری برودکست و بعد هد ۱۲۸، این رویکرد توان پردازش مرحله برگشت را حدود ۱۲ درصد افزایش داده و زمان تاخیر را در مقایسه با روش تکبلوکی نزدیک به ۱۱ درصد کم کرده است.
نتایج بنچمارک؛ درخشش خیرهکننده در بارهای کاری ناهموار
تیم توسعه کارایی کرنلهای با دقت bfloat16 را روی پردازنده گرافیکی NVIDIA B200 در برابر نسخه می ۲۰۲۶ فناوری FA4 مورد سنجش قرار داد. نتایج ثبتشده بسته به نوع بار پردازشی به شرح زیر است:
نوع بار کاری | مرحله پردازش | نتیجه عملکرد TLX در مقایسه با FA4 |
|---|---|---|
ناهموار (Jagged) | مرحله رفت (Forward) | به طور میانگین حدود ۱۳٪ سریعتر؛ عملکرد در سنگینترین و متراکمترین سناریوها کمی کندتر |
ناهموار (Jagged) | مرحله برگشت (Backward) | به طور میانگین حدود ۵۰٪ سریعتر در تمام ابعاد و شکلهای آزمایششده |
متراکم (Dense) | مرحله رفت (Forward) | رسیدن به حدود ۸۷٪ از توان عملیاتی FA4 |
متراکم (Dense) | مرحله برگشت (Backward) | به طور میانگین حدود ۱۷٪ سریعتر |
این ارقام مربوط به ابعاد، نوع دادهها و پیکربندیهای آزمایششده روی تراشه B200 و این نسخه خاص از FA4 است و لزوماً به این معنی نیست که روی تمامی کارتهای گرافیک یا ساختارهای دیگر اتنشن چنین اختلافی دیده شود. در حقیقت، نتایج مرحله رفت در حالت متراکم نشان میدهد که بیشترین دستاورد این روش در بارهای کاری ناهموار مدل GEM و پردازش کوئریهای برودکست در مرحله برگشت به دست آمده است.
معماری مشترک؛ پشتیبانی از دقتهای پایینتر و تنکسازی
ساختار مبتنی بر وارپهای تخصصی به عنوان بستری برای توسعه دو گونه دیگر نیز به کار گرفته شد؛ قابلیتی که به برنامهنویسان اجازه میدهد زمانبندی و پایپلاین انتقال حافظه را حفظ کرده و تنها نحوه محاسبه توجه را تغییر دهند:
- مکانیزم توجه MXFP8: در این حالت عملیات ماتریسی با مقیاسبندی بلوکی از دادههای E4M3 FP8 به همراه فاکتورهای مقیاس E8M0 برای هر بلوک استفاده میکنند. گزارشها نشان میدهد سرعت مرحله رفت در این حالت از پیادهسازی FP8 در FA4 بالاتر رفته و در مرحله برگشت روی دادههای متراکم به کارایی مشابهی دست یافته است.
- مکانیزم توجه تنک بلوکی (Block-sparse Attention): در این تکنیک، یک کرنل امتیازدهی بلوکهای کلید و مقدار برتر (Top-k) را برای هر بلوک کوئری گزینش کرده و سپس محاسبات توجه فقط روی همین بلوکهای برگزیده اجرا میشود. پردازش تنها نیمی از بلوکها موجب دستیابی به شتاب ۱٫۳ تا ۱٫۵ برابری در مقایسه با توجه متراکم کامل شد.
نقشه راهی کاربردی برای بهرهوری حداکثری از تراشههای بلکول
ابزار TLX به تیم مهندسی این قدرت را داد تا نقلوانتقالات حافظه در بلکول، محاسبات هستههای تانسور و صفهای کاری پایدار را بدون نیاز به ورود به دنیای طاقتفرسای کدهای سطحپایین CUDA مدیریت کنند. علاوه بر این، حجم به مراتب کمتر کدها، امکان بازاستفاده از ساختار کرنل را برای نسخههای FP8 و توجه تنک به سادگی میسر ساخت.
بسیاری از تکنیکهای بهکاررفته در این پروژه کاربردی فراتر از یک مدل خاص دارند و میتوانند برای عموم پردازشها روی تراشههای بلکول راهگشا باشند: تخصیص پویای کاشیها به بارهای کاری با ابعاد نامتعادل کمک میکند، ساختار چندمرحلهای میتواند تاخیر ذخیرهسازی دادههای تجمیعی را پنهان سازد، آزادسازی زودهنگام TMEM وابستگیهای میان کاشیها را کاهش میدهد و جداسازی بخش پایانی حلقهها فشار روی ثباتها را خنثی میکند. البته چیدمان زیگزاگی بیشتر مناسب بارهای کاری ناهموار با ساختار مشخص است و پایپلاین گرادیان dQ و روش دو CTA نیز برای پیکربندی کوئری برودکست در مدل GEM طراحی شدهاند.
متا سورسکد کامل این کرنل شامل پیادهسازی TLX و مسیرهای بهینهسازیشده برای بارهای کاری اختصاصی را به صورت عمومی منتشر کرده است تا توسعهدهندگان سراسر جهان بتوانند از این الگو و معماری مدرن در پروژههای هوش مصنوعی خود بهرهبرداری کنند.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
درخشش دیجی هوش مصنوعی در رادیوی لسآنجلس؛ مجریان واقعی حسابی شاکی شدند!
دیجی هوش مصنوعی جدیدی به نام «کویوتک» حسابی در رادیوی لسآنجلس گل کرده و با جذب مخاطبان، حالا پایش به چندین شهر دیگر هم باز شده است. اما در شرایطی که صنعت رادیو با موج شدید تعدیل نیرو دستوپنجه نرم میکند، درخشش این گوینده مجازی صدای اعتراض مجریان واقعی و اتحادیههای صنفی را بلند کرده است.
شگفتی در عصر هوش مصنوعی؛ چرا حتی قدرتمندترین مدلها هم جای حس ناب انسانی را نمیگیرند؟
این روزها پیشرفتهای خیرهکننده هوش مصنوعی مدام هوش از سرمان میبرد، اما نباید یادمان برود که اصیلترین حس شگفتی از دل کارهای انسانی متولد میشود. پژوهشهای علمی نشان میدهد آنچه بیش از هر شاهکار ماشینی انسانها را به وجد میآورد، شجاعت، مهربانی و ازخودگذشتگی همنوعان ماست، نه فقط قدرت الگوریتمها.
از عکس یخچال تا سفارش غذا؛ ایجنت هوش مصنوعی دوردش به آیمسیج اپل آمد!
دوردش در حال آزمایش یک ایجنت هوش مصنوعی اختصاصی در آیمسیج اپل است که فرآیند سفارش غذا را به سادگی ارسال یک پیامک میکند. این ایجنت هوشمند حتی میتواند با تحلیل عکس یخچال شما، ایده آشپزی پیشنهاد دهد و مواد لازم کسری را خودکار به سبد خرید اضافه کند؛ هرچند نسخه بتای آن فعلاً با خطاهایی مثل قیمتهای اشتباه دستوپنجه نرم میکند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.