استقبال گسترده از BiomedBERT مایکروسافت؛ ثبت ۸۷۰ هزار دانلود ماهانه برای مدل تخصصی پزشکی
مدل زبانی BiomedBERT مایکروسافت با ثبت نزدیک به ۸۷۰ هزار دانلود در ماه گذشته، بار دیگر در صدر ابزارهای پرطرفدار پلتفرم Hugging Face قرار گرفت. این انکودر ۱۱۰ میلیون پارامتری که با نام PubMedBERT نیز شناخته میشود، پس از چند سال همچنان ستون فقرات اصلی سیستمهای پردازش متون پزشکی بهشمار میرود.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مدل زبانی BiomedBERT مایکروسافت با ثبت نزدیک به ۸۷۰ هزار دانلود در ماه گذشته، بار دیگر در فهرست ابزارهای پرطرفدار پلتفرم Hugging Face قرار گرفت.
- این انکودر ۱۱۰ میلیون پارامتری برخلاف مدلهای عمومی، از همان ابتدا و با واژگان اختصاصی مستقیماً روی مقالات تخصصی پزشکی آموزش دیده است.
- بهرهگیری از واژگان بومی حوزه سلامت به مدل امکان میدهد نام داروها، ژنها و بیماریها را با دقت بسیار بالاتری در متون بالینی شناسایی کند.
مدل BiomedBERT مایکروسافت با ثبت نزدیک به ۸۷۰ هزار دانلود در ماه گذشته، بار دیگر به فهرست مدلهای پرطرفدار پلتفرم Hugging Face بازگشته است. این انکودر مبتنی بر معماری BERT با حدود ۱۱۰ میلیون پارامتر، نخستین بار در سال ۲۰۲۰ توسط بخش تحقیقات مایکروسافت (Microsoft Research) و با نام اولیه PubMedBERT معرفی شد و پس از گذشت چند سال، همچنان نقطه شروع و زیربنای اصلی بسیاری از سیستمهای دستهبندی، استخراج اطلاعات و بازیابی متون زیستپزشکی بهشمار میرود.
چرا آموزش مدل از نقطه صفر نتیجه داد؟
توسعه مدل BiomedBERT پاسخی به این پرسش کلیدی بود که آیا یک مدل زبانی که تمام مراحل آموزش آن صرفاً روی متون زیستپزشکی انجام شده است، میتواند از مدلهای عمومی BERT که بعداً برای این حوزه تنظیم شدهاند، بهتر عمل کند یا خیر. پژوهشگران مایکروسافت هم وزنهای اولیه مدل و هم واژگان الگوریتم WordPiece را کاملاً از ابتدا مقداردهی کردند و سپس کل فرایند پیشآموزش را مستقیماً روی متون پزشکی انجام دادند. نتایج ارائهشده در مقاله پژوهشی اصلی این تیم نشان داد که این شیوه نسبت به مدلهای همدورهای که کار خود را با پیشآموزش روی متون عمومی آغاز کرده بودند، برتری پایدار و ملموسی بههمراه دارد.
نسخه پرطرفدار فعلی این مدل با شناسه BiomedBERT-base-uncased-abstract-fulltext، مجموعهای از چکیده مقالات پایگاه PubMed و متن کامل مقالات پایگاه PubMed Central را با هم ترکیب کرده است. واژگان این مدل نیز مستقیماً از همین دادهها استخراج شده و همین امر باعث میشود تعداد قطعات فرعی واژهها (Subwords) برای اصطلاحات پیچیده پزشکی به حداقل برسد. کاهش تعداد تکههای کلمه سبب میشود مرزهای معنایی عبارات تخصصی راحتتر شناسایی شوند و مدل در وظایفی همچون استخراج اسامی ژنها، مواد شیمیایی، داروها و بیماریها بهدقت بالاتری دست یابد.
بررسی جایگاه مدل در معیارهای ارزیابی تخصصی
مایکروسافت عملکرد این مدل را با استفاده از بنچمارک اختصاصی BLURB (معیار سنجش درک و استدلال زبان در علوم زیستپزشکی) ارزیابی کرده است. بنچمارک BLURB چندین وظیفه پردازش متن از جمله بازشناسی موجودیتهای نامدار (NER)، استخراج چارچوب بالینی PICO، استخراج روابط میان مفاهیم، شباهت جملات، دستهبندی اسناد و پاسخدهی استخراجی به پرسشها را ترکیب کرده و امتیاز کلی واحدی به مدل اختصاص میدهد.
مدل | اندازه پارامترها | امتیاز در بنچمارک BLURB |
|---|---|---|
PubMedBERT | نسخه Base | ۸۱٫۱۰ |
BioLinkBERT | نسخه Base | نامشخص |
مطالب مرتبط و پیشنهادی
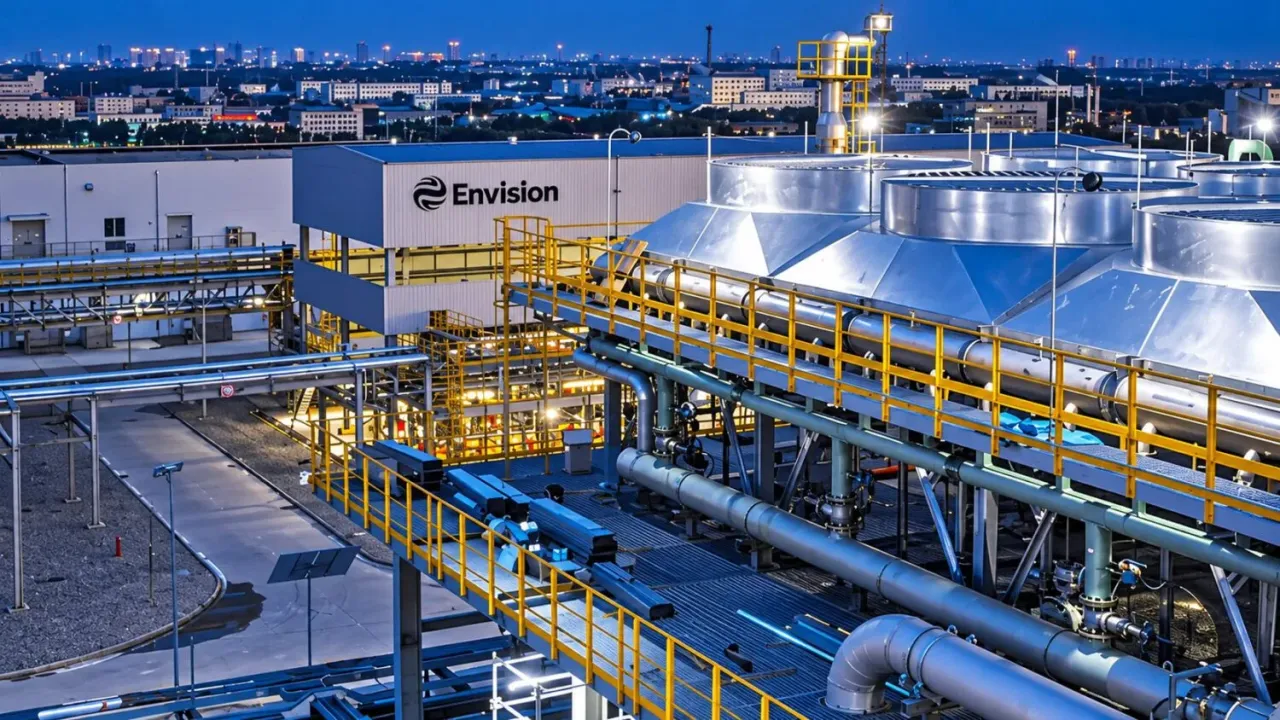
رونمایی Envision از نخستین سیستم برق ۸۰۰ ولت مستقیم برای مراکز داده هوش مصنوعی
شرکت چینی Envision از پلتفرم جدید Dubhe با سیستم برق ۸۰۰ ولت مستقیم برای تغذیه خوشههای پردازش هوش مصنوعی رونمایی کرد. این فناوری با حذف مراحل تبدیل انرژی، تلفات برق در دیتاسنترها را به حداقل میرساند. با این حال، هنوز هیچ مرجع مستقلی ارقام و کارایی واقعی این سامانه را تأیید نکرده است.
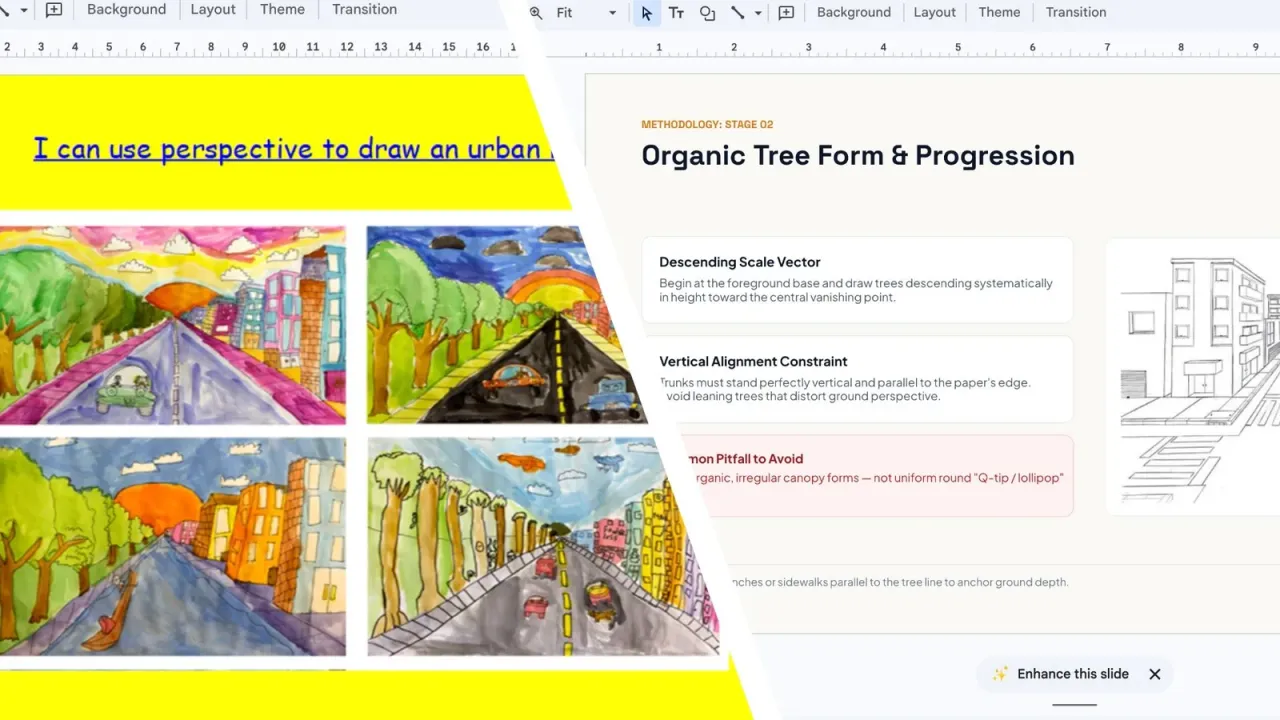
آزمایش بازطراحی اسلاید با Gemini؛ تبدیل یک درس هنر شاد به ارائهای خشک و سازمانی
گوگل قابلیت بازطراحی ارائهها با هوش مصنوعی Gemini را معرفی کرده است، اما بررسیهای عملی نشان میدهد این ابزار هنوز شناخت درستی از نیاز مخاطبان متفاوت ندارد. در آزمایشی تازه، بازطراحی اسلایدهای یک درس هنر برای دانشآموزان به قالبی بسیار خشک، اداری و فاقد جذابیت کودکانه تبدیل شد.
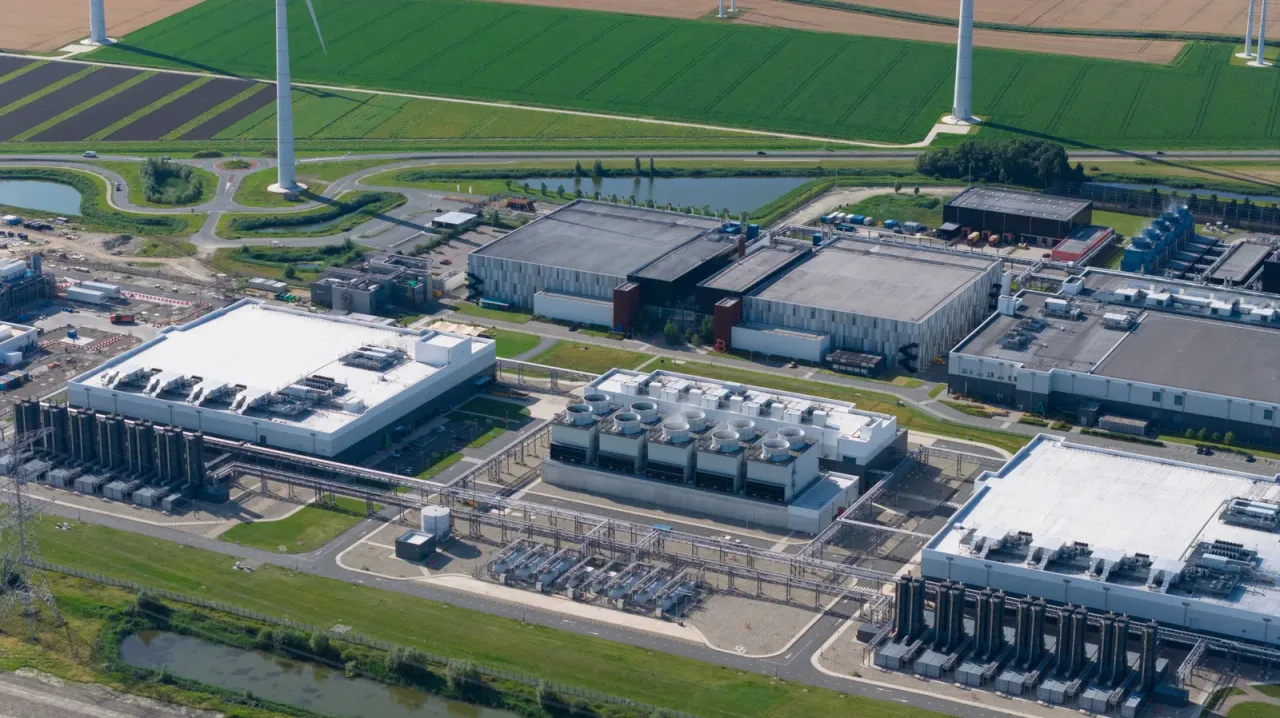
آیا خنککننده مایع انویدیا، مصرف آب در مراکز داده هوش مصنوعی را کاهش میدهد؟
انویدیا مدعی است فناوری خنککننده مایع در تراشههای جدید، مصرف آب مراکز داده را بهشکل چشمگیری کاهش میدهد. با این حال، کارشناسان هشدار میدهند که این راهکار نمیتواند بحران فزاینده مصرف برق و تبخیر میلیاردها گالن آب در نیروگاههای تأمینکننده انرژی هوش مصنوعی را مهار کند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.