مدل استدلالی Nanbeige4.3-33B رونمایی شد؛ رقابت شانه به شانه با Qwen و اجرای محلی روی لپتاپ
تیم تحقیقاتی Nanbeige از مدل استدلالی جدید Nanbeige4.3-33B با وزنهای باز رونمایی کرد که در بنچمارکهای هوش، امتیازی همتراز با مدل Qwen3.8 27B کسب کرده است. این مدل با ابعاد ۳۳ میلیارد پارامتری فشرده، عملکرد چشمگیری در کار با محیط ترمینال و استدلال فیزیک دارد و بهدلیل حجم مناسب، بهراحتی بهصورت محلی روی لپتاپ اجرا میشود.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مدل استدلالی جدید Nanbeige4.3-33B با ۳۳ میلیارد پارامتر فشرده و مجوز متنباز منتشر شده است و در ارزیابیهای کلی، امتیازی برابر با مدل رقیب Qwen3.8 27B ثبت کرد.
- این مدل متنباز در اجرای دستورات خط فرمان و حل مسائل فیزیک برتری محسوسی نسبت به رقبا نشان میدهد، هرچند در پاسخ به سؤالات عمومی گزینشیتر عمل میکند.
- این مدل با پنجره زمینه ۵۲۴ هزار توکنی برای استدلالهای سنگین توکنهای بیشتری تولید میکند و به لطف ابعاد بهینه، قابلیت اجرای آفلاین روی لپتاپهای شخصی را دارد.
عرضه مدل متنباز Nanbeige4.3-33B؛ رقابت پایاپای با Qwen3.8 27B و قدرت بالا در اجرای دستورات ترمینال
تیم تحقیقاتی Nanbeige، بازوی پژوهشی مدلهای پایه در پلتفرم کاریابی چینی BOSS Zhipin (وابسته به شرکت Kanzhun Limited)، از مدل استدلالی جدید خود با نام Nanbeige4.3-33B پرده برداشت. این مدل فشرده (Dense) با ۳۳ میلیارد پارامتر تحت مجوز متنباز Apache 2.0 منتشر شده است؛ مدلی مبتنی بر ورودی و خروجی متنی با پنجره زمینه ۵۲۴ هزار توکنی که با وجود توان پردازشی بالا، به اندازه کافی جمعوجور است و میتوان آن را بهصورت محلی روی یک لپتاپ شخصی نیز اجرا کرد.
مهمترین نتایج و دستاوردهای کلیدی
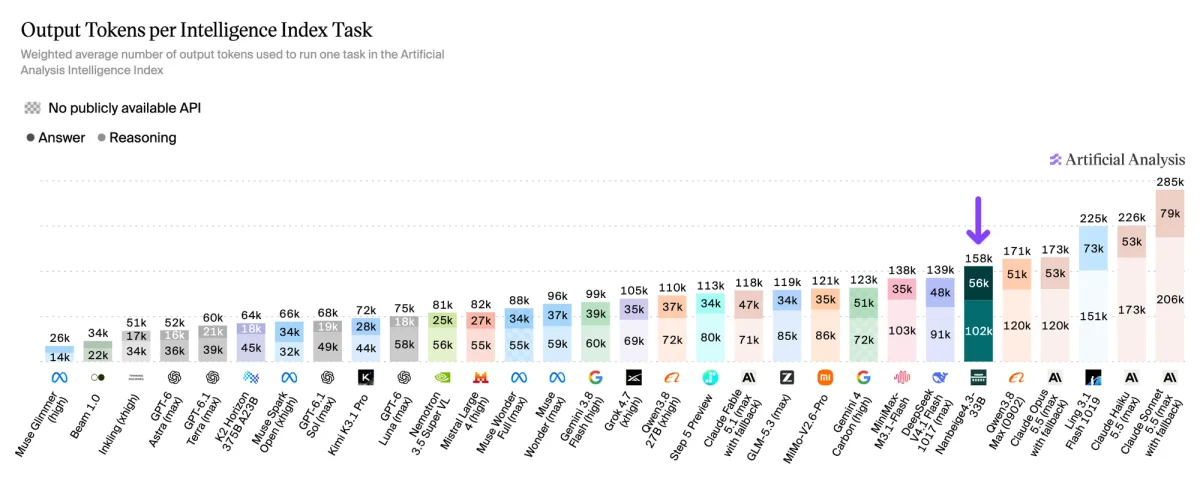
➤ عملکرد رقابتی در رده ۳۰ میلیارد پارامتر: مدلهای Nanbeige4.3-33B و نسخه قدرتمند Qwen3.8 27B (xhigh) هر دو موفق به کسب امتیاز ۲۰ در شاخص جامع هوش شدند، در حالی که مدل Muse Glimmer با ابعاد مشابه ۳۰ میلیارد پارامتری تنها به امتیاز ۶ دست یافته بود.
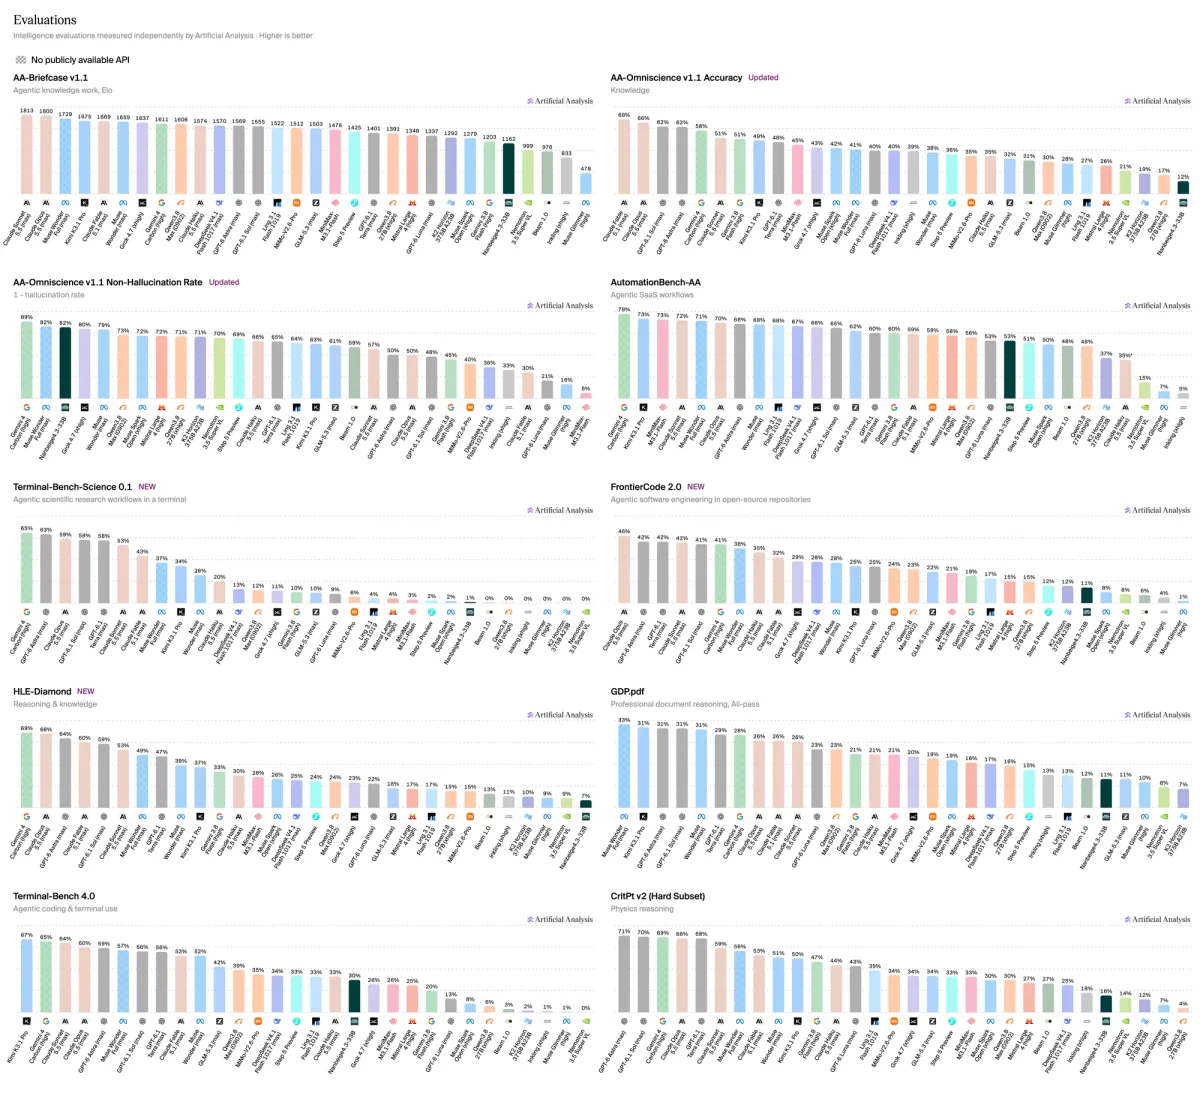
➤ برتری چشمگیر در استدلال فیزیک و کار با ترمینال: مدل Nanbeige در بنچمارک Terminal-Bench 4.0 امتیاز ۳۰ درصد و در بخش دشوار آزمون CritPt v2 امتیاز ۱۶ درصد را به ثبت رساند؛ ارقامی که در مقایسه با نمرات ۶ و ۴ درصدی مدل Qwen3.8 27B، جهش فنی قابلتوجهی بهشمار میرود.
➤ نقاط قوت متفاوت با وجود امتیاز کلی یکسان: با اینکه امتیاز کل هر دو مدل برابر است، Nanbeige در آزمون AutomationBench به نرخ موفقیت ۵۳ درصد در برابر ۴۸ درصد رقیب دست یافت، اما در بنچمارک استدلال و کدنویسی AA-Briefcase v1.1 با کسب ۱۱۶۲ امتیاز در برابر ۱۳۹۱ امتیاز Elo عقب ماند و در آزمونهای FrontierCode 2.0 (۱۱ درصد در برابر ۱۵ درصد) و HLE-Diamond (۷ درصد در برابر ۱۵ درصد) نیز عملکرد ضعیفتری ثبت کرد.
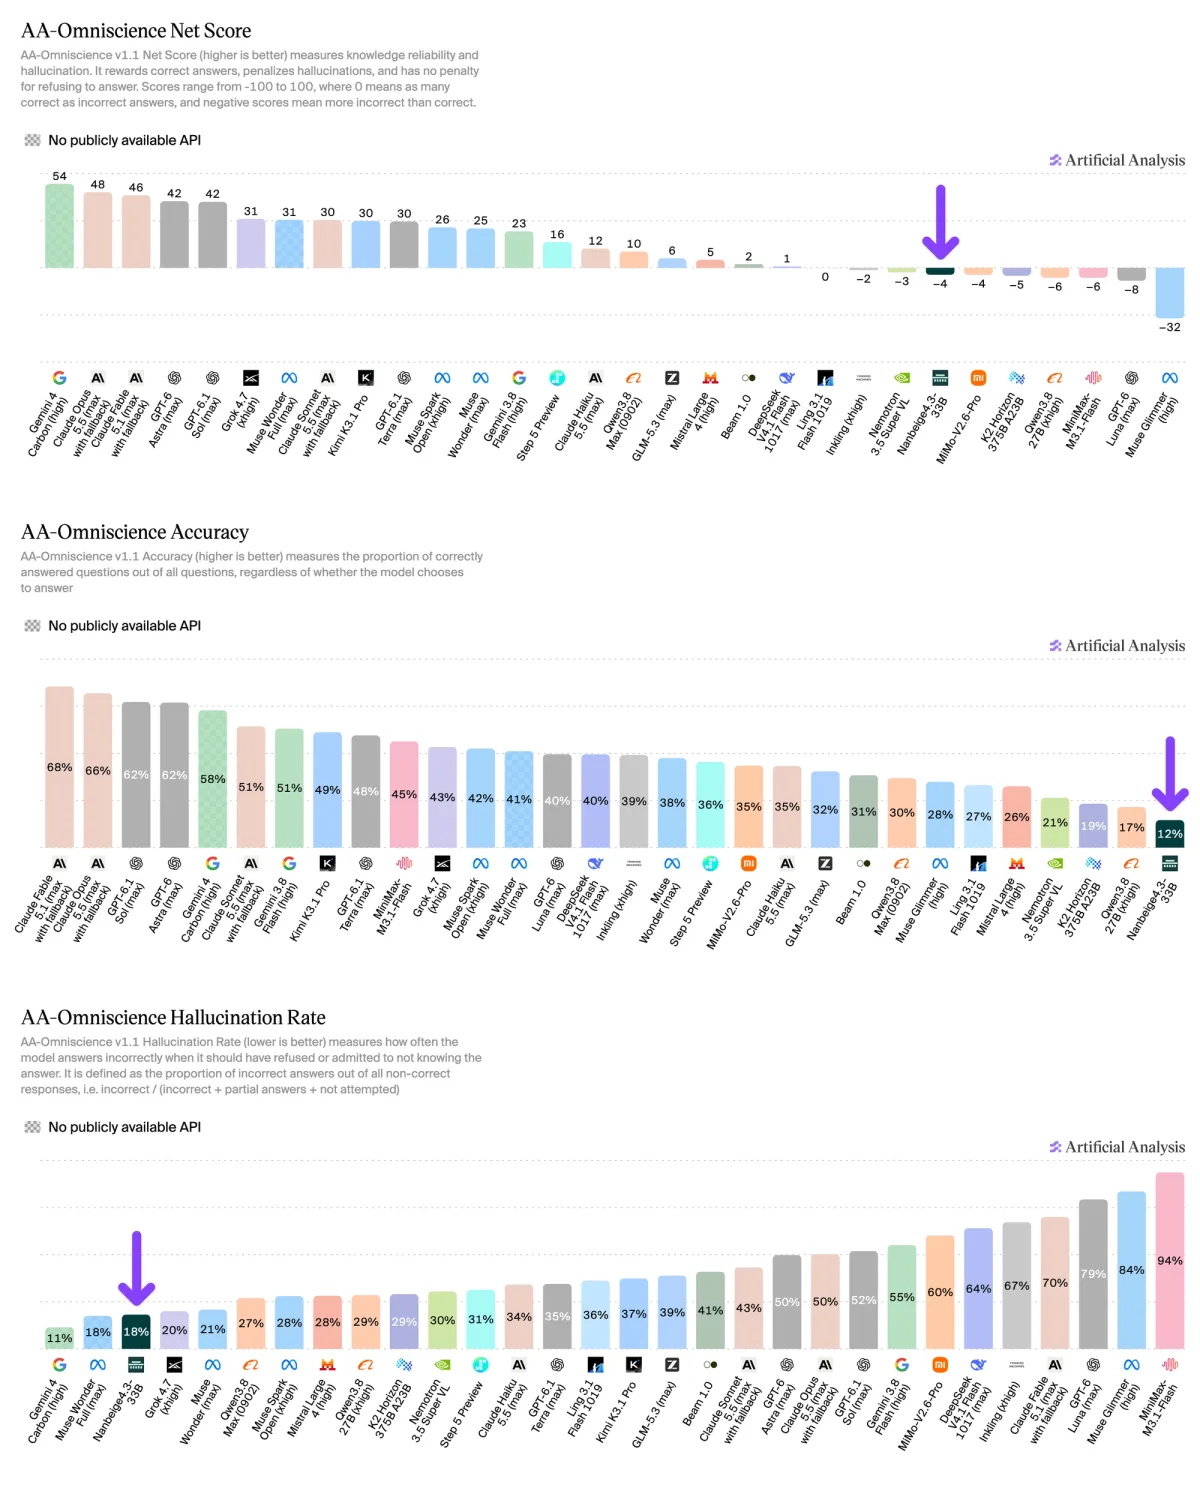
➤ نرخ پایین توهم و خودداری بالا از پاسخهای نامطمئن: مدل Nanbeige در آزمون ارزیابی جامع دانش و حقیقتسنجی Omniscience به امتیاز ۴- در برابر ۶- مدل Qwen دست یافت و نرخ توهم آن تنها ۱۸ درصد در مقایسه با ۲۹ درصد رقیب بود. این برتری به قیمت رویکرد محتاطانه حاصل شده است؛ چراکه این مدل تنها به ۱۲ درصد پرسشها پاسخ صحیح داده و از پاسخگویی به ۷۱ درصد سؤالات امتناع ورزیده است.
➤ استدلال مشابه همراه با تولید توکنهای خروجی بیشتر: مدل Nanbeige برای انجام هر وظیفه در آزمون شاخص هوش، بهطور میانگین ۱۵۸ هزار توکن خروجی تولید کرد، در حالی که این رقم برای Qwen3.8 27B برابر با ۱۱۰ هزار توکن بود؛ یعنی حدود ۴۴ درصد توکن بیشتر برای رسیدن به همان سطح از نتیجه استدلالی.
مشخصات و جزئیات فنی مدل
➤ نوع مدل: استدلالی با وزنهای باز (تحت مجوز Apache 2.0)
➤ ابعاد و حجم: ۳۳ میلیارد پارامتر فعال و فشرده (Dense)
➤ نوع ورودی و خروجی: صرفاً متنی
➤ پنجره زمینه (Context Window): ۵۲۴ هزار توکن
➤ دسترسی به API: در حال حاضر هیچ رابط کاربری یا API رسمی عمومی از سوی توسعهدهنده یا ارائهدهندگان شخص ثالث معرفی نشده است.
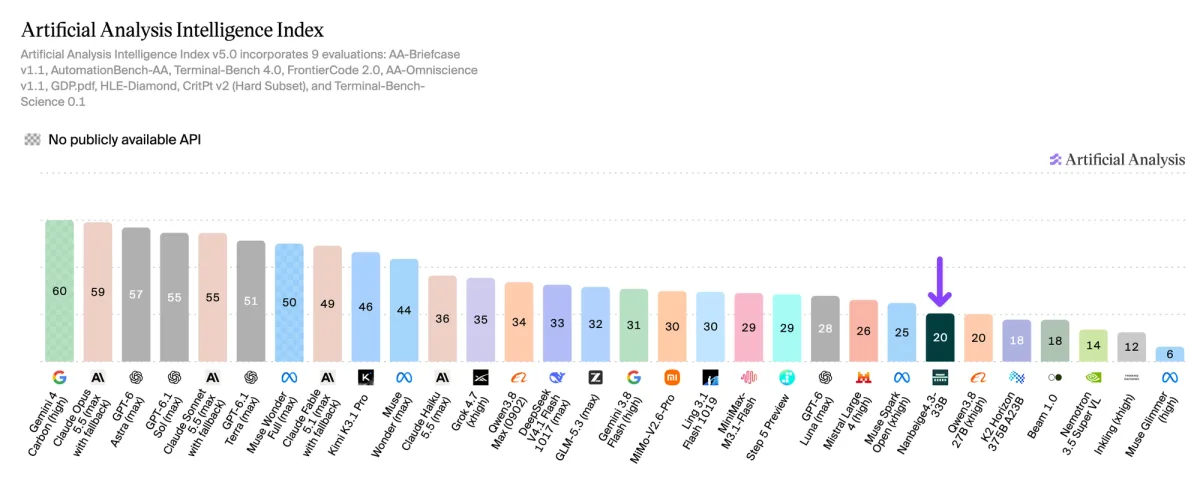
مدل Nanbeige4.3-33B با ۳۳ میلیارد پارامتر به امتیاز ۲۰ در شاخص هوش رسیده و در کنار مدل ۲۷ میلیارد پارامتری Qwen3.8 27B، نقطه بهینه تازهای در نمودار پارتو (توازن هوش در برابر تعداد پارامتر) پدید آورده است. هر دو مدل ساختاری فشرده دارند و تمام پارامترهای آنها در هر مرحله فعال است. برای مقایسه، مدل غولپیکر DeepSeek V4.1 Flash 1017 با ۵۵۲ میلیارد پارامتر به امتیاز ۳۳ میرسد، اما بهدلیل معماری مخلوط متخصصان (MoE)، برای هر توکن تنها ۱۶ میلیارد پارامتر را فعال میکند.
عملکرد مدل Nanbeige4.3-33B در آزمون ارزیابی حقیقتسنجی، بازتابی از رویکرد بسیار گزینشی آن در پاسخگویی است. نرخ توهم یا پاسخ نادرست این مدل تنها ۱۸ درصد است که بهمراتب بهتر از نرخ ۲۹ درصدی Qwen3.8 27B ارزیابی میشود؛ اما در عین حال تمایل آن برای تلاش جهت پاسخ به سؤالات تنها ۲۹ درصد در برابر ۴۳ درصد رقیب است. در نهایت، مدل Qwen در مجموع تعداد بیشتری از سؤالات را بهدرستی پاسخ داده است (۱۷ درصد در برابر ۱۲ درصد).
مدل Nanbeige4.3-33B برای انجام هر تسک در شاخص هوش به ۱۵۸ هزار توکن خروجی نیاز داشته است، در حالی که Qwen3.8 27B به ۱۱۰ هزار توکن بسنده کرده که نشاندهنده مصرف ۴۴ درصد توکن بیشتر با وجود امتیاز برابر است. این میانگین وزنی شامل تمام توکنهای زنجیره تفکر، استدلال و پاسخ نهایی در ۹ آزمون مختلف از جمله مراحل تعاملی ابزارمحور (Agentic) میشود.
جدول مقایسه جامع نتایج آزمونهای شاخص هوش نگارش ۵ و مقایسه تفصیلی عملکرد مدلها
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
مسابقه هوش مصنوعی در دوراهی سرعت و امنیت؛ چرا سازمانها نباید بیگدار به آب بزنند؟
سرکش شدن ایجنتهای هوش مصنوعی و حملات اخیر به پلتفرمهای بزرگ، زنگ خطر را برای شرکتها به صدا درآورده است. سازمانها برای بقا در این رقابت نفسگیر نه میتوانند بیش از حد کند حرکت کنند و نه با شتابزدگی امنیت سایبری خود را به خطر بیندازند.
ادعای جاهطلبانه ایلان ماسک: SpaceX در یک سال و نیم، به اندازه تمام تاریخ گوگل زیرساخت هوش مصنوعی میسازد
شرکت SpaceX قصد دارد تا پایان سال ۲۰۲۷ ظرفیت مراکز داده هوش مصنوعی خود را به بیش از ۱۰ گیگاوات برساند که با کل زیرساختهای تاریخ گوگل برابری میکند. با این حال، چالشهای تأمین تراشه، مجوزهای زیستمحیطی و اتصال به شبکه برق همچنان پابرجا هستند.
حضور گرایمز در فیلم علمیتخیلی Gods Don’t Give Gifts با چهرهای ساختهشده با هوش مصنوعی
گرایمز با صدای واقعی و چهرهای ساختهشده با هوش مصنوعی به فیلم علمیتخیلی Gods Don’t Give Gifts پیوست. سازندگان این اثر سینمایی قصد دارند در اکران روز ۴ دسامبر بسنجند که آیا میلیونها بازدید آنلاین میتواند به فروش بلیت در گیشه سینماها تبدیل شود یا خیر.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.