انویدیا با ابزار Auto Ontology مانع تحلیل دادههای نادرست توسط ایجنتهای هوش مصنوعی شد
انویدیا فریمورک متنباز جدیدی به نام Auto Ontology معرفی کرد که با ایجاد لایه معنایی مبتنی بر گراف روی پایگاههای داده، مانع از خطای ایجنتهای هوش مصنوعی در تولید کدهای SQL میشود. این ابزار به مدلهای هوش مصنوعی کمک میکند مفهوم دقیق دادهها و روابط آنها را بهدرستی بشناسند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- فریمورک متنباز Auto Ontology با ایجاد لایه معنایی مبتنی بر گراف مانع از استخراج دادههای اشتباه توسط ایجنتهای هوش مصنوعی میشود.
- این ابزار خطاهای پنهان در کوئریهای SQL را از طریق تعریف استاندارد شاخصها و روابط دادههای سازمانی برطرف میکند.
- این پروژه متنباز از طریق پروتکل Model Context Protocol و رابطهای استاندارد نرمافزاری با پایگاههای داده مختلف یکپارچه میشود.
شرکت انویدیا فریمورک متنباز جدیدی به نام Auto Ontology را در زبان پایتون منتشر کرده است که هدف آن افزایش چشمگیر قابلیت اطمینان کدهای SQL تولیدشده توسط مدلهای زبانی بزرگ است. این فریمورک یک لایه معنایی مبتنی بر گراف روی پایگاههای داده سازمانی ایجاد میکند تا ایجنتهای تحلیلگر به تعاریف تأییدشده، روابط ساختاریافته و پیشینه دادهها دسترسی داشته باشند، نه اینکه مجبور شوند مفهوم اطلاعات را صرفاً بر اساس نام ستونها حدس بزنند.
این پروژه تحت مجوز متنباز Apache 2.0 عرضه شده است و از استقرار در محیطهای محلی و کلاسترهای Kubernetes پشتیبانی میکند.
چرا کوئریهای بدون خطای SQL هم با شکست مواجه میشوند؟
بازیابی ساختار پایگاه داده شاید به ایجنت هوش مصنوعی کمک کند کدهای SQL بدون خطای نحوی بنویسد، اما خروجی نهایی ممکن است فیلد درآمدی اشتباهی را بخواند، شاخصهای ناسازگار را با یکدیگر ترکیب کند یا قوانین گزارشگری سازمان را نادیده بگیرد. بنابراین، یک کوئری کاملاً سالم از نظر دستوری، هیچ تضمینی در برابر خطاهای مفهومی و معنایی ارائه نمیدهد.
فریمورک Auto Ontology یک لایه معنایی میان ایجنت هوش مصنوعی و انبار داده سازمانی قرار میدهد. این نقشه خوانا برای ماشین، بهطور دقیق ثبت میکند که هر داده در کجا قرار دارد، فیلدها و شاخصها چه مفهومی دارند، چگونه باید استفاده شوند، از چه منبعی آمدهاند و با چه مفاهیمی ارتباط دارند. این فریمورک لایه مذکور را از متادادهها، آنتولوژیها و مدلهای معنایی موجود تولید میکند و سپس آن را از طریق پروتکل Model Context Protocol، رابط خط فرمان و رابط برنامهنویسی REST API دردسترس قرار میدهد.
جریان کاری این فریمورک در مراحل مشخصی سازماندهی شده است:
- کشف (Discover): استخراج خودکار آنتولوژیها از متادادههای سازمانی، اتصال به مدلهای معنایی موجود و ساخت یک گراف دانش جامع که برای ایجنتهای هوش مصنوعی قابلفهم باشد.
- تطبیق مفهومی (Ground): اتصال دقیق پرسشهای کاربر به شاخصها، موجودیتها و روابط اعتبارسنجیشده در کنار برطرف کردن تعاریف متناقض میان سیستمهای گوناگون.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
نفوذ هکرها به ۲۵ سرور حساس و دولتی؛ ردپای ابزارهای هوش مصنوعی در حملات سایبری جدید
پژوهشگران امنیتی از نفوذ مهاجمان به ۲۵ سرور در چهار کشور مختلف، از جمله سامانههای متصل به یک سازمان وابسته به دولت آمریکا خبر دادهاند. بررسیها نشان میدهد که هکرها احتمالاً با بهرهگیری از ابزارهای هوش مصنوعی مانند Claude Code و مدلهای DeepSeek، فرآیند شناسایی اهداف و نفوذ را سرعت بخشیدهاند.
ورود هوش مصنوعی به سیستم هشدارهای اضطراری؛ آیا جامعه آماده اعتماد به چتباتها است؟
انسانها در شرایط پرفشار بحران و بلایای طبیعی، اغلب در اطلاعرسانی دقیق و آرامشبخش به مردم دچار اشتباه میشوند. اکنون چتباتهای هوش مصنوعی وارد میدان شدهاند تا متن هشدارهای اضطراری را بازنویسی کنند، اما اتکای شتابزده به این ابزارها میتواند اعتماد عمومی را به خطر بیندازد.
متا از بازی Waddle World رونمایی کرد؛ حیوان خانگی هوش مصنوعی به سبک تاماگوچی
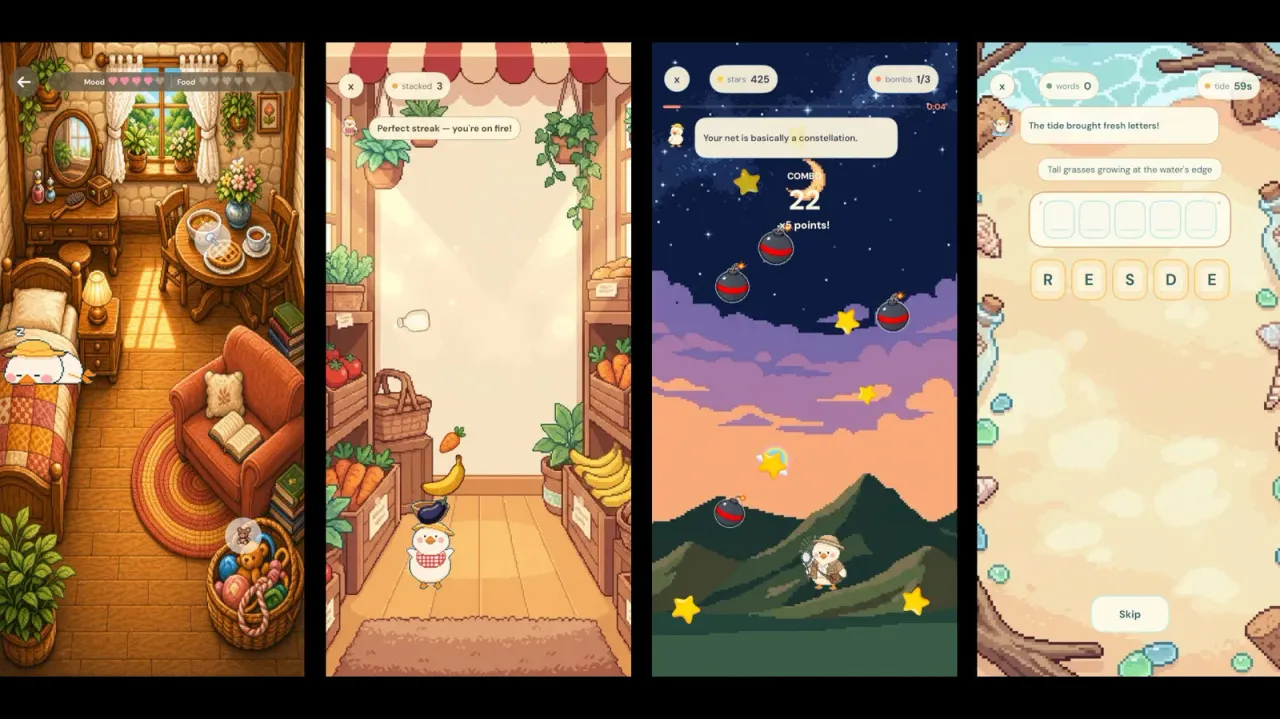
متا بازی جدیدی به نام Waddle World را بهصورت آزمایشی منتشر کرده است که یک حیوان خانگی مجازی مجهز به هوش مصنوعی را در اختیارتان میگذارد. این اپلیکیشن با ترکیب خاطرهنویسی روزانه و بازیهای تعاملی، امکان گفتگو و دریافت نقاشیهای خودکار از حیوان خانگی را برای کاربران فراهم میکند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.