مدل جدید Nemotron 3.5 Bolt انویدیا؛ اجرای ایجنتهای هوش مصنوعی با ۴ گیگابایت حافظه
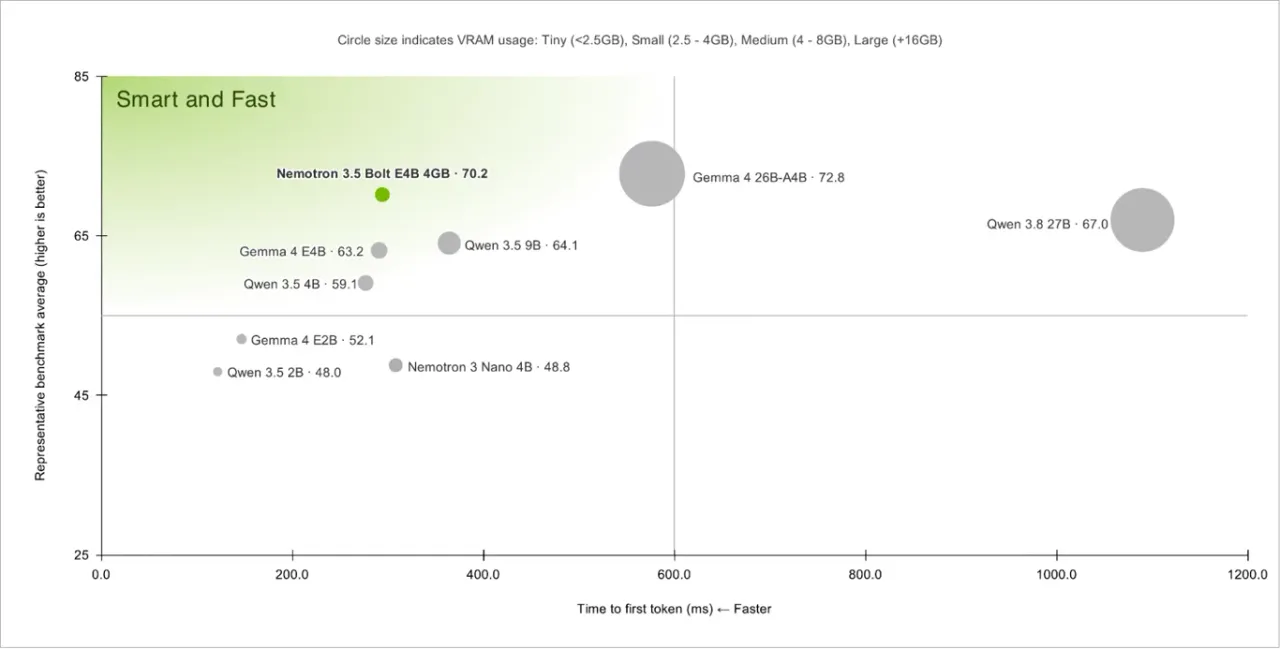
انویدیا از مدل زبانی کمحجم Nemotron 3.5 Bolt رونمایی کرد؛ مدلی بهینه که با اشغال تنها ۴ گیگابایت حافظه، امکان اجرای محلی ایجنتهای هوشمند را روی دستگاههای لبه فراهم میکند. این مدل با تولید پاسخهای بسیار کوتاهتر، سرعت پردازش را در دستیارهای صوتی و روباتها بهشکل چشمگیری افزایش میدهد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مدل زبانی Nemotron 3.5 Bolt با اشغال حدود ۴ گیگابایت رم، فضای کافی برای پردازش همزمان صدا، تصویر و منطق برنامه در سختافزارهای سبک باقی میگذارد.
- این مدل با تولید تا ۸۰ درصد کلمات کمتر نسبت به رقبا، تأخیر پاسخدهی را به حداقل رسانده و تعامل روانتری در دستیارهای صوتی و روباتها ایجاد میکند.
- اگرچه مدل رقیب Qwen 3.5 در پردازش متنهای طولانی و پشتیبانی ساختاریافته مشتریان برتری دارد، اما Nemotron 3.5 Bolt ر اجرای دستورات، حفظ نقش و فراخوانی ابزارها پیشتاز است.
انویدیا از مدل زبانی کمحجم Nemotron 3.5 Bolt رونمایی کرد؛ مدلی فشرده که بر پایه مدل Gemma 4 E4B گوگل توسعه یافته است. انویدیا این مدل را از طریق آموزشهای تکمیلی برای کاربری در ایجنتهای گفتگو، بهکارگیری ابزارها و اجرای محلی روی بوردهای Jetson، پردازندههای گرافیکی RTX و ایستگاههای کاری DGX Spark بهینهسازی کرده است.
اشغال حدود ۴ گیگابایت حافظه در زمان اجرا باعث میشود فضای رم کافی برای پردازش گفتار، بینایی ماشین، بازیابی اطلاعات و کدهای اصلی برنامه باقی بماند. این فضای خالی در سختافزارهایی مثل بورد ۸ گیگابایتی Jetson یا کارت گرافیک مصرفی ۱۲ گیگابایتی اهمیت دوچندانی دارد؛ جایی که مدل زبانی ناچار است منابع سیستم را با سایر بخشهای ساختار ایجنت به اشتراک بگذارد.
حافظه ۴ گیگابایتی؛ فضای کافی برای کل زنجیره نرمافزاری
انویدیا مدل Bolt را بر اساس رفتارها و محدودیتهای منابع در ایجنتهای تعاملی تنظیم کرده است:
- استفاده چندمرحلهای از ابزارها: پشتیبانی از فراخوانی ناهمگام ابزارها در طول مکالمه.
- حالت تعاملی و گفتگومحور: ارائه پاسخهای کوتاه و موجز که برای رابطهای صوتی ایدئال هستند.
- استدلال با قابلیت پیکربندی: امکان غیرفعالسازی یا محدود کردن فرایند استدلال بر اساس زمان پاسخدهی مجاز.
- پنجره زمینه ۶۴ هزار توکنی: فضای مناسب برای ذخیره تاریخچه گفتگو، تعریف ابزارها، دادههای بازیابیشده و وضعیت برنامه.
- پشتیبانی از ۳۵ زبان: توسعهیافته بر اساس مدلی پایهای که با بیش از ۱۴۰ زبان مختلف پیشآموزش دیده است.
بر اساس ارزیابیهای اعلامشده توسط انویدیا، مدل Bolt در آزمونهای منتخب ایجنتهای گفتگو بهطور میانگین حدود ۴۰ درصد کیفیت بالاتری نسبت به Nemotron 3 Nano 4B ارائه میدهد. همچنین این مدل در مقایسههای این شرکت تا ۸۰ درصد توکن کمتری نسبت به مدلهای همرده تولید میکند. تولید پاسخهای کوتاهتر باعث کاهش حجم محاسبات رمزگشایی، کاهش تأخیر در پاسخ و از بین رفتن وقفههای آزاردهنده در تعاملات صوتی میشود.
برتری در ایفای نقش، عقبماندگی در پردازش متنهای طولانی
انویدیا این مدل را در زمینههای مختلفی از جمله گفتگو و حفظ شخصیت، استفاده چندمرحلهای از ابزارها، کنترل دستورات، پایداری در درک متن و انطباق عملکرد ارزیابی کرده است. این شرکت عملکرد Bolt را در برابر مدلهای Qwen 3.5 4B و Gemma 4 E4B سنجیده که طی آن، مدل Bolt در اکثر آزمونهای گزارششده پیشتاز بوده است.
بنچمارک | قابلیت ارزیابیشده | Bolt E4B | Qwen 3.5 4B |
|---|---|---|---|
RoleBench | پایبندی به شخصیت تعریفشده | ۶۷٫۰ | ۵۳٫۷ |
IHEval | سلسلهمراتب دستورات | ۸۴٫۸ | ۶۰٫۶ |
RelyToolBench | صحت استفاده از ابزارها | ۶۳٫۲ | ۴۳٫۳ |
Tau2-Bench | خدمات مشتریان چندمرحلهای | ۵۵٫۱ | ۷۵٫۱ |
BFCL-v3 | فراخوانی توابع | ۶۸٫۵ | ۷۰٫۹ |
LongBench v2 | استدلال در متنهای طولانی (۴۸ هزار توکن) | ۵۰٫۵ | ۵۹٫۹ |
نتایج بنچمارکهای RoleBench ،IHEval و RelyToolBench نشاندهنده توانمندی بالای مدل در کنترل شخصیت، اجرای دستورات پیچیده و استفاده صحیح از ابزارها است. انویدیا همچنین از بهبود عملکرد این مدل در درک دستورات غیربدیهی و جریانهای کاری پیچیده ایجنتها خبر میدهد.
با این حال مدل Qwen در نتایج بنچمارک Tau2-Bench، آزمون BFCL-v3 و بنچمارک LongBench v2 در زمینه ۴۸ هزار توکن از Bolt پیشی میگیرد. این امتیازها نشان میدهد که Qwen برای جریانهای ساختاریافته پشتیبانی مشتریان، برنامههایی با فراخوانی توابع سنگین و تحلیل اسناد طولانی انتخاب مناسبتری است. هرچند پنجره زمینه مدل Bolt به ۶۴ هزار توکن میرسد، اما امتیاز به دست آمده در LongBench اثبات میکند که ظرفیت حافظه بهتنهایی ضامن استدلال دقیق در سراسر متنهای بسیار طولانی نیست.
تأخیر پردازش در دستگاههای لبه؛ چالش اصلی سرعت
نسخههای کوانتایزشده مدل امکان دستیابی به همان حجم تقریبی ۴ گیگابایتی را فراهم میکنند که در آزمایشهای سختافزاری انویدیا مورد استفاده قرار گرفت. این شرکت نسخه Q4_K_M را روی بستر llama.cpp با اندازه بچ ۱ اجرا کرد؛ آزمایشی که با پرامپتهای حاوی ۳۰۰۰ توکن ورودی و تولید ۵۰ توکن خروجی انجام شد. اجرای نسخههای اصلی با فرمت BF16 به حافظه به مراتب بیشتری نیاز دارد.
سختافزار | حافظه مصرفی مدل | زمان تا اولین توکن | سرعت تولید توکن |
|---|---|---|---|
RTX 5070 (۱۲ گیگابایت) | ۳٫۵ گیگابایت | ۵۴۸ میلیثانیه | ۱۳۳ توکن بر ثانیه |
DGX Spark (تستشده با ۳۲ گیگابایت) | ۳٫۱ گیگابایت | ۹۳۰ میلیثانیه | ۶۷ توکن بر ثانیه |
Jetson Orin Nano (۸ گیگابایت) | ۴٫۲ گیگابایت | ۵۷۸۵ میلیثانیه | ۱۵٫۵ توکن بر ثانیه |
Jetson AGX Orin (۳۲ گیگابایت) | ۴٫۲ گیگابایت | ۳۶۸۷ میلیثانیه | ۲۴ توکن بر ثانیه |
زمان ۵٫۸ ثانیهای بورد Orin Nano برای ارائه اولین توکن، میتواند در تجربه تعامل صوتی اختلال ایجاد کند. با این حال اشغال ۴٫۲ گیگابایت حافظه باعث میشود حدود نیمی از رم این دستگاه همچنان برای نرمافزارهای پردازش تصویر و سیستمهای کنترلی آزاد بماند. انویدیا این تعادل سختافزاری را در دموی ربات Reachy Mini به نمایش گذاشته است؛ پروژهای که در آن مدل Bolt همگام با مدل بینایی Cosmos 3 Edge روی یک بورد ۸ گیگابایتی Orin Nano اجرا میشود.
بهینهسازی پس از آموزش؛ راهکار انویدیا برای مهار پرگویی مدل
مدل Bolt کار خود را از معماری Gemma 4 E4B آغاز کرده و سپس آموزشهای تکمیلی را برای پیروی دقیق از دستورات، فراخوانی چندمرحلهای ابزارها و مکالمه دریافت کرده است. انویدیا از یادگیری تقویتی با پاداشهای قابل راستیآزمایی (RLVR) برای امتیازدهی به خروجیها بر اساس نتایج قابل بررسی استفاده کرد. همچنین روش یادگیری تقویتی از طریق بازخورد انسانی (RLHF) سیگنالهای ترجیحی را به مدل منتقل کرده است. هر دو فرایند روی بسترهای NeMo RL و NeMo-Gym پیادهسازی شدند.
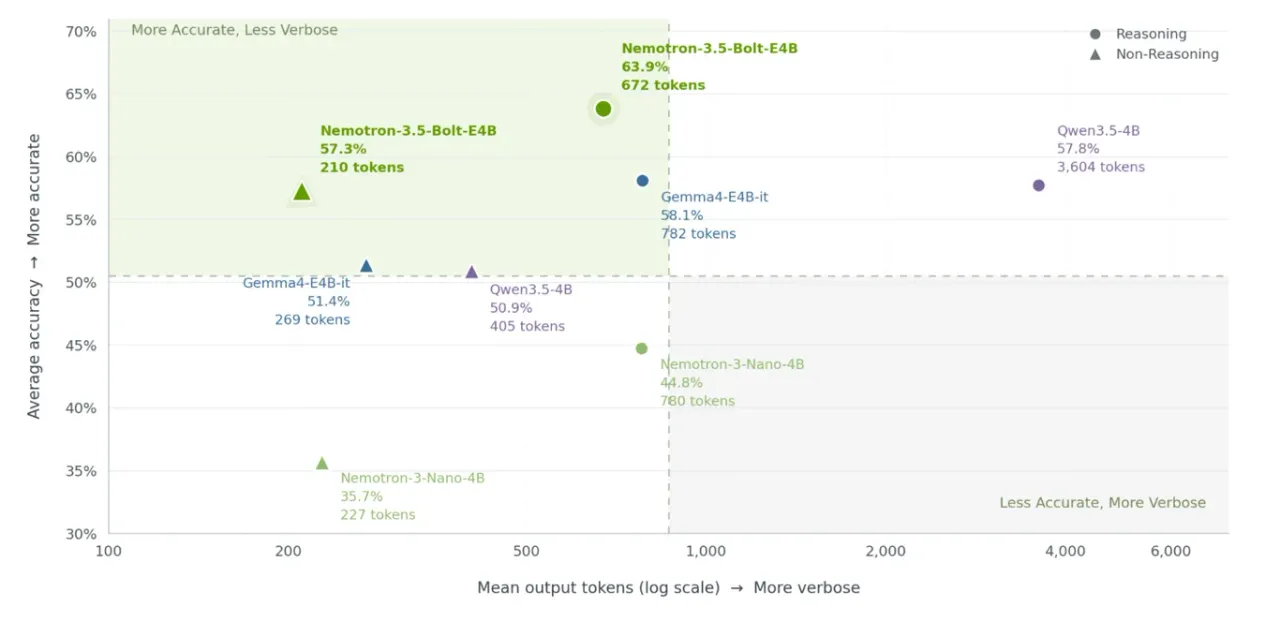
هر نمونه آموزشی در دو حالت بااستدلال و بدوناستدلال به سیستم ارائه شد، به طوری که در هر دسته، به ازای هر نمونه بااستدلال، دو نمونه بدوناستدلال قرار داشت. این ترکیب باعث میشود مدل در درخواستهای عادی ایجنتها پاسخهایی بسیار کوتاه بدهد، اما در عین حال توانایی استدلال مرحلهبهمرحله را برای کارهای دشوارتر حفظ کند.
با پیشرفت مراحل پسآموزش، زنجیره استدلالها و پاسخهای نهایی مدل طولانیتر شدند. انویدیا برای مهار این پرگویی، جریمههای متناسب با طول متن و استدلال را در محیط مدل پاداش خود افزایش داد. در نتیجه این رویکرد، مدل خروجی بهشکل چشمگیری توکنهای کمتری نسبت به سایر مدلهای مورد مقایسه تولید میکند.
برای اجرای کوانتایزاسیون به روش Q4_K_M، انویدیا ماتریس اهمیت در نرمافزار llama.cpp را با حدود یک میلیون توکن برگرفته از مراحل یادگیری تقویتی کالیبره کرد. این کالیبراسیون وزنهایی را که حساسیت بیشتری به فشردهسازی دارند شناسایی میکند و باعث میشود عملکرد نسخه فشرده به امتیازهای بنچمارک نسخه دستنخورده BF16 بسیار نزدیک باقی بماند.
تولید موازی توکنها با موتور رمزگشایی DFlash
فناوری DFlash بهعنوان پیشنویسکننده در رمزگشایی حدسی، چندین توکن پیشنهادی را تنها در یک مرحله پردازش به جلو پیشنهاد میدهد. سپس مدل Bolt این کاندیداها را بهصورت موازی اعتبارسنجی میکند، بدون آنکه توزیع آماری خروجی مدل اصلی تغییر یابد. انویدیا اعلام کرده که این روش توان پردازشی را تا ۲۱ درصد نسبت به سیستم پیشبینی چندتوکنی پیشفرض در Gemma 4 E4B افزایش میدهد؛ هرچند میزان دقیق این بهبود به نوع سختافزار، طول پرامپت و تنظیمات زمان اجرا بستگی دارد.
منابع دانلود و گزینههای پیادهسازی
انویدیا گزارش فنی، فایلهای وزن مدل و فهرست مجموعهدادههای یادگیری تقویتی را منتشر کرده است. منابع ارائهشده عبارتاند از:
- وزنهای مدل: فایلهای خروجی در فرمتهای BF16 و GGUF نسخه Q4_K_M.
- پشتیبانی از پیشنویس توکن: نسخه بهینهشده موتور DFlash با فرمت NVFP4.
- منابع آموزشی: گزارش فنی کامل، فهرست دیتاستها و مستندات NeMo RL و NeMo-Gym.
- بسترهای اجرای مدل: ابزارهای Ollama ،LM Studio ،Unsloth ،Jetson AI Lab و کیت توسعه استنتاج درونبازی انویدیا (In-Game Inferencing SDK).
توسعهدهندگان پیش از عرضه یا ادغام این مدل در محصولات خود، بهویژه هنگام بستهبندی وزنها در دستگاهها یا نرمافزارهای تجاری، باید شرایط مجوز و مقررات کاربری درجشده در شناسنامه مدل را بهدقت بررسی کنند.
انتخاب مدل مناسب بر اساس نیاز کاری
نوع کاربرد | گزینه پیشنهادی | دلیل انتخاب |
|---|---|---|
شخصیتهای بازی و ایجنتهای متکی بر هویت مستقل | Bolt E4B | نتایج قدرتمند در RoleBench و تولید پاسخهای کوتاهتر |
دستیارهای محلی و رابطهای کاربری رباتها | Bolt E4B | حجم کم نسخه کوانتایزشده و مهارت در فراخوانی ابزارها |
فرایندهای ساختاریافته در خدمات مشتریان | Qwen 3.5 4B | امتیاز بالاتر در بنچمارک Tau2-Bench |
برنامههای متکی بر توابع متعدد و سنگین | Qwen 3.5 4B | امتیاز بالاتر در آزمون BFCL-v3 |
استدلال و تحلیل متون بسیار طولانی | Qwen 3.5 4B | امتیاز برتر در آزمون LongBench v2 با ۴۸ هزار توکن |
ارزیابیهای محیط عملیاتی باید مواردی نظیر میزان موفقیت در فراخوانی ابزارها، زمان تولید نخستین توکن، توان خروجی رمزگشایی، طول پاسخها، اوج مصرف حافظه و نحوه واکنش مدل در نزدیکی سقف پنجره زمینه را روی سختافزار مقصد بررسی کنند. این سنجشهای دقیق مشخص میکنند که آیا مزایای مدل Bolt مانند اشغال ناچیز حافظه و موجز بودن پاسخها، میتواند بر برتری مدل Qwen در فرآیندهای ساختاریافته و استدلال روی متنهای طولانی غلبه کند یا خیر.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
برترین ایجنتهای هوش مصنوعی که بدون نیاز به اپلیکیشن، در پیامک گوشی شما کار میکنند
بهجای نصب دهها اپلیکیشن مختلف، نسل جدیدی از ایجنتهای هوش مصنوعی توسعه یافتهاند که کافی است به آنها پیامک بدهید تا کارهای روزمرهتان را انجام دهند. این دستیاران هوشمند برنامهریزی تقویم، خرید آنلاین و هماهنگیهای شخصی را مستقیماً از طریق صندوق پیامک یا پیامرسانها مدیریت میکنند.
قابلیت قفل چت در ChatGPT؛ ابزاری کاربردی که امنیت صددرصدی ندارد
قابلیت جدید قفل کردن چتها در ChatGPT به کاربران امکان میدهد گفتگوهای حساس خود را با رمز چهاررقمی یا بیومتریک پنهان کنند. با این حال، این ویژگی تمام روزنههای حریم خصوصی را نمیپوشاند و اطلاعات ثبتشده در حافظه هوش مصنوعی یا لینکهای اشتراکگذاریشده همچنان در دسترس باقی میمانند. برای حفظ واقعی حریم خصوصی، شناخت محدودیتهای این ابزار ضروری است.
غولهای هوش مصنوعی در یکقدمی فاجعه؛ چرا شرکتهای فناوری باید از صنعت هستهای درس بگیرند؟
شرکتهای بزرگ هوش مصنوعی بهخوبی میدانند که در صورت خطای یک بازیگر، کل این صنعت با پیامدهای سنگین حقوقی و اعتباری روبهرو خواهد شد. تاریخ نشان میدهد صنعت هستهای پس از بحرانهای بزرگ، با تکیه بر سازوکارهای خودنظارتی توانست اعتماد عمومی را حفظ کند؛ الگویی کارآمد که پیشگامان هوش مصنوعی نیز میتوانند برای مهار خطرات احتمالی از آن بهره ببرند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.