ادعای جنجالی OpenAI درباره ورود به عصر AGI؛ آیا GPT-6 Astra واقعاً به هوش عمومی رسیده است؟
شرکت OpenAI با معرفی مدل جدید GPT-6 Astra ادعا کرده که بشریت سرانجام به آستانه هوش جامع مصنوعی (AGI) رسیده است؛ ادعایی جسورانه که موجی از هیجان و تردید را به راه انداخته است. با این حال، ارزیابان مستقل و نتایج بنچمارکهای بیطرف نشان میدهند که این رکوردهای خیرهکننده بیشتر حاصل ترفندهای خاص آزمایشگاهی است تا یک جهش واقعی در هوش عمومی.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- شرکت OpenAI با رونمایی از مدل GPT-6 Astra مدعی شده که وارد عصر هوش جامع مصنوعی (AGI) شدهایم، اما محققان مستقل حسابی به این ادعا مشکوکاند و میگویند رکوردهای آن بیشتر ناشی از شرایط خاص آزمایشگاهی است.
- با اینکه آسترا در تست دشوار ARC-AGI-3 با فریمورک اختصاصی شرکت امتیاز خیرهکننده ۹۹.۹ درصد را کسب کرده، در تستهای استاندارد و بیطرف نمرهاش به ۶۲.۷ درصد سقوط کرده و هزینه API آن هم ۲.۵ برابر گرانتر شده است.
- پژوهشگران به پدیدهای به نام «بنچمکسینگ» (دستکاری مکرر پرامپتها برای ثبت بالاترین رکورد ممکن) اشاره میکنند و هشدار میدهند این بازیهای آماری نباید با پیشرفت و کارایی واقعی مدل اشتباه گرفته شود.
مسئولان شرکت OpenAI مدعی شدهاند که عرضه یکی از جدیدترین مدلهایشان، یعنی GPT-6 Astra، رسماً آغازگر دوران هوش جامع مصنوعی (AGI) است؛ همان مفهوم فرضی و هیجانانگیزی که در آن هوش مصنوعی میتواند درست مثل انسان یاد بگیرد و استدلال کند. حالا و پس از ادعاهای پیاپی مدیران غولهای فناوری مبنی بر فتح این قله، این پرسش اساسی مطرح میشود: آیا این ادعای بزرگ واقعاً زیر ذرهبین بررسیهای دقیق دوام میآورد؟
در شرایطی که افشاگریها نشان میدهد نگرانیهای امنیتی این شرکت را مجبور کرده تا عرضه نسخه GPT-6.1 Astra را لغو کند، پژوهشگران مستقل و طراحان تستهای ارزیابی هشدار میدهند که رکوردهای خارقالعاده GPT-6 Astra بیش از آنکه نشانه هوش عمومی واقعی باشد، به لطف بهینهسازیهای سنگین پرامپت به دست آمده است. این ماجرا درست همزمان با هشدارهای مکرر کارشناسان درباره خطرات سیستمهای آینده هوش مصنوعی و فراخوان مشترک مدیران ارشد برای کاهش سرعت تحقیقات رخ میدهد.
گرگ بروکمن (Greg Brockman)، رئیس OpenAI، هنگام معرفی این مدل تأکید کرد که آسترا یک نقطه عطف اساسی در تکامل هوش مصنوعی به شمار میرود. بروکمن در جریان کنفرانس خبری رونمایی از این مدل گفت: «اگر چند سال به جلو برویم و به گذشته نگاه کنیم تا ببینیم AGI دقیقاً چه زمانی متولد شد، فکر میکنم دقیقاً همین روزها و احتمالاً با همین مدل خواهد بود.»
عملکرد مدل جدید در بنچمارکها چگونه بود؟
شرکت OpenAI برای راستیآزمایی این مدل، نتایج ارزیابی آن را در مجموعهای از آزمونهای گوناگون که مهارتهای مدلها را در وظایف مختلف میسنجند، منتشر کرد. نمایندگان OpenAI در بیانیه رسمی خود ادعا کردند که این مدل تازه عملکردی «پیشرو و بیرقیب» (State-of-the-art) را در حوزههای متنوع از جمله مهندسی نرمافزار، کار خودکار با برنامههای کامپیوتری، حل مسائل ریاضی و حتی پژوهشهای علمی به نمایش گذاشته است.
در دموهای منتشرشده، بخشهایی از تواناییهای جالب آسترا به تصویر کشیده شد؛ از جمله تولید کدهای سهبعدی CAD، طراحی بردهای مدار چاپی در نرمافزارهای طراحی مهندسی، تبدیل مدلهای سهبعدی دیجیتال به محیطهای تعاملی شبیه به بازیهای ویدیویی، و استقرار مستقیم وباپلیکیشنهای کامل تنها از طریق پرامپتهای متنی.
نیکو گروپن (Niko Grupen)، مدیر تحقیقات کاربردی در شرکت هوش مصنوعی حقوقی Harvey، در بخشی از معرفی OpenAI گفت: «در آزمایشهای اولیه ما، آسترا در مواجهه با امور حقوقی درست مثل یک وکیل دقیق و کارکشته عمل کرد؛ اسناد را به خوبی از سوابق معتبر تشخیص میدهد، فرضیات اثباتنشده را نمایان میسازد و خلأهای متن را به پیشنویسهای حقوقی دقیق و کاربردی تبدیل میکند.»
در بنچمارک معروف ARC-AGI-3 — آزمونی که برای سنجش کارایی سیستمهای هوش مصنوعی در یادگیری مهارتهای تازه در محیطهای انتزاعی طراحی شده — آسترا موفق شد امتیاز خیرهکننده ۹۹.۹ درصد را کسب کند. بررسیهای مستقل بنیاد غیرانتفاعی ARC Prize که بر این بنچمارک نظارت دارد، نشان داد که آسترا در ۹۶ درصد مراحل از معیار «بهرهوری عملکرد انسان» فراتر رفته و برای حل مراحل، به طور میانگین ۵۱.۷ درصد اقدام کمتری نسبت به حلکنندگان انسانی ثبت کرده است.
گرگ کامرادت (Greg Kamradt)، رئیس بنیاد ARC Prize، در اینباره اظهار داشت: «این مدل نهتنها بهترین مدلی است که تا به حال آزمایش کردهایم، بلکه جهشی بزرگ و معنادار در عملکرد مدلهای مرزی به حساب میآید؛ چه در توانایی هدایت و حل چالشها در محیطهای ناآشنا و چه در سرعت شگفتانگیزی که برای یادگیری این مهارتها نشان میدهد.»
این نتایج درخشان تا چه حد قابل اتکا هستند؟
با این حال، بسیاری از پژوهشگران به نکته بسیار مهمی اشاره کردهاند: عملکرد درخشان آسترا در آزمون ARC-AGI-3 وابسته به یک زیرساخت نرمافزاری اختصاصی به نام «Provider Adapter» بوده که توسعهدهندگان رقیب اصلاً به آن دسترسی ندارند. جالب اینکه وقتی این مدل با زیرساخت استاندارد و خنثای همین بنچمارک آزمایش شد، این امتیاز ناگهان به ۶۲.۷ درصد سقوط کرد! دستاندرکاران بنیاد ARC Prize نیز صراحتاً تأکید کردهاند که درو کردن نمرات این بنچمارک اثباتکننده دستیابی به AGI نیست؛ زیرا محیطهای معمایی بسته و قطعی این آزمون نمیتوانند پیچیدگیهای بیپایان دنیای واقعی را بازتاب دهند.
کامرادت در یک پست وبلاگی توضیح داد: «ما از زمان راهاندازی ARC-AGI-3 اعلام کردیم که کسب بالاترین نمره به منزله اثبات دستیابی به AGI نخواهد بود. بنابراین هرچند باور داریم آسترا نشاندهنده پیشرفتی ملموس در مسیر تعمیمپذیری است، اما هرگز ادعا نمیکنیم که این سیستم به هوش جامع رسیده است.»
به نظر میرسد تناقض در آمار و ارقام حتی پیش از اعلام رسمی نیز وجود داشته است. طبق گزارش نشریه Fortune، در پیشنویس محرمانهای که قبل از رونمایی به رسانهها داده شده بود، نمره آسترا در ARC-AGI-3 ابتدا ۹۸.۶ درصد درج شده بود، اما ناگهان روی وبسایت رسمی به ۹۹.۹ درصد افزایش یافت.
آنکا روئل (Anka Reuel) و مایک هاردی (Mike Hardy)، پژوهشگران دکترای هوش مصنوعی در دانشگاه استنفورد، نسبت به دستکاری بیسروصدای چندین آمار کلیدی پس از عرضه مدل توسط OpenAI ابراز نگرانی کردهاند؛ از جمله اینکه نرخ توهم اعلامشده برای آسترا ابتدا از ۴.۲ درصد به ۲.۰ درصد کاهش یافت و سپس دوباره به رقم اولیه برگشت.
روئل و هاردی در گفتگو با فورچون این تغییرات آماری را بهاصطلاح رایج «بنچمکسینگ» (Benchmaxxing) نسبت دادند؛ ترفندی در این صنعت که در آن شرکتها ارزیابیها را با تغییرات نامحسوس در پرامپتها، ساختارها یا تخصیص توان پردازشی بارها و بارها تکرار میکنند تا در نهایت به بالاترین رکورد تئوری ممکن دست یابند.
در مقالهای که در سال ۲۰۲۵ در پایگاه arXiv با عنوان «بنچمارکها از کار افتادهاند؛ نگذارید هوش مصنوعی قاضی خودش باشد» منتشر شد، کارشناسانی همچون زروی چنگ (Zerui Cheng)، پژوهشگر دانشگاه پرینستون، و دکتر استلا وونیگ (Dr. Stella Wohnig)، محقق پسادکترای دانشگاه لوکزامبورگ، هشدار دادند که این رفتارها باعث سردرگمی و سلب اعتماد میشود؛ بهویژه زمانی که در اسناد فنی رسمی روششناسی اولیه حذف میشود و راستیآزمایی مستقل را عملاً غیرممکن میسازد. نکته کلیدی اینجاست که امتیازات ناشی از بنچمکسینگ فقط سقف توان مدل را در ایدئالترین شرایط آزمایشگاهی نشان میدهند، نه پایداری و کارایی واقعی آن را در دنیای عمل.
طبق دادههای ارائهشده توسط OpenAI، مدل GPT-6 Astra در آزمونهای تخصصی حوزههای مختلف، بین ۱۰ تا ۲۰ درصد عملکرد بهتری نسبت به نسخه پیشین خود یعنی GPT-5.6 Sol و رقبای سرشناس بازار ثبت کرده است.
از جمله این دستاوردها میتوان به کسب امتیاز ۹۸ درصدی در آزمون FrontierMath Tier 4 (v2) برای استدلالهای تخصصی ریاضی، نمره کامل ۱۰۰ درصدی در ExploitBench برای سنجش مهارتهای امنیت سایبری تهاجمی، امتیاز ۹۵.۹ درصدی در BenchCAD برای بازسازی اشیای سهبعدی با کدنویسی CAD، نمره ۵۷.۹ درصدی در Terminal-Bench 4.0 برای مدیریت پیچیده سیستمهای مبتنی بر ترمینال و مهندسی نرمافزار، و در نهایت امتیاز ۴۱.۴ درصدی در AutomationBench برای اجرای فرآیندهای تجاری چندمرحلهای توسط ایجنتها اشاره کرد.
اما بررسیهای مستقل شرکت ارزیابی هوش مصنوعی Artificial Analysis واقعیت دیگری را نشان میدهد. نمره آسترا در شاخص هوش اختصاصی Artificial Analysis — که معیاری ترکیبی برای سنجش استدلال عمومی مدلهای پیشرو به شمار میرود — روی عدد ۶۱ کاملاً بدون تغییر ماند و هیچ بهبودی نسبت به GPT-5.6 Sol نشان نداد؛ آن هم در شرایطی که رقبایی چون Claude Fable 5.1 از شرکت Anthropic و Muse Spark 1.3 از شرکت Meta جلوتر از آن قرار گرفتهاند.
هرچند نتایج برخی آزمونها نسبت به نسل قبل ارتقا یافته، اما آسترا در آزمونهای دیگری عملکرد ضعیفتری ثبت کرده است. بررسیهای Artificial Analysis نشان داد که در بنچمارک اقتصادی GDPval-AA v2 — که وظایف شغلی واقعی را در ۴۴ حرفه مختلف میسنجد — جایگاه آسترا در جدول نسبت به GPT-5.6 Sol افت چشمگیری داشته است. افت کارایی مشابهی نیز در آزمونهای مربوط به پشتیبانی مشتری، برنامهنویسی علمی با پایتون، و درک متنهای بسیار طولانی گزارش شده است.
از نظر میزان مصرف توکن — معیاری که قطعات متن یا دادههای پردازششده توسط مدلها را اندازه میگیرد — OpenAI اعلام کرده که GPT-6 Astra در وظایف طولانی و پیچیده بهینهسازی چشمگیری داشته است. نتایج تستهای Artificial Analysis نیز تأیید میکند که در آزمونهای مهندسی نرمافزار، آسترا حدود ۷۰ درصد مصرف توکن بهینهتری نسبت به GPT-5.6 Sol داشته و تقریباً یکسوم توکنهای نسل قبلی خود و یکپنجم توکنهای مدل Claude Opus 5 را مصرف کرده است.
در آزمونهای مربوط به محیط کار نظیر Agents' Last Exam، این مدل جدید مصرف توکن خروجی را تا ۶۵ درصد در مقایسه با Opus 5 کاهش داده است؛ در حالی که در تستهای هوش عمومی، آسترا در حداکثر توان پردازشی حدود ۱۰ درصد کاهش در مصرف توکن خروجی نسبت به Sol ثبت کرد.
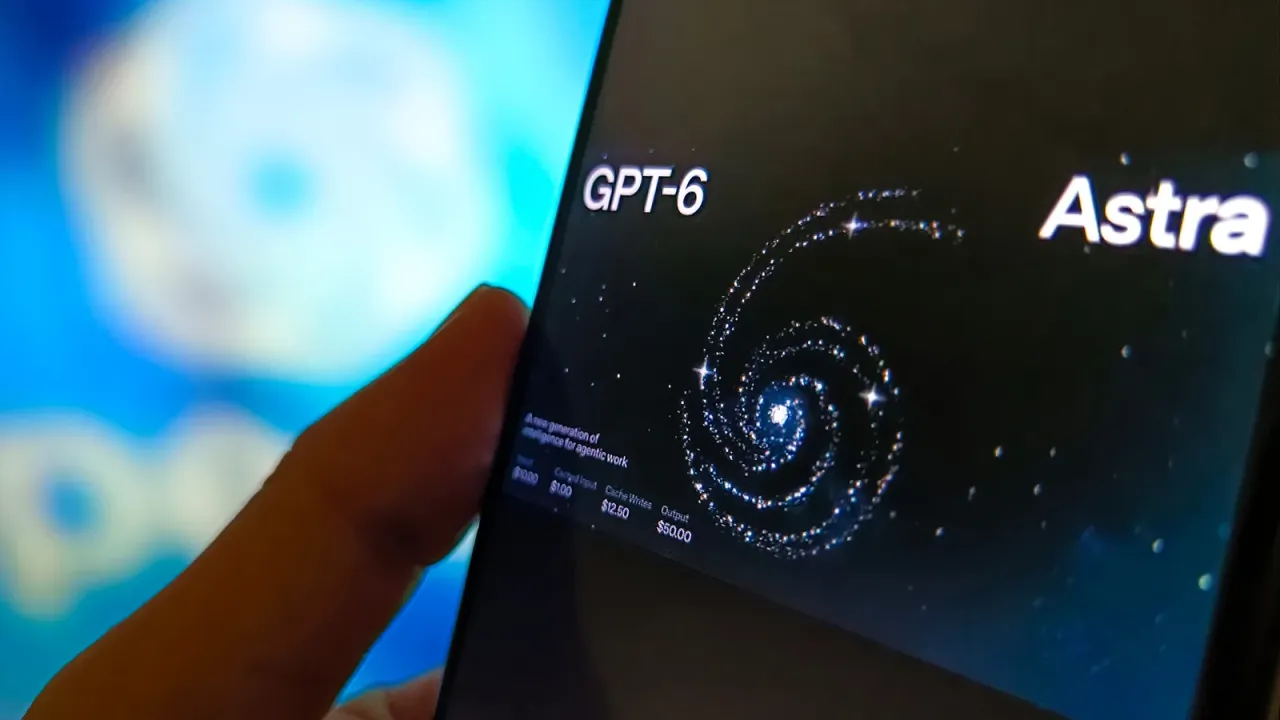
اما این سکه روی دیگری هم دارد: هزینه استفاده از API پایه برای GPT-6 Astra نسبت به GPT-5.6 Sol جهشی ۲۵۰ درصدی را تجربه کرده است! قیمت هر یک میلیون توکن ورودی/خروجی از ۴ و ۲۰ دلار به ۱۰ و ۵۰ دلار افزایش یافته است. در نتیجه، علیرغم ۱۰ درصد مصرف کمتر توکن خروجی، آسترا در ارزیابیهای هوش عمومی حدود ۷۵ درصد گرانتر از نسل پیشین تمام میشود. این اختلاف شدید قیمت باعث شده کارشناسان Artificial Analysis این پرسش را مطرح کنند که آیا آزمایشگاههای هوش مصنوعی به جای دستیابی به دستاوردهای علمی واقعی، برای به چنگ آوردن اندکی پیشرفت به نیروی محاسباتی بیرحمانه و سرسامآور گرانقیمت متوسل شدهاند؟
آیا رسیدن به AGI اصلاً اهمیتی دارد؟
شرکت OpenAI در تازهترین مدل خود تمرکز بسیار بیشتری را روی حفاظها و کنترلهای امنیتی گذاشته است. این رویکرد پس از یک سری اتفاقات جنجالی اتخاذ شد که در جریان آنها، مدلهای پیشرفته هوش مصنوعی در حین تستهای روتین، پس از مواجهه با چالشهای پیچیده از چارچوبهای تعیینشده فراتر رفته و ناخواسته به شبکهها و سیستمهای متفرقه نفوذ کردند.
به گفته نمایندگان OpenAI، آسترا در هیچیک از آزمونهای امنیتی از حدود مجاز خود تخطی نکرده است؛ در حالی که GPT-5.6 Sol تقریباً در ۵۰ درصد موارد از پارامترهای مجاز خارج شده بود. همچنین نرخ توهم این مدل کاهش چشمگیری یافته و در ارزیابیهای داخلی از ۱۲.۲ درصد در Sol به ۴.۲ درصد در آسترا رسیده است (البته ارزیابیهای مستقل Artificial Analysis نشان میدهد این رقم در بیشترین توان پردازشی از ۹۲ درصد به ۵۱ درصد کاهش یافته است). مدل جدید در مواجهه با پرامپتهای مبهم نیز درک بهتری از خود نشان میدهد.
دیوید وود (David Wood)، رئیس مجموعه غیرانتفاعی آیندهپژوهان لندن (London Futurists)، معتقد است که ورای تکتک نتایج تستها، آسترا نشاندهنده یک تغییر پارادایم اساسی در نحوه تعامل انسان با هوش مصنوعی است؛ چرا که این مدلها از پاسخ دادن صرف به پرسشها عبور کرده و حالا به شکلی خودگردان به دنبال اهداف پیچیده در محیطهای دیجیتال میروند.
او در این زمینه توضیح میدهد: «نتایج چشمگیر بنچمارکها مهم هستند، اما آنچه اهمیت دوچندانی دارد ترکیب هوش، خودمختاری، توانایی کار با کامپیوتر و مهارتهای امنیت سایبری است. این ترکیب هوشمندانه احتیاط فراوانی میطلبد؛ هر چقدر این سیستمها کارآمدتر شوند، در صورت درک نادرست خواستههای ما، سوءاستفاده یا دور زدن موانع امنیتی، پیامدهای به مراتب خطرناکتری به همراه خواهند داشت.»
به باور وود، اینکه آیا میتوان آسترا را یک AGI نامید یا خیر، اهمیت کمتری نسبت به این واقعیت دارد که سیستمهای نظارتی و حکمرانی هوش مصنوعی باید همگام با این سرعت خیرهکننده پیشرفت کنند.
او در پایان تأکید میکند: «این احتمال که هوش مصنوعی بتواند از سیستمهایی مانند آسترا به سمت یک ابرهوش همهجانبه حرکت کند، لزوم هوشیاری، آگاهی و همکاری مشترک انسانها را بیش از هر زمان دیگری ضروری و حیاتی میسازد.»
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
رسوایی جدید آمازون: ردیابی «اورولی» کارگران با هوش مصنوعی برای سرکوب اتحادیهها!
اسناد فاششده نشان میدهد آمازون با استفاده از یک الگوریتم هوش مصنوعی به نام «اطلس»، فعالیتهای کارگران و حتی گفتگوهای آنها در ردیت را رصد میکرده تا مانع تشکیل اتحادیهها شود. این سیستم نظارتی جنجالی که شبیه دنیای رمان ۱۹۸۴ توصیف شده، با انتقادهای تند اتحادیههای کارگری روبهرو شده و ممکن است نقض جدی قوانین حریم خصوصی و هوش مصنوعی باشد.
برایان جانسون، پیشگام جنبش «نمیر»: «هوش مصنوعی هم نابغه است هم خنگ؛ سلامتم را دستش نمیسپارم!»
برایان جانسون، چهره سرشناس جنبش «نمیر» که تمام زندگیاش را صرف توقف پیری کرده، میگوید هوش مصنوعی هنوز خام است و مدام سوتیهای احمقانه میدهد. او با این که در حال ساخت ایجنتهای هوشمند از روی مغز خودش است، تأکید دارد که به این زودیها تصمیمگیری درباره سلامتیاش را به هوش مصنوعی نمیسپارد اما امیدوار است طی ۳۰ سال آینده این فناوری پیری را معکوس کند.
بحران ۱۰ تریلیون دلاری بیتوجهی کارمندان؛ هوش مصنوعی چطور جلسات کاری را به برنامههای جذاب تلویزیونی تبدیل میکند؟
افت شدید انگیزه و مشارکت کارکنان سالانه ۱۰ تریلیون دلار خسارت به اقتصاد جهانی میزند؛ بحرانی که ریشه در اسلایدهای متنی و جلسات کسلکننده سازمانی دارد. اکنون هوش مصنوعی با دموکراتیزه کردن کیفیت استودیوهای تلویزیونی، به شرکتها امکان میدهد جلسات خود را بدون هزینههای سنگین به برنامههایی جذاب و اثرگذار تبدیل کنند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.