فراتر از کدنویسی؛ معیار جدید LifeVal از OpenAI عملکرد هوش مصنوعی را در کارهای روزمره میسنجد
شرکت OpenAI از فریمورک ارزیابی داخلی جدیدی به نام LifeVal رونمایی کرده است که مهارت مدلهای هوش مصنوعی را در انجام کارهای واقعی و روزمره زندگی میسنجد. این معیار جدید برخلاف آزمونهای سنتی کدنویسی و ریاضی، توانایی دستیارهای هوشمند را در درک ترجیحات فردی، مدیریت بودجه و هماهنگی امور شخصی ارزیابی میکند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- شرکت OpenAI فریمورک ارزیابی داخلی LifeVal را برای سنجش توانایی مدلهای هوش مصنوعی در انجام امور روزمره شخصی مانند انتخاب مدرسه، برنامهریزی غذایی و مدیریت بودجه معرفی کرد.
- این سیستم ارزیابی بهجای بررسی ساده کلیکها یا مراحل طیشده، کیفیت نهایی پاسخ و میزان انطباق آن با محدودیتها و ترجیحات اختصاصی کاربر را ملاک نمره قرار میدهد.
- با وجود خصوصی بودن این بنچمارک برای عموم، توسعهدهندگان میتوانند از الگوی سناریومحور آن برای آزمایش دقیق دستیارهای هوشمند در محصولات تجاری خود بهره ببرند.
شرکت OpenAI فریمورک ارزیابی داخلی جدیدی به نام LifeVal را معرفی کرده است؛ سیستمی که با هدف سنجش میزان موفقیت مدلها در مدیریت امور شخصی طراحی شده است؛ اموری مانند یافتن مدرسه مناسب پس از اسبابکشی، برنامهریزی وعدههای غذایی برای فردی مبتلا به دیابت یا هماهنگی نیروهای داوطلب پیش از وقوع سیلاب. به گفته این شرکت، این بنچمارک در طول یک سال گذشته نقشی کلیدی در هدایت روند توسعه مدلها ایفا کرده است.
معیار LifeVal خلأ بزرگی را در آزمایشهای رایج هوش مصنوعی هدف قرار میدهد. بنچمارکهای مرسوم در زمینههای کدنویسی، ریاضیات و ناوبری مرورگرها معمولاً معیارهای اتمام کاملاً مشخصی دارند، در حالی که کارهای شخصی روزمره بهشدت به سلیقهها، بودجهها، زمانبندیها، موقعیت جغرافیایی و سایر محدودیتهای فردی وابسته هستند. در چنین سناریوهایی، یک مدل ممکن است تمام کلیکها و مراحل لازم را به درستی انجام دهد، اما در نهایت خروجی نامناسبی به کاربر تحویل دهد.
از یادداشتهای روزانه تا سناریوهای آزمایشی
تیم OpenAI کار خود را با تحلیل مجموعهدادههای نحوه گذران زمان آغاز کرد؛ از جمله نظرسنجی گذران وقت اداره آمار کار آمریکا و مطالعه چندملیتی استفاده از زمان. از آنجا که بسیاری از فعالیتهای روزمره مانند خوابیدن یا غذا خوردن فضایی برای واگذاری به هوش مصنوعی نداشتند، این شرکت تصمیم گرفت درخواستهای واقعی را مستقیماً از کاربران جمعآوری کند.
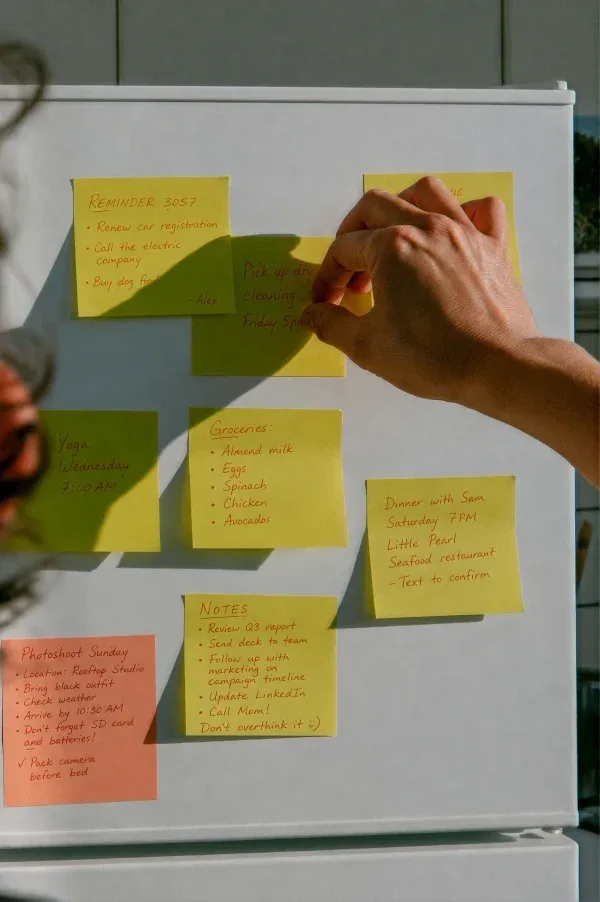
بر اساس اعلام OpenAI، این شرکت ابتدا از حدود ۴٬۰۰۰ نفر نظرسنجی کرد و سپس از گروه کوچکتری متشکل از تقریباً ۱۰۰ کاربر خواست وظایفی را که مایلاند یک دستیار هوش مصنوعی انجام دهد، با جزئیات ثبت کنند. شرکتکنندگان همچنین اطلاعات زمینهای و فردی لازم برای هر درخواست را ارائه دادند. بهعنوان نمونه، جستجوی یک مدرسه مناسب تنها با نوشتن نام مدرسه حل نمیشود، بلکه به نشانی، سقف شهریه، مسافت رفتوآمد، ساعات فعالیت و نیازهای اختصاصی کودک وابسته است.
نمرهدهی به نتیجه نهایی
معیار LifeVal وظایفی را در بر میگیرد که شاید نیازمند تحلیل تاریخچه گفتگوها، جستجو در وبسایتها، تلفیق اطلاعات از چندین منبع گوناگون و در نهایت پیشنهاد نتیجهای کاملاً متناسب با شرایط شخصی کاربر باشند. سناریوهای تحت پوشش این بنچمارک شامل موارد زیر است:
- جستجوی آپارتمان و هماهنگیهای لازم برای اسبابکشی
- مراقبت از کودک و انتخاب مدرسه مناسب
- خدمات دولتی و پر کردن فرمهای آنلاین
- مدیریت امور مالی خانواده و بودجهبندی
- خرید مایحتاج منزل و برنامهریزی وعدههای غذایی
- مراقبت از اعضای بیمار یا سالخورده خانواده
- برنامهریزی محلی و هماهنگی نیروهای داوطلب
در این سیستم، شیوهنامههای ارزیابی ویژه هر سناریو جایگزین مفهوم سنتی یک پاسخ صحیح واحد شدهاند. برای مثال، شیوهنامه جستجوی مدرسه مواردی چون شهریه، فاصله، برنامه زمانی، شرایط پذیرش و خدمات مدنظر را میسنجد؛ در حالی که در سناریوی خرید مایحتاج، مواردی مانند محدودیتهای غذایی، قیمت، مقدار و در دسترس بودن اقلام انتخابشده بررسی میشوند. این رویکرد بهجای ارزیابی اینکه آیا مدل صرفاً توالی مراحلی را طی کرده است یا خیر، رضایتبخش بودن واقعی نتیجه نهایی برای کاربر را میسنجد.
یک تابلوی امتیازات داخلی
معیار LifeVal در حال حاضر یک سیستم ارزیابی اختصاصی در کنترل OpenAI است و یک بنچمارک عمومی و قابل بازتولید بهشمار نمیرود. پژوهشگران مستقل به مجموعه کامل وظایف، دادههای آزمایشی پنهان، ضریب وزنی معیارها، کالیبراسیون سیستم نمرهدهی، محیط مرور وب یا خطمشیهای تلاش مجدد مدل دسترسی ندارند. علاوه بر این، استفاده مکرر از این بنچمارک در طول فرایند توسعه مدل، تفکیک دقیق دادههای تنظیم دقیق از آزمونهای اعتبارسنجی را از اهمیت بالایی برخوردار میکند.
مقایسه عادلانه درصدهای موفقیت مدلها نیازمند در نظر گرفتن شرایط دقیق فنی است. متغیرهایی مانند نسخه دقیق مدل، میزان توان پردازشی صرفشده برای استدلال، دسترسی به ابزارها، سقف توکنها، تأخیر پاسخگویی، تعداد تلاشها و شیوه نمرهدهی نقش مستقیمی در امتیاز دارند. انتخاب بهترین نتیجه از میان سطوح مختلف پردازشی میتواند امتیازی در بالاترین حد ممکن ارائه دهد که هزینه بهرهبرداری آن در دنیای واقعی بسیار بیشتر از یک پیکربندی ثابت در محیط عملیاتی خواهد بود.
ادعاهایی که درباره دستیابی مدلی موسوم به «GPT-6 Astra» به امتیازهای مشخص در LifeVal مطرح شده است، در مستندات رسمی OpenAI هیچ پایهای ندارد. اطلاعات منتشرشده درباره این بنچمارک چنین مدلی یا درصدهای منتسب به آن را تأیید نمیکند. مقایسههای معتبر در این حوزه همواره نیازمند ارائه نتایج ثبتشده برای نسخههای رسمی مدلها و محیطهای آزمایشی شفاف و قابل تکرار است.
پرسش توسعهدهندگان | پاسخ فعلی |
|---|---|
شرکت OpenAI دقیقاً چه چیزی را معرفی کرده است؟ | یک فریمورک ارزیابی داخلی برای سنجش کارهای شخصی وابسته به شرایط و جزئیات فردی. |
آیا توسعهدهندگان میتوانند این آزمون را اجرا کنند؟ | شرکت OpenAI مجموعه دادههای قابل دانلود یا تابلوی ردهبندی عمومی برای این بنچمارک منتشر نکرده است. |
آیا این خبر تغییری در API ایجاد میکند؟ | در این اطلاعیه هیچ اندپوینت جدید، تغییر قیمت یا تضمین خاصی درباره عملکرد مدلها اعلام نشده است. |
تیمهای توسعه چه الگوهایی را میتوانند به کار بگیرند؟ | طراحی سناریوهای واقعگرایانه، ثبت محدودیتهای صریح کاربر و شیوهنامههای ارزیابی متمرکز بر کیفیت خروجی. |
از بازدهی کاری تا هماهنگی امور منزل
فریمورک LifeVal در واقع مکمل فریمورک GDPval بهشمار میرود؛ سیستم ارزیابی دیگری از OpenAI که کارهای دارای ارزش اقتصادی را در مشاغل و صنایع گوناگون میسنجد. فریمورک GDPval خروجیهایی مشابه وظایف تخصصی و حرفهای در محیط کار را بررسی میکند، در حالی که LifeVal بر تصمیمگیریهای خانگی، انجام کارهای روزمره، مراقبت از اعضای خانواده و امور اداری و شخصی تمرکز دارد.
بنچمارکهای کار با کامپیوتر مانند OSWorld و WebArena عمدتاً این موضوع را میسنجند که آیا یک ایجنت هوش مصنوعی میتواند نرمافزارها را به کار بیندازد و مراحل کار با مرورگر را تکمیل کند یا خیر. در مقابل، LifeVal این ارزیابی را به میزان تناسب و مطلوبیت واقعی خروجی نهایی گسترش میدهد. این تفاوت برای ایجنتهایی که توانایی ثبت فرمها، خرید کالا یا اقدام بر اساس اطلاعات حساس و ذخیرهشده کاربران را دارند، اهمیتی حیاتی پیدا میکند.
تبدیل معیار سنجش به آزمونهای اختصاصی محصول
تیمهایی که در حال ساخت دستیارهای هوشمند هستند، حتی بدون دسترسی مستقیم به این بنچمارک اختصاصی میتوانند از الگوهای ارزیابی LifeVal بهره ببرند:
- جمعآوری درخواستهای واقعی با رضایت کاربران: محدودیتها و شرایطی را که کیفیت یک پاسخ را تعیین میکنند حفظ کنید، اما ذخیرهسازی دادههای شخصی افراد برای مقاصد آزمایشی را به کمترین میزان برسانید.
- تدوین شیوهنامههای اختصاصی برای هر سناریو: الزامات قطعی، تطابق با سلیقه کاربر، کیفیت منابع، تکمیل موفق وظیفه و فرضیات اثباتنشده مدل را بهشکل مجزا نمرهدهی کنید.
- تثبیت پیکربندی در زمان اجرا: نسخه دقیق مدل، پرامپت سیستمی، ابزارهای در دسترس، تنظیمات توان استدلال، تعداد دفعات تلاش مجدد، مصرف توکن، میزان تأخیر و محیط مرورگر را دقیقاً ثبت و مستند کنید.
- آزمایش با اطلاعات قدیمی و متناقض: نمایههای کاربری و تاریخچه چتها ممکن است شامل ترجیحات منقضیشده، جزئیات ناقص یا دستورالعملهای ضدنقیض باشند؛ بنابراین مدل را در چنین شرایطی به چالش بکشید.
- الزام به تأیید کاربر در اقدامات حساس: انجام خریدهای مالی، تصمیمگیریهای پولی، ارسال درخواستهای دولتی و برنامهریزیهای بهداشتی و درمانی حتماً باید دارای مراحل بازبینی شفاف و راههای جبران خطا باشند.
ارزیابیها در محیط عملیاتی باید علاوه بر این، خطاهای ناشی از ابزارها، اصلاحات انجامشده توسط کاربر، وظایف رهاشده، اقدامات ناامن، تأخیر پاسخگویی و هزینهها را نیز ثبت و پایش کنند. این شاخصها نشان میدهند که آیا پیشرفت یک مدل در یک بنچمارک داخلی، واقعاً به بهبود کارایی آن در یک محصول واقعی و تجربه کاربران منجر میشود یا خیر.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
انتقاد مقام ارشد مالی نیویورک از ساختار عرضه اولیه Anthropic و کاهش قدرت سهامداران
مقام ارشد مالی نیویورک از ساختار حاکمیتی Anthropic در فرایند عرضه عمومی سهام انتقاد کرد و آن را زنگ خطری برای تضعیف حقوق سهامداران دانست. این سازوکار به بنیانگذاران اجازه میدهد حتی پس از ورود به بورس، کنترل مطلق تصمیمگیریها را حفظ کنند. صندوق بازنشستگی نیویورک خواستار تعلیق این عرضه اولیه تا زمان رفع نگرانیهای ایمنی شده است.
کاوش در اعماق اقیانوس؛ چین با هوش مصنوعی و رباتها به سراغ کشف تاریخ باستان میرود
دولت چین در برنامه پنجساله باستانشناسی خود قصد دارد با بهرهگیری از هوش مصنوعی، رباتهای اعماق دریا و تحلیل DNA باستانی، به کاوش در بقایای کشتیهای غرقشده و شهرهای تاریخی بپردازد. این راهبرد به پژوهشگران امکان میدهد تا قطعات خردشده آثار باستانی را بازسازی مجازی کنند و مسیرهای تجارت دریایی باستان را با دقتی بیسابقه مورد کاوش قرار دهند.
دانشگاه برگن از GsCNN رونمایی کرد؛ معماری جدید هوش مصنوعی برای پردازش دقیق دادههای کروی
محققان دانشگاه برگن با معرفی معماری جدید GsCNN، امکان پردازش همزمان و دقیق دادههای نردهای و برداری را روی سطوح کروی فراهم کردهاند. این شبکه عصبی با حفظ تقارن دورانی سهبعدی، تحولی چشمگیر در مدلسازی پدیدههایی مانند پیشبینی آبوهوا، کیهانشناسی و سامانههای تصویربرداری سراسرنما ایجاد میکند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.