فریب «بهترین» ابزار تشخیص محتوای هوش مصنوعی جهان تنها در ۳۰ ثانیه
ابزار Pangram به عنوان یک راهکار قطعی برای تشخیص محتوای تولیدشده توسط هوش مصنوعی تبلیغ میشود. اما بررسیها نشان میدهد که ادعای دقت ۹۹ درصدی این ابزار با واقعیت فاصله زیادی دارد و به راحتی قابل فریب است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- ابزار Pangram با وجود ادعای دقت بالای ۹۹ درصد در تشخیص محتوای هوش مصنوعی، در سناریوهای واقعی به راحتی فریب میخورد.
- استفاده از ابزارهای «انسانیساز» (Humanizer) متن یا تغییرات جزئی در تصاویر میتواند سیستمهای تشخیص این ابزار را گمراه کند.
- اتکای بیش از حد به این ابزارهای نقصدار میتواند پیامدهای مخربی مانند اتهامهای نادرست به نویسندگان و دانشجویان به همراه داشته باشد.
در حالی که ابزارهای تشخیص تصاویر، موسیقی، متن و ویدیوهای تولیدشده توسط هوش مصنوعی برای سنجش اصالت محتوای آنلاین روزبهروز اهمیت بیشتری پیدا میکنند، Pangram به عنوان «استاندارد طلایی» تشخیص هوش مصنوعی خبرساز شده است (بماند که در بیانیه مطبوعاتی خود نیز با عنوان «بهترین در جهان» معرفی شده است). اما آیا ادعای دقت ۹۹ درصدی آن واقعیت دارد؟ لزوماً اینطور نیست. بله، Pangram به طور مداوم محتوای هوش مصنوعی را تشخیص میدهد، اما به طور مرتب نیز دچار اشتباه میشود. در ادامه، نتایج بررسیها و آزمایشهای گسترده روی این سرویس آورده شده است.
استفاده از هوش مصنوعی برای مقابله با هوش مصنوعی
ابزار Pangram خود را به عنوان «یک تشخیصدهنده هوش مصنوعی که واقعاً کار میکند» معرفی میکند و همانطور که اشاره شد، ادعا میکند برای متون تولیدشده توسط تقریباً همه مدلهای زبانی مطرح، از ChatGPT گرفته تا Qwen، دقتی بالای ۹۹ درصد دارد. این ابزار همچنین از قابلیت تشخیص تصاویر هوش مصنوعی برخوردار است. جالب اینجاست که Pangram برای تقویت ابزارهای تشخیص خود، از مدلهای اختصاصی هوش مصنوعی استفاده میکند.
این شرکت میگوید قابلیتهای تشخیص هوش مصنوعی آن یک سر و گردن بالاتر از رقبا است، زیرا اشخاص ثالث به طور مستقل دقت و قابلیت اطمینان آن را تایید کردهاند. همچنین به توانایی خود در تشخیص محتوای تمام مدلهای اصلی هوش مصنوعی، آموزش روی مجموعه دادههای متنوع، سالها تحقیق شرکتی، پشتیبانی گسترده از زبانها و موارد دیگر اشاره میکند. Pangram حتی ادعا میکند که فناوری آن در تشخیص محتوای هوش مصنوعی بهتر از انسانها عمل میکند؛ از جمله متونی که توسط ابزارهای «انسانیساز» با هدف فرار از سیستمهای تشخیص تولید شدهاند.
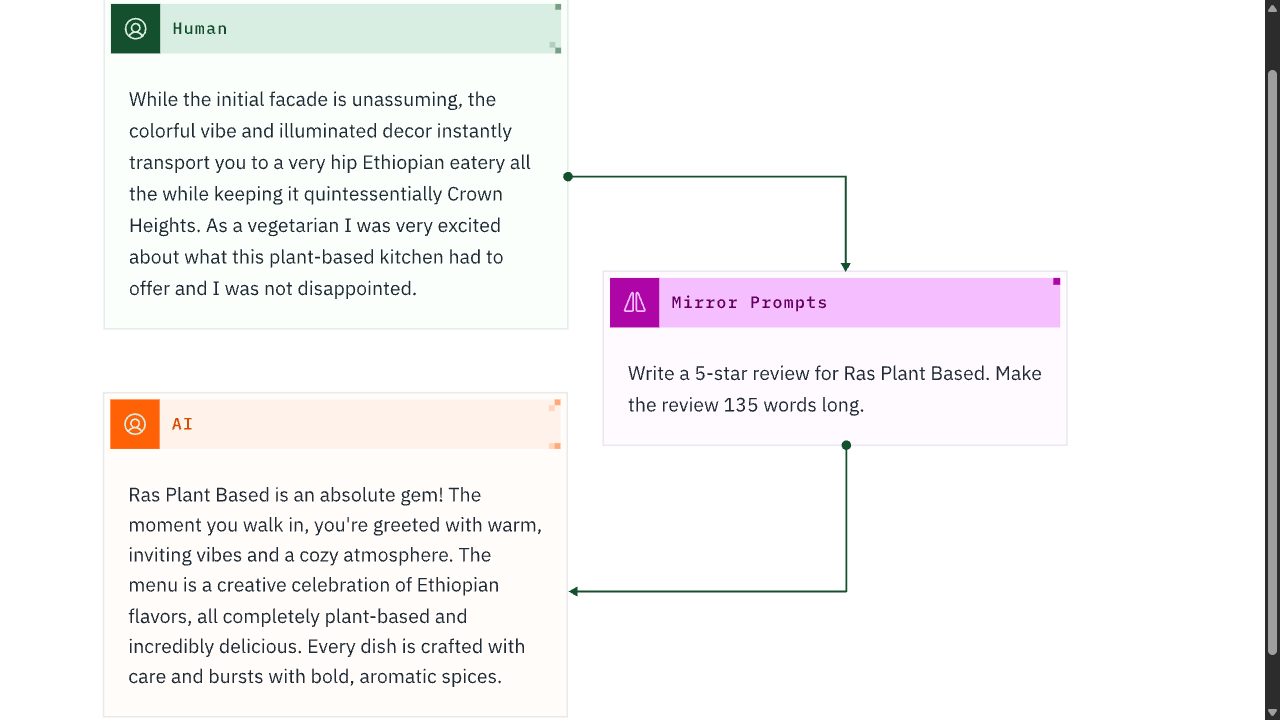
اینها ادعاهای جسورانهای هستند و برخی از فناوریهای زیربنایی Pangram در واقع نوآورانه محسوب میشوند. به عنوان مثال، تمرکز روی پرامپتهای آینهای را در نظر بگیرید. در این سناریوهای آموزشی، Pangram از یک انسان میخواهد چیزی بنویسد، سپس همان پرامپت را به یک مدل هوش مصنوعی میدهد تا بتواند مدلهای خود را برای درک تفاوتهای ظریف آموزش دهد. این موضوع و سایر جنبههای توسعه Pangram روی کاغذ عالی به نظر میرسند، اما عملکرد در دنیای واقعی و بررسی بیشتر آمارها، نقصهایی را آشکار میکند.
شکستن سد تشخیص: فریب Pangram تنها با سه جمله
اگر تصور میشود که نرخ دقت اعلامشده توسط Pangram به معنای آن است که تقریباً هرگز اشتباه نمیکند، واقعیت اینگونه نیست. نمیتوان گفت Pangram هرگز کار نمیکند؛ در واقع در بیشتر مواقع عملکرد درستی دارد و یکی از دقیقترین ابزارهای تشخیص هوش مصنوعی موجود است. اما متاسفانه، این تنها بدان معناست که این ابزار، بهترین گزینه در میان گزینههایی با نقصهای آشکار است.
باید در نظر داشت که Pangram برای اطمینان از تشخیص دقیق، نیاز دارد متون ارسالی حداقل ۵۰ کلمه باشند. در بررسیهای انجامشده، پیشنویسی از بخش ابتدایی یک مقاله پس از اضافهکردن جملهای که با استفاده از Gemini تولید شده بود، به این ابزار داده شد. Pangram نتوانست هیچ محتوای هوش مصنوعی را تشخیص دهد. سپس جمله دیگری با استفاده از Gemini اضافه شد و باز هم Pangram در تشخیص آن ناکام ماند. تنها پس از اضافهشدن سه جمله (افزایش از ۲۵۰ کلمه به ۳۱۱ کلمه)، Pangram متوجه مشکلی شد. با این حال، تنها دو جمله را به عنوان محتوای تولیدشده توسط هوش مصنوعی علامتگذاری کرد که یکی از آنها توسط انسان نوشته شده بود. زمانی که همان یک جمله پرچمگذاریشده بازنویسی شد، Pangram دیگر نتوانست هیچ چیزی را تشخیص دهد.
همچنین Pangram میگوید میتواند متون انسانیسازیشده را شناسایی کند، اما فریب دادن آن با استفاده از ابزارهای انسانیساز کار سادهای است. به عنوان مثال، در یک آزمایش، شعری با GPT-5.6 تولید شد. سپس با جستجوی یک «انسانیساز هوش مصنوعی»، از اولین نتیجهای که نیاز به ایجاد حساب کاربری نداشت برای انسانیسازی شعر ChatGPT استفاده شد. زمانی که این متن به Pangram ارسال شد، این ابزار شعر را ۱۰۰ درصد ساخته دست انسان معرفی کرد.
تصویر ناقص: ویرایشهای ساده، سیستم تشخیص تصویر Pangram را فریب میدهند
ابزار Pangram عمدتاً بر روی تشخیص متن تولیدشده توسط هوش مصنوعی تمرکز دارد، اما میتواند تصاویر هوش مصنوعی را نیز تشخیص دهد. این ابزار در بررسیها بیشتر تصاویر هوش مصنوعی را تشخیص داد، اما با این وجود همچنان به طور مرتب دچار اشتباه میشود.
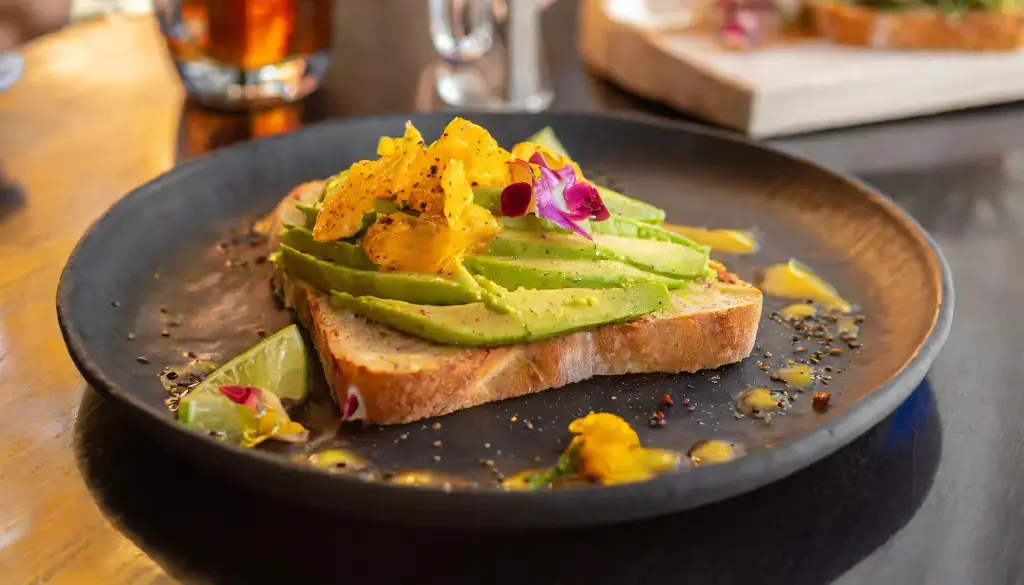
به عنوان مثال، تصاویر جعلی نسبتاً باورپذیر میتوانند Pangram را به اشتباه بیندازند. در یک مقاله سرگرمکننده در سال ۲۰۲۳ که با هدف آزمایش توانایی تشخیص تصاویر هوش مصنوعی منتشر شده بود، تصویری از نان تست آووکادو با یک لیموی عجیب و غریب وجود داشت. Pangram این تصویر را ۱۰۰ درصد ساخته دست انسان نامید، در حالی که در واقع توسط هوش مصنوعی تولید شده است.
همچنین میتوان با پاکسازی تصاویر هوش مصنوعی توسط ابزارهای دور زدن سیستم تشخیص، Pangram را فریب داد. برای مثال، در یک تست از مدل Nano Banana متعلق به Gemini برای برش یک تصویر استفاده شد. اگرچه خود تصویر تغییر بسیار کمی کرده بود، اما ویرایش تصاویر با Nano Banana، نشانگرهای قابلشناسایی C2PA و SynthID را به آن ضمیمه میکند. ابزار Pangram در هنگام برچسبگذاری تصویر به عنوان محتوای هوش مصنوعی، به اطلاعات هویتی C2PA استناد کرد. با این حال، پس از پردازش تصویر ویرایششده با یک ابزار رایگان که تشخیص آن را دشوارتر میکند، Pangram در بررسی مجدد، تصویر را ساخته دست انسان در نظر گرفت.
جزئیات پنهانی که پشت ادعای «دقت ۹۹ درصدی» Pangram گفته نمیشود
بنابراین، اگر Pangram با وجود ادعای چنین دقت بالایی در تشخیص همچنان اشتباه میکند، مشکل کجاست؟ خوشبختانه، Pangram مستندات زیادی درباره آزمایشهای خود ارائه میدهد. این سطح از شفافیت قابلتقدیر است، اگرچه در بررسیهای دقیقتر هنوز هم میتوان برخی از نکات فریبنده را پیدا کرد.
به عنوان مثال، Pangram دقت ۹۹.۸ درصدی را در تشخیص متون تولیدشده توسط مدل Opus 5 شرکت Anthropic تبلیغ میکند و به آزمایشی که انجام داده است استناد میکند. اما این ادعا متون Opus 5 را که توسط انسان ویرایش شده یا با ابزارهای مختلف انسانیسازی شدهاند، در بر نمیگیرد. در عوض، این عدد تنها بر آنچه Opus 5 به صورت خام در پاسخ به پرامپتها تولید میکند، تمرکز دارد. این شرکت برخی از موارد دیگر را نیز به صورت جداگانه آزمایش میکند، اما این نتایج در لابهلای مستندات آن پنهان شدهاند.
بر اساس مستندات یادشده، Pangram میتواند «متون انسانیسازیشده را در ۹۷.۶۷ درصد مواقع به عنوان تولیدشده توسط هوش مصنوعی، و در ۹۸.۸۳ درصد مواقع به عنوان محتوای ترکیبی یا هوش مصنوعی تشخیص دهد.» این ارقام با رقم ۹۹.۸ درصد متفاوت است، اما هنوز هم به آن نزدیک است. با این حال، اعداد دیگر حاکی از عملکردی ضعیفتر هستند. به عنوان مثال، Pangram توانایی خود را در تشخیص متون نوشتهشده با کمک هوش مصنوعی (AI-assisted) نیز اندازهگیری میکند که تنها در ۵۵.۰۱ درصد مواقع آن را به درستی تشخیص میدهد. این یک مشکل اساسی است؛ به ویژه زمانی که شرکت عمدتاً بر روی سناریوی محدودی تمرکز و تبلیغ میکند که در آن دقت ۹۹.۸ درصدی اعمال میشود.
سایر نرخهای دقت منتشرشده نیز مشکلات متفاوتی دارند. برای مثال، اگر روی نرخ دقت ۹۹.۵ درصدی تبلیغشده برای Gemini 3 در صفحه اصلی Pangram کلیک کنید، صفحهای درباره مدل نسبتاً قدیمی Gemini 3 Pro باز میشود. برخلاف صفحات مرتبط با GPT-5.6 و Opus 5 که توضیحات واضحی دارند، این صفحه هیچ توضیحی درباره رقم ۹۹.۵ درصد ارائه نمیدهد.
با بررسی مستندات Pangram 4، مشخص میشود که این شرکت مدل Gemini 3.1 Pro را در حالت پیشنمایش و همچنین 3.5 Flash را نیز آزمایش کرده است که در آنها نرخ منفی کاذب ۹۹.۵ درصدی مشاهده میشود. با این وجود، ای�� مسئله همچنان نرخ دقت اعلامشده برای Gemini 3 را که به گفته شرکت در نوامبر ۲۰۲۵ پیش از انتشار نسخههای 3.1 Pro و 3.5 Flash آزمایش شده بود، توضیح نمیدهد. علاوه بر این، این مدلها نماینده کاملی برای «Gemini 3» نیستند، زیرا این خانواده شامل مدلهای بیشتر و جدیدتری مانند 3.6 Flash، 3.7 Flash و 3.8 Flash میشود. در همین حال، Pangram برای مدل GPT-5.6 تا آنجا پیش رفته که هر یک از نسخههای آن (Luna، Sol و Terra) را آزمایش کرده است؛ بنابراین رویکرد آن در قبال Gemini کاملاً ضعیف به نظر میرسد.
اگرچه آمارهای Pangram بینقص نیستند، اما دلیلی وجود ندارد که تصور شود شرکت آنها را جعل کرده است. این موضوع به خودی خود اتفاق خوبی است، اما تنها مشکلی را برجسته میکند که همیشه در مورد بنچمارکهای هوش مصنوعی مطرح بوده است: آنها به سادگی به عملکرد در دنیای واقعی ترجمه نمیشوند. در مورد Pangram، آزمایشها غالباً نرخهای تشخیص استثنایی (و در حال بهبودی) را نشان میدهند، اما در عمل، میتوان این ابزار را به راحتی از کار انداخت.
انتخاب نتایج دلخواه: واقعیت پشت پرده تاییدات مستقل
فراتر از آمارهای داخلی، Pangram میگوید: «توسط محققان شخص ثالث، از جمله دانشگاه مریلند و دانشگاه شیکاگو، به عنوان قابلاعتمادترین و دقیقترین تشخیصدهنده هوش مصنوعی در بازار اثبات شده است.» این ادعا دروغ نیست، اما چنین جملهای نتیجهگیری تحقیقات زیربنایی را قویتر از آنچه هستند نشان میدهد.
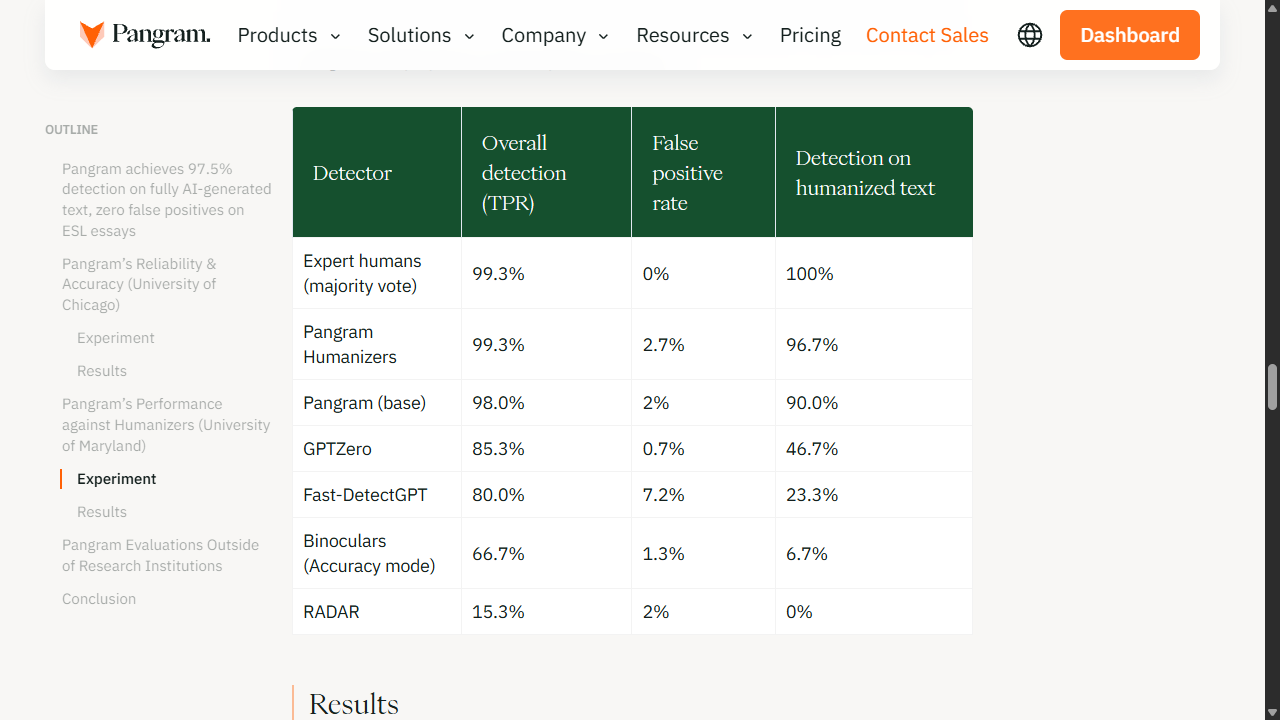
به عنوان مثال، در مطالعه دانشگاه مریلند، Pangram به مقایسه ابزارهای تشخیص در برابر انسانها در یافتن متون انسانیسازیشده هوش مصنوعی اشاره میکند. ابزار Pangram بهترین عملکرد را در بین ابزارها داشت و در آزمون، عملکردی بهتر از تکتک انسانها نشان داد. با این حال، زمانی که انسانها به صورت گروهی رای دادند، باز هم بهتر از Pangram عمل کردند. این موضوع تا حدی ادعای Pangram مبنی بر اینکه «مطالعات مستقل نشان دادهاند سیستم تشخیص هوش مصنوعی Pangram در شناسایی محتوای تولیدشده توسط هوش مصنوعی، بهتر از خوانندگان آموزشدیده انسانی عمل میکند» را زیر سوال میبرد.
در مطالعه دانشگاه شیکاگو نیز Pangram اشاره میکند که تنها سه ابزار تشخیص هوش مصنوعی دیگر در کنار Pangram آزمایش شدهاند؛ که با توجه به تعداد زیاد ابزارهای مشابه موجود، انتخاب بسیار کوچکی به نظر میرسد. محققان دانشگاه آزاد بروکسل نیز تنها سه ابزار دیگر را در کنار Pangram آزمایش کردند که این بار روی مقالات دانشگاهی طولانی انجام شد. مسئله این نیست که این تحقیقات برای Pangram خوب به نظر نمیرسند، بلکه آنها لزوماً مدرک قاطعی برای اثبات هیچ چیزی نیستند.
خارج از موسسات تحقیقاتی، Pangram به ارزیابیهای دیگری مانند مقاله دیوید گِوِرتز در ZDNET درباره ابزارهای تشخیص هوش مصنوعی نیز استناد میکند. رسانه Pangram از قول او مینویسد: «یک تازهوارد در آزمایشهای ما که بلافاصله به حلقه برندگان صعود کرد.» در حالی که Pangram در آزمایشهای او عملکرد خوبی داشت، اما به این موضوع اشاره نمیکند که مقاله گورتز همچنین گفته است: «سرویسهایی که به عنوان تشخیصدهنده محتوای هوش مصنوعی به بازار عرضه میشوند، نتایج ضد و نقیضی دارند» و در ادامه نتیجهگیری کرد که «پیش از تکیه بر نتایج هر یک یا همه این ابزارها، باید جانب احتیاط را رعایت کرد.»
برای روشنشدن موضوع، این شواهد نتایج خوبی را برای Pangram نشان میدهند. اما نحوه استفاده این شرکت از آنها برای ارائه یک انتظار غیرواقعی از عملکرد در دنیای واقعی، جای نقد دارد. این ابزار همچنان به طور مرتب دچار اشتباه میشود و نتایج نادرست میتواند پیامدهای واقعی و جبرانناپذیری برای افراد به همراه داشته باشد.
مثبت کاذب میتواند زندگیها را ویران کند: خطر ابزارهای نقصدار
تشخیص اینکه چه چیزی در فضای آنلاین واقعی است روزبهروز دشوارتر میشود و هوش مصنوعی به طور فعال این وضعیت را وخیمتر میکند. ابزارهایی که ادعا میکنند محتوای هوش مصنوعی را تشخیص میدهند اما نمیتوانند این کار را بینقص انجام دهند، تنها بر سردرگمیها میافزایند.
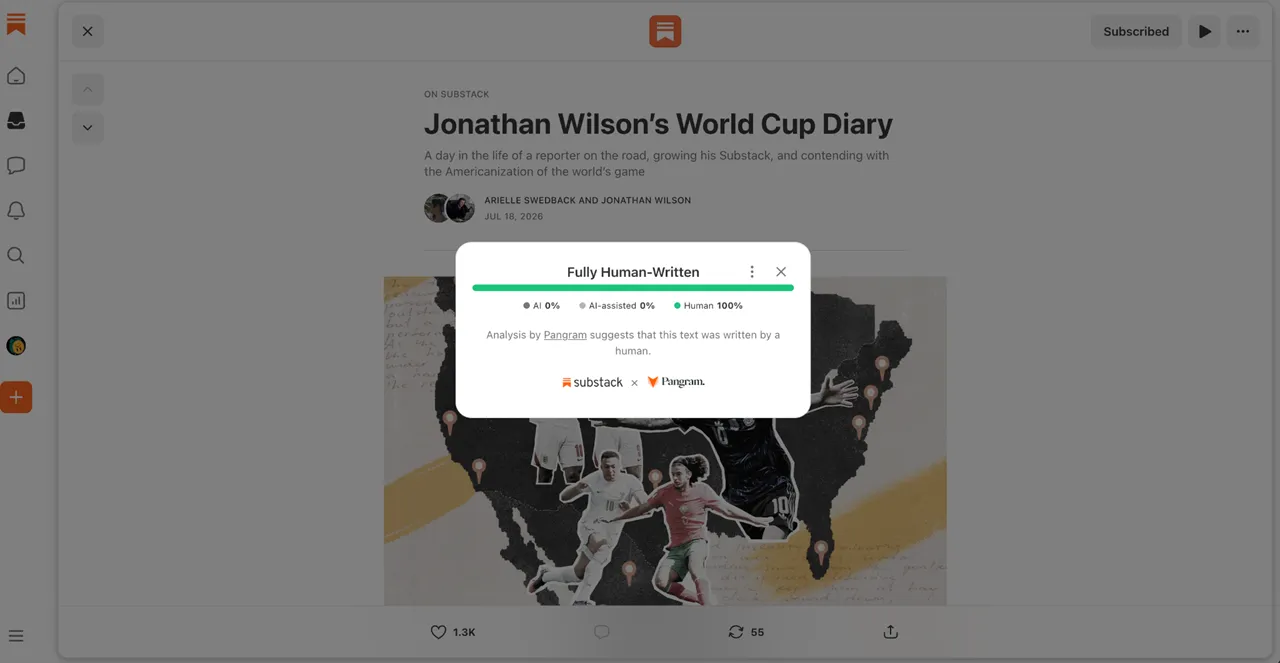
به عنوان مثال، پلتفرم Substack اخیراً از قابلیت اسکن پستها با استفاده از فناوری Pangram برای تعیین میزان احتمال تولید آنها توسط هوش مصنوعی خبر داده است. اما اگر شخصی از طریق نوشتن در Substack امرار معاش کند و Pangram به اشتباه کار او را به عنوان محتوای جزئی یا کاملاً تولیدشده توسط هوش مصنوعی برچسبگذاری کند، چه اتفاقی میافتد؟ یا از سوی دیگر، چه میشود اگر Pangram با زدن برچسب ۱۰۰ درصد نوشتهشده توسط انسان، برای نویسندگانی که محتوای خود را با محتوای هوش مصنوعی ترکیب میکنند پوشش ایجاد کند؟ با اینکه Substack اجازه میدهد تا اسکنهایی را که نویسنده نادرست میداند گزارش و حذف کند، اما این یک راهحل ایدهآل نیست.
این موضوع فراتر از Substack است. یک استاد ادبیات باسابقه را تصور کنید که درک خوبی از فناوریهای مدرن ندارد و مقالات دانشجویان را به Pangram میفرستد، زیرا دانشگاه آنها با این شرکت همکاری کرده است. چه اتفاقی میافتد زمانی که Pangram گهگاه یک مقاله کاملاً معتبر و اصیل را به عنوان محتوای هوش مصنوعی پرچمگذاری میکند؟ بیشتر افراد نمیدانند چگونه قابلیت اطمینان ابزارهای تشخیص هوش مصنوعی را ارزیابی کنند؛ بنابراین این احتمال وجود دارد که چنین سناریویی به یک نمره مردودی ناعادلانه و بدون هیچگونه راه چارهای برای دانشجو منجر شود.
به همین دلیل است که انتقادات زیادی نسبت به ابزارهای تشخیص هوش مصنوعی مانند Pangram وارد میشود. بسیار بهتر بود اگر شرکتهایی نظیر Pangram درباره کارهایی که میتوانند و نمیتوانند به خوبی انجام دهند، صادقانهتر و شفافتر عمل میکردند.
استاندارد طلایی وجود ندارد: باید به هر ابزار تشخیص هوش مصنوعی شک کرد
برخلاف آنچه بازاریابی و تحقیقات این شرکتها ادعا میکنند، ابزارهای تشخیص هوش مصنوعی هنوز هم در سناریوهای دنیای واقعی قابلاتکا نیستند. البته اگر Pangram یا ابزاری شبیه به آن متنی را به عنوان تولیدشده توسط هوش مصنوعی علامتگذاری کند، میتواند شواهدی از عدم اصالت آن محتوا باشد، اما این هشدارها خطاناپذیر نیستند. به خاطر سپردن این موضوع بسیار مهم است، زیرا اعتماد بیش از حد به ابزارهای تشخیص میتواند پیامدهای فاجعهباری به همراه داشته باشد. بهترین راه برای محافظت، یادگیری دقیق نحوه استخراج ادعاهای دقت توسط شرکتها و حفظ رویکردی انتقادی و محتاطانه نسبت به نتایج آنها است.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی

رکورد ۸۳۳ هزار دانلود ماهانه برای LEGAL-BERT؛ وقتی توسعهدهندهها قید مدلهای گرانقیمت را میزنند!
مدل زبانی تخصصی LEGAL-BERT با ثبت بیش از ۸۳۳ هزار دانلود در ماه روی پلتفرم هاگینگ فیس حسابی خبرساز شده است. این ابزار جمعوجور و تخصصی نشان میدهد که برای پردازش و تحلیل متون حقوقی، حتماً نیازی به مدلهای غولپیکر و پرهزینه ندارید و گزینههای بهینه همچنان در اوج هستند.

جاسوسی هوش مصنوعی در محل کار؛ کارمندان میگویند کارفرماها باید قانوناً مچگیریهایشان را لو بدهند!
نظرسنجیهای تازه نشان میدهد که بیشتر کارمندان حس میکنند مدیرانشان با ابزارهای هوش مصنوعی تمام حرکات آنها را زیر نظر گرفتهاند. حالا بیش از ۸۰ درصد شاغلان خواستار تصویب قانونی شدهاند که شرکتها را مجبور کند هرگونه مچگیری و نظارت هوش مصنوعی در محیط کار را رسماً اعلام کنند.

گزارش داغ مایکروسافت از نفوذ جهانی هوش مصنوعی؛ امارات در صدر و رتبه عجیب آمریکا!
مایکروسافت در تازهترین گزارش خود از ضریب نفوذ هوش مصنوعی در جهان پرده برداشت؛ آماری شگفتانگیز که نشان میدهد امارات و سنگاپور با فاصلهای خیرهکننده پیشتاز دنیا هستند و در مقابل، آمریکا در رتبه ۲۱ جا مانده است. همچنین الگوی استفاده از هوش مصنوعی میان کشورهای غربی و کشورهای در حال توسعه، از تفاوتی عمیق میان کاربردهای روزمره و آموزش پرده برمیدارد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.