پرپلکسی با مدل امبدینگ جدیدش قواعد بازی را بههم زد؛ ۸ برابر فشردهتر از رقبا با بردارهای ۱ کیلوبایتی!
استارتاپ پرپلکسی با انتشار نسخه پیشنمایش مدل امبدینگ ۹ میلیاردی خود، گام بزرگی در بهینهسازی سیستمهای بازیابی اطلاعات برداشته است. این مدل نوآورانه با تولید بردارهای فوقالعاده فشرده ۱ کیلوبایتی، ضمن کاهش ۸ برابری مصرف فضای ذخیرهسازی، در بنچمارکهای کلیدی از رقبای سرشناسی همچون Voyage پیشی میگیرد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- پرپلکسی از نسخه پیشنمایش مدل امبدینگ متنی ۹ میلیارد پارامتری (pplx-embed-v2) رونمایی کرد که با در نظر گرفتن کل سند، معنای دقیق تکتک بخشها رو حفظ میکنه.
- این مدل با تولید بردارهای ۱۰۲۴ بُعدی در فرمت int8، فقط ۱ کیلوبایت حافظه میگیره و با وجود مصرف یکهشتم حافظه نسبت به رقبا، تو بنچمارکها از مدل معروف voyage-context-4 جلو میزنه.
- وزنهای مدل برای پیادهسازی روی سرورهای اختصاصی بهصورت عمومی منتشر شده و بهزودی دسترسی به API اون هم فراهم میشه.
رونمایی پرپلکسی از پیشنمایش مدل امبدینگ با بردارهای ۱ کیلوبایتی
استارتاپ پرپلکسی (Perplexity) بهتازگی وزنهای نسخه پیشنمایش مدل جدید خود به نام pplx-embed-v2-context-9b-preview را منتشر کرده است؛ یک مدل امبدینگ متنی (Contextual Embedding) که هر تکه از متن (چانک) را با در نظر گرفتن کل سند کدگذاری میکند. پرپلکسی ادعا میکند که این مدل بالاترین میانگین امتیاز را در بنچمارک ConTEB کسب کرده و در بنچمارک اختصاصی context-bench که با همکاری turbopuffer طراحی شده نیز عملکردی پیشتاز ثبت نموده است.
این مدل امبدینگهایی با ابعاد ۱۰۲۴ و در فرمت فشرده int8 تولید میکند. یک بردار ۱۰۲۴ بُعدی در فرمت int8، بدون احتساب متادیتا و ساختارهای شاخصگذاری، دقیقاً ۱۰۲۴ بایت (۱ کیلوبایت) از حافظه را اشغال میکند که فوقالعاده بهینه است.
چرا تکهتکه کردن متنها بدون بستر اصلی، معنای آنها را نابود میکند؟
سیستمهای بازیابی اطلاعات مجهز به هوش مصنوعی (RAG) برای جستوجوی سادهتر، اسناد طولانی را به بخشها و تکههای کوچکتر (Chunks) تقسیم میکنند. اما مشکل از جایی شروع میشود که وقتی یک تکه متن جدا میشود، ممکن است عنوان اصلی، نام اشخاص، تیتر جدولها، نام گوینده یا تاریخی که به آن تکه معنا میبخشیده را از دست بدهد. این دردسر بهویژه در اسنادی با عبارات تکراری—مثل قراردادهای اجاره یا گزارشهای رسمی و دولتی—بیشتر به چشم میآید؛ جایی که دهها تکه متن جداگانه بدون متنِ پیرامونشان، کاملاً شبیه به هم به نظر میرسند!
مدلهای امبدینگ متنی برای حل این معضل، از روشی به نام «تکهبندی با تأخیر» (Late Chunking) استفاده میکنند. در این روش، مدل در یک دور کامل، ابتدا کل سند را پردازش میکند و سپس بردارهای هر تکه را از روی نمایش توکنهای درکشده در بستر کل متن استخراج مینماید. با این ترفند، هر بردار خروجی در عین حال که اطلاعات بخشهای دیگر سند را در خود دارد، میتواند بهصورت کاملاً مستقل ذخیره و جستوجو شود.
در روشهای سنتی آموزش، معمولاً به برچسبگذاریهای دستی یا پاسخهای مشخصشده توسط مدلهای زبانی (Gold Chunks) تکیه میشد؛ طوری که یک تکه به عنوان جواب درست انتخاب میشد و سایر بخشهای سند نادیده گرفته یا منفی فرض میشدند. این شیوه نهتنها بخشهای کمکی و مفید دیگر متن را دور میانداخت، بلکه با بزرگتر شدن اسناد هزینههای سنگینی تراشیده و مدل را به مرزبندیهای سفت و سخت وابسته میکرد.
امتیازدهی به توکنها به جای تکههای خشک و ثابت
پرپلکسی برای آموزش مدل امبدینگ خود، رویکرد هوشمندانهای به کار بسته است: یک مدل راهنما و فشردهساز (Compression Teacher) پرسش و سند را همزمان میخواند و به تکتک توکنها یک امتیاز پیوسته متناسب با ارتباطشان میدهد. این امتیازها میتوانند فارغ از نحوه تقسیمبندی متن، در هر اندازهای از تکهها تجمیع شوند. این انعطافپذیری و برش تصادفی به سیستم اجازه میدهد تا با یک سیگنال واحد در سطح توکن، چندین مدل تقسیمبندی مختلف سند را به بهترین شکل آموزش دهد.
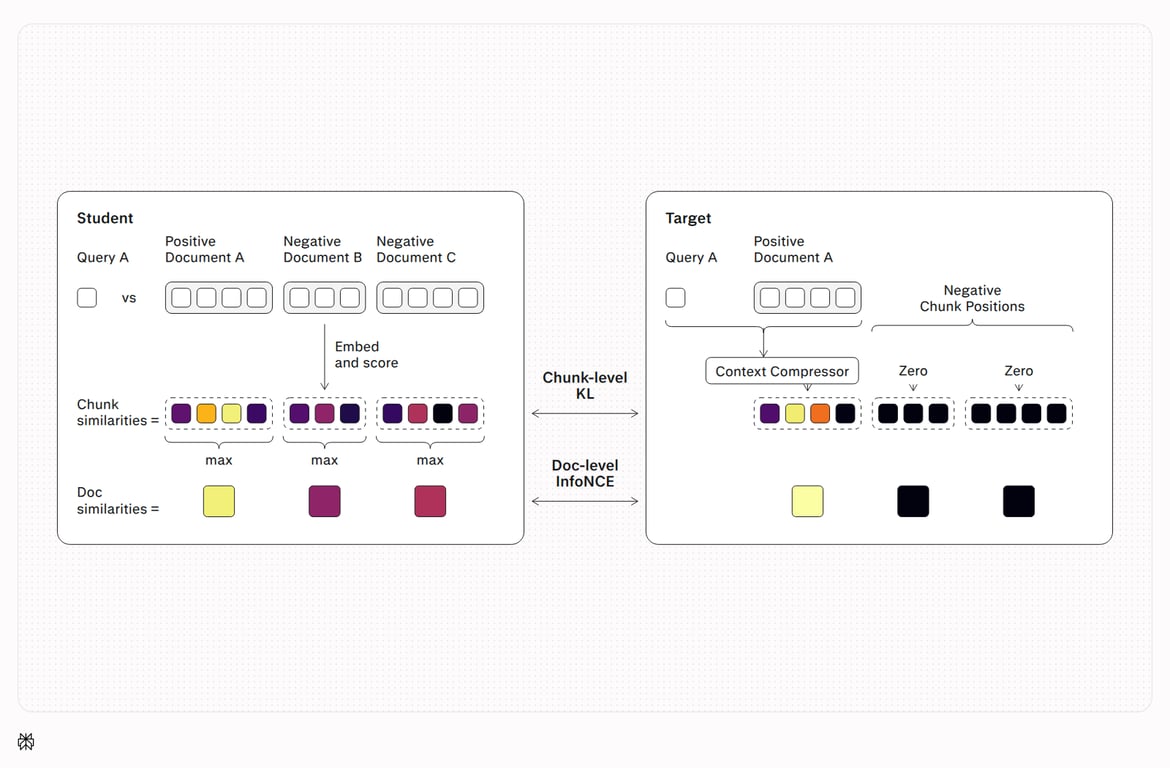
دو تابع زیان که به مدل دانشآموز جهت میدهند
- تابع زیان InfoNCE در سطح سند: در این ساختار، شباهت سند به عنوان بالاترین شباهت کسینوسی بین پرسش کاربر و هر یک از تکههای موجود در آن سند تعریف میشود. این تابع زیان باعث میشود سندی که بخش مرتبط در آن قرار دارد، بالاتر از سایر اسناد قرار گیرد؛ رفتاری که شباهت زیادی به سازوکار MaxSim در مدل بازیابی ColBERT دارد.
- تقطیر دانشی KL در سطح تکهها: امتیازهای توکن ارائهشده توسط مدل راهنما، به یک توزیع احتمال هدف روی تکههای سند درست تبدیل میشوند. مدل دانشآموز نیز با اعمال تابع سافتمکس (Softmax) روی تمامی تکهها یاد میگیرد که توزیع احتمالی خود را به این هدف نزدیک کند.
نکته مهم اینجاست که مدل راهنمای آگاه از پرسش، صرفاً در زمان آموزش حضور دارد؛ یعنی بعد از پایان آموزش، برای جستوجوهای روزمره کاربران دیگر نیازی به اجرای این مدل سنگین نیست و بردار اسناد از قبل بهصورت آماده ایندکس شدهاند.
پرپلکسی برای ساخت این مدل دانشآموز، کار را با یکی از مدلهای اختصاصی ۹ میلیارد پارامتری ColBERT آغاز کرده و با افزودن یک لایه خطی، بردارهایی با ۲۰۴۸ بعد تولید کرده است. با استفاده از تکنیک آموزش ماتریوشکا (Matryoshka Representation)، این مدل میتواند همزمان خروجیهایی در ابعاد ۱۰۲۴ یا ۲۰۴۸ ارائه دهد؛ علاوه بر این، آموزش آگاه از کوانتیزاسیون (QAT) سیستم را برای تحویل بردارهای بومی در فرمت فشرده int8 کاملاً آماده کرده است.
مجموعه دادههای آموزشی شامل حدود ۴۳۰ دیتاست عمومی و داخلی از جفتهای پرسش و سند به بیش از ۵۰ زبان مختلف بوده است. پرپلکسی اعلام کرده که دادههای بنچمارکهای ConTEB و context-bench در طول فرایند توسعه کاملاً جدا نگه داشته شدهاند تا از آلودگی دادهها جلوگیری شود.
یک بنچمارک چالشبرانگیز برای متون مبهم و مشابه
بنچمارک Context-bench دقیقاً برای سناریوهایی طراحی شده که جملات محلی و کوتاه به تنهایی نمیتوانند منبع اصلی و درست را لو بدهند! این بنچمارک شامل ۲,۰۹۹ پرسش بر روی ۳۸,۸۹۴ سند بلند در ۲۱ زمینه تخصصی مختلف است؛ اسنادی طولانی که میانه طول آنها حدود ۶,۱۰۰ توکن برآورد میشود.
معیار | تعداد |
|---|---|
پرسشها | ۲,۰۹۹ |
اسناد | ۳۸,۸۹۴ |
تکههای جملهای | ۲,۴۵۸,۰۷۲ |
حوزهها و صنایع | ۲۱ |
قابلیتهای مبتنی بر بافت متن | ۱۲ |
این ۱۲ قابلیت شامل مواردی مثل شناسایی هویت نهادها، درک ساختار جداول، فهم ضمایر و ارجاعات مبهم، ترتیب قرارگیری در فهرستها، انتساب گوینده، تغییرات در طول زمان، روابط علت و معلولی و مفاهیم چندزبانه است. به عنوان مثال، در یک جستوجو درباره املاک، سیستم باید بتواند بین هزاران قرارداد اجاره که همگی جمله تکراری «اجاره ماهانه مبلغ X دلار است» را دارند تمایز قائل شود؛ جایی که جزئیات دوری مثل آدرس ملک، نام مستأجر و تاریخ قرارداد تعیینکننده نسخه واقعی هستند.
سه زاویه دید برای سنجش کیفیت بازیابی
- معیار Document@K: بررسی میکند که وقتی اسنادِ تقریباً مشابه کلمات یکسانی دارند، آیا سند درست در میان K نتیجه اول قرار میگیرد یا خیر.
- معیار Answer@K: میسنجد که آیا تکه متنی که مستقیماً حاوی پاسخ است، در بین K تکه برتر کل مجموعه اسناد پیدا میشود یا نه.
- معیار Evidence Recall@K: با کنار گذاشتن تکه اصلی پاسخ، اندازه میگیرد که چه مقدار از مدارک و شواهد کمکی از سند درست در میان K تکه برتر ظاهر شدهاند.
مجموعه داده این بنچمارک برای جلوگیری از تقلب و حفظ بیطرفی، بهصورت خصوصی نگه داشته شده است. البته این مسئله امکان بررسی مستقل را محدود میکند و نمرات اعلامشده به ارزیابیهای کنترلشده تحت نظارت تیم turbopuffer وابسته هستند.
نتایج درخشان؛ پیشنمایش پرپلکسی در چه بخشهایی صدرنشین است؟
شاخص | امتیاز | مقایسه |
|---|---|---|
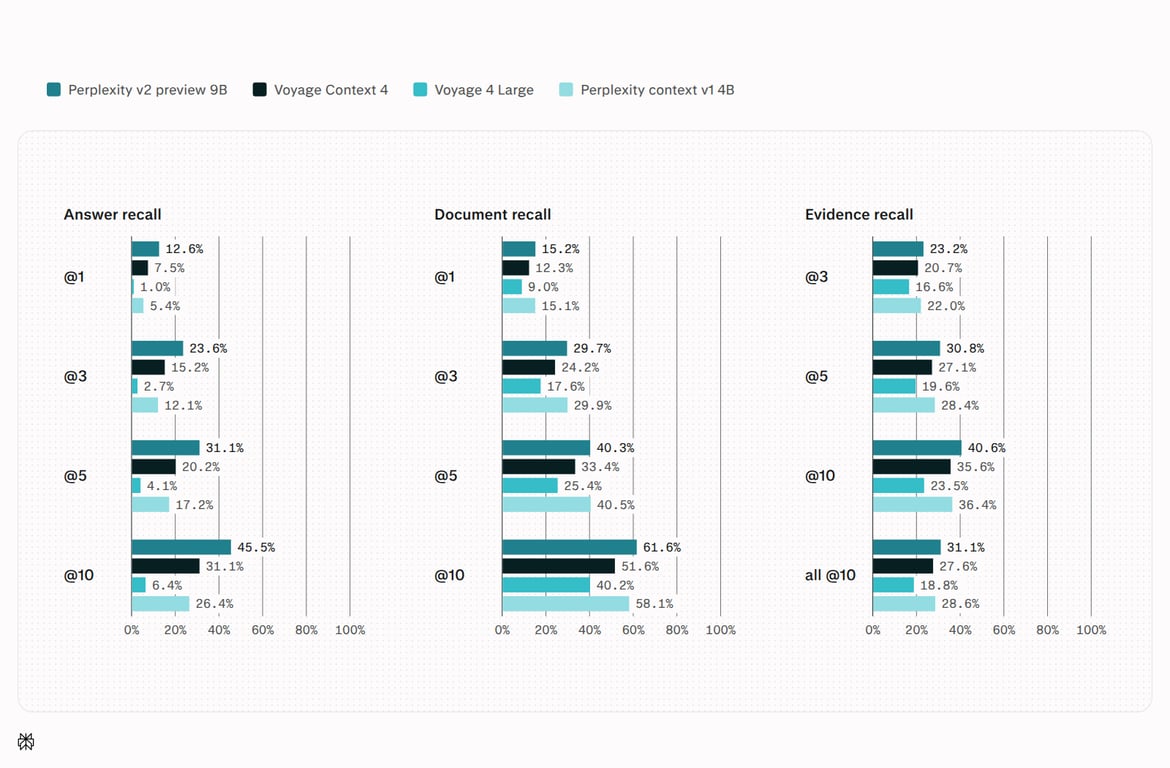
Answer Recall@10 | ۴۵.۵٪ | ۱۴.۴ درصد بالاتر از voyage-context-4 |
Evidence Recall@10 | ۴۰.۶٪ | ۵.۰ درصد بالاتر از voyage-context-4 |
All-Evidence@10 | ۳۱.۱٪ | بالاترین رکورد گزارششده |
Document@1 | ۱۵.۲٪ | بالاترین رکورد گزارششده |
Document@10 | ۶۱.۶٪ | بالاترین رکورد گزارششده |
نسخه پیشنمایش پرپلکسی در تمامی سطوح ارزیابیشده معیارهای Answer@K و Evidence Recall@K صدرنشین جدول است. با این حال، نسخه قدیمیتر pplx-context-v1-4B در امتیازهای Document@3 و Document@5 نتایج بهتری حفظ کرده که نشان میدهد مدل جدید در تکتک معیارهای رتبهبندی سند بیرقیب مطلق نیست.
در ارزیابیهای عمومی ConTEB، این مدل پیشنمایش بالاترین میانگین معیار nDCG@10 (شاخصی که نمایش نتایج مرتبط در صدر فهرست را میسنجد) را به ثبت رسانده است. البته مدل pplx-context-v1-4B در دیتاست NarrativeQA و مدل Nemotron-3-8B در دیتاست COVID-QA عملکرد بهتری داشتهاند. پرپلکسی علت برتری نموترون در سوالات کووید را وجود اصطلاحات خاص پزشکی میداند که به تطابق دقیق واژگان کمک میکند و وابستگی کمتری به درک کلی متن دارد.
فقط یک کیلوبایت برای هر بردار!
پیکربندی | ابعاد | فرمت | بایت بهازای هر بردار |
|---|---|---|---|
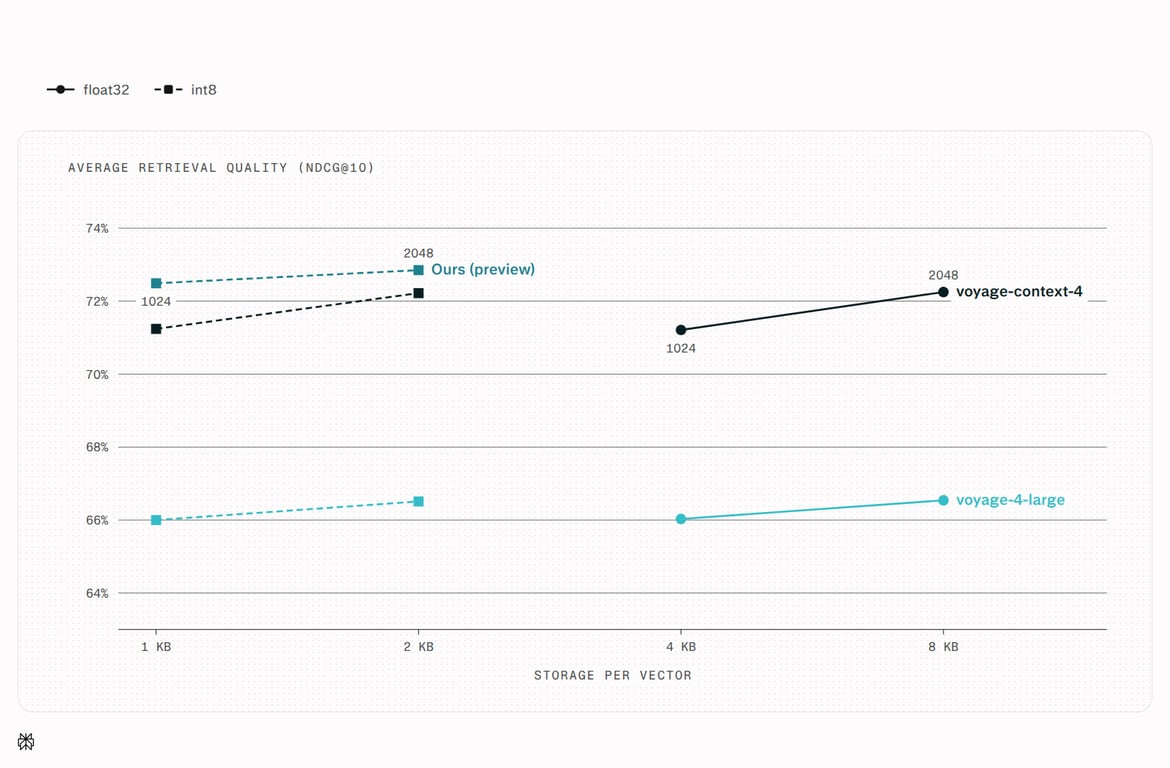
پیشنمایش pplx-embed-v2 | ۱,۰۲۴ | int8 | ۱,۰۲۴ |
مدل رقیب voyage-context-4 | ۲,۰۴۸ | float32 | ۸,۱۹۲ |
این ساختار جمعوجور، دقیقاً یکهشتم حافظه ذخیرهسازی خامِ مدل رقیب یعنی voyage-context-4 را مصرف میکند و جالب اینکه حتی اندکی از میانگین امتیاز بازیابی تکهها در آن مدل هم پیشی میگیرد! البته در عمل، حجم نهایی ایندکس شامل متادیتای اسناد، شناسهها و ساختارهای داده جستوجوی نزدیکترین همسایه (ANN) نیز خواهد بود.
یکی دیگر از نکات جالب، حساسیت پایین مدل نسبت به اندازه تکههاست. میانگین nDCG@10 با تغییر اندازه تکهها از ۶۴ توکن به ۵۱۲ توکن، تنها از ۸۱.۰ درصد به ۷۹.۹ درصد افت پیدا میکند. این ثبات فوقالعاده به مهندسان سیستم اجازه میدهد تا بسته به ساختار اسناد و هزینههای سرور، با دست باز درباره اندازه تکهها تصمیمگیری کنند.
تغییرات کلیدی در خطوط پردازش داده (Pipelines) برای استفاده از این مدل
- کدگذاری یکپارچه کل سند: سرویسهایی که پیش از این هر تکه را به شکل مستقل و جداگانه امبد میکردند، اکنون باید دستهبندی اسناد را حفظ کرده و قبل از استخراج بردارهای هر تکه، کل سند را یکجا از انکودر عبور دهند.
- نیاز به امبدینگ مجدد اسناد ویرایششده: از آنجا که کوچکترین تغییر در یک بخش میتواند نمایش معنایی سایر بخشهای سند را تغییر دهد، هرگونه ویرایش یا بهروزرسانی در یک متن ممکن است نیازمند تولید دوباره بردار تمامی تکههای آن سند باشد.
- بررسی پشتیبانی از فرمت int8: پایگاههای داده برداری (Vector DBs) باید از بردارهای ۱۰۲۴ بُعدی در قالب int8 پشتیبانی کنند تا بتوان از مزیت کاهش حجم آن بهره برد؛ چرا که تبدیل آن به فرمتهای حجیمتر باعث اتلاف رم و حافظه میشود.
- تست بر روی دادههای بومی: بازیابی بافتمحور زمانی بیشترین بازدهی را دارد که یافتن بخشهای مرتبط به اطلاعات پراکنده در دوردستِ متن وابسته باشد؛ در کارهایی که مبتنی بر کلمات کلیدی مشخص و منحصربهفرد هستند، شاید میزان این جهش کمتر به چشم بیاید.
- محاسبه هزینههای شاخصگذاری: انکود کردن کل سند به جای تکههای مستقل، محاسبات مربوط به دستهبندی (Batching)، سقف طول ورودی، توان عملیاتی و حافظه موردنیاز کارتهای گرافیک (VRAM) را دستخوش تغییر میکند.
در حال حاضر وزنهای این مدل پیشنمایش برای میزبانی روی سرورهای اختصاصی در دسترس عموم قرار گرفته و پرپلکسی وعده داده که دسترسی به API آن نیز بهزودی و بدون مشخص کردن تاریخ دقیق، ارائه خواهد شد. البته برای ارسال نتایج جدید به بنچمارک Context-bench، به دلیل خصوصی بودن دادهها، باید با تیم turbopuffer هماهنگی لازم صورت گیرد.
برای ارزیابی نهایی در محیطهای واقعی تجاری و عملیاتی، هنوز باید فاکتورهایی مثل حداکثر طول ورودی، نرخ تأخیر، توان خروجی، پیشنیازهای سختافزاری، لایسنس استفاده و هزینه سربار کل ایندکسها بهدقت سنجیده شوند. نتایج بهدستآمده از بنچمارکها و اندازه جمعوجور بردارها سیگنالهای بسیار امیدوارکنندهای هستند، اما سازگاری کامل با سیستمهای زنده به بررسی دقیق همین مشخصات عملیاتی بستگی خواهد داشت.
مطالب مرتبط و پیشنهادی
خط قرمز کالیفرنیا برای کارفرماها: اخراج کارمندان با هوش مصنوعی رسماً ممنوع شد!
ایالت کالیفرنیا با تصویب یک بسته قانونی تازه، دست کارفرماها را در استفاده بیرویه از هوش مصنوعی بست و اخراج کارکنان صرفاً بر اساس تصمیم الگوریتمها را ممنوع اعلام کرد. این قانون علاوه بر الزام به شفافیت در تعدیلهای نیرو، استفاده از هوش مصنوعی برای نظارت تصویری در سرویسهای بهداشتی محل کار را هم قدغن کرده است. فرماندار کالیفرنیا با دفاع از نیروی کار، ادعای امکان خودتنظیمگری شرکتهای هوش مصنوعی را بیاساس خواند.
طوفان هوش مصنوعی در بازار حافظه؛ رکورد تاریخی درآمد ۵۴ میلیارد دلاری میکرون در یک فصل!
عطش سیریناپذیر غولهای فناوری برای توسعه هوش مصنوعی، درآمد فصلی شرکت میکرون را با جهشی باورنکردنی به بیش از ۵۴ میلیارد دلار رساند تا والاستریت شگفتزده شود. این غول تراشهسازی با ثبت درآمد سالانه ۱۳۳ میلیارد دلاری رکورد تاریخ خود را شکست و حالا با تقاضای انفجاری برای حافظههای پیشرفته، چشم به آیندهای درخشانتر دوخته است.
خداحافظی گوگل با Opal؛ جمزها به «اسکیلهای جمینای» برای تمام کاربران تبدیل میشوند!
گوگل در اقدامی تازه برای یکپارچهسازی ابزارهای هوش مصنوعی، سرویس Opal را بازنشسته کرده و دستیارهای اختصاصی جمز را به «اسکیلهای جمینای» تبدیل میکند. این قابلیت که پیش از این در انحصار کاربران اشتراکی بود، حالا با پیروی از استاندارد مشترک ایجنتها و به کمک دستورهای ساده اسلش، به رایگان در دسترس همه کاربران قرار میگیرد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.