موتور جستجوی Photon از Perplexity معرفی شد؛ کاهش ۱۲ برابری تاخیر برای ایجنتهای هوش مصنوعی
شرکت Perplexity از Photon، موتور اختصاصی بازیابی و رتبهبندی مبتنیبر زبان Rust رونمایی کرد. این زیرساخت تازه بههمراه حالت Fast Search در Search API، تاخیر پاسخدهی را برای ایجنتهای هوش مصنوعی تا ۱۲ برابر کاهش میدهد و هزینهها را تا ۶۸ درصد بهینهسازی میکند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- توسعه موتور جستجوی اختصاصی Photon با زبان Rust برای جایگزینی زیرساختهای قدیمی متنباز
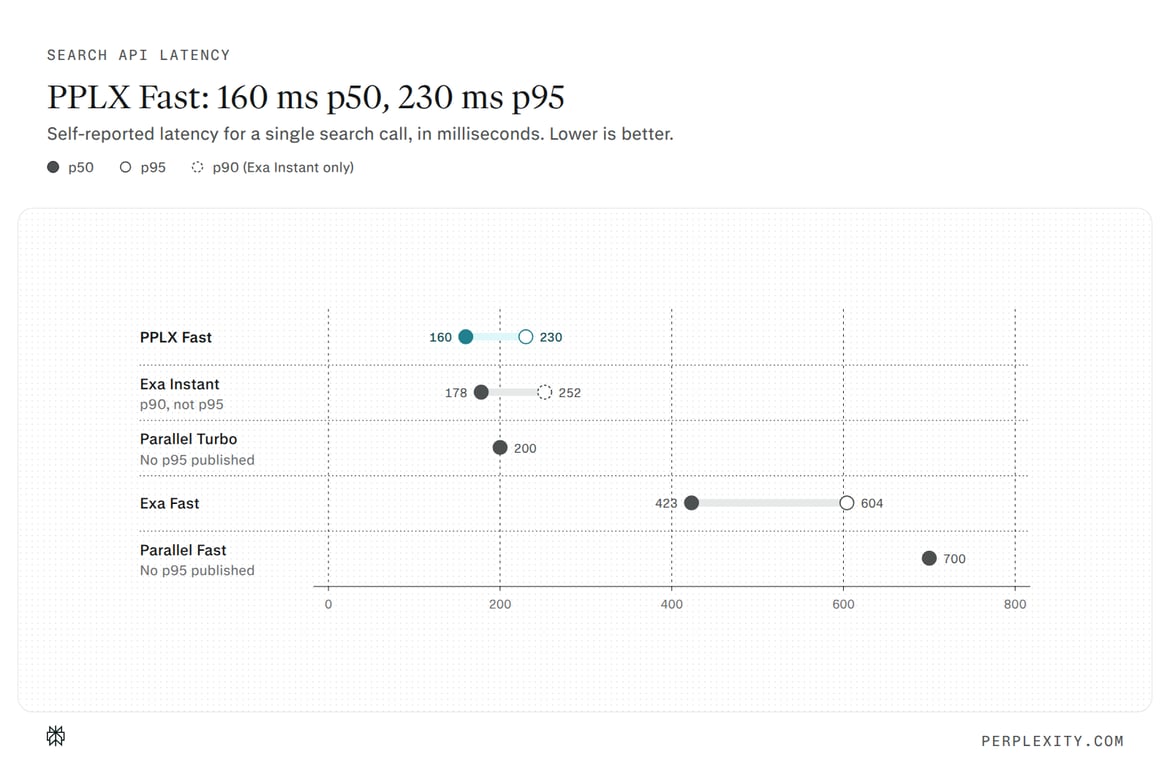
- ارائه حالت Fast Search در Search API با ثبت میانه تاخیر ۱۶۰ میلیثانیهای و تاخیر صدک نودوپنج ۲۳۰ میلیثانیهای
- کاهش ۶۸ درصدی هزینههای ترکیبی مدل و جستجو در بنچمارکهای استاندارد به بهای افتی اندک در دقت رتبهبندی
- تفکیک کامل فرایند ساخت ایندکس از سرورهای پاسخدهی به کوئریها جهت حذف نوسانات تاخیر
بازطراحی موتور جستجوی Perplexity برای تسریع فرایند کاری ایجنتها
شرکت Perplexity از موتور اختصاصی بازیابی و رتبهبندی خود با نام Photon پرده برداشت که از پایه با زبان Rust بازنویسی شده است. این شرکت همچنین حالت پیشفرض جدیدی به نام Fast Search را به سرویس Search API میزبانیشده خود افزوده تا توسعهدهندگان گزینهای با تاخیر بهمراتب کمتر برای ایجنتهایی که جستجوهای پیاپی انجام میدهند، در اختیار داشته باشند.
موتور Photon مدیریت زیرساخت پایهای بازیابی اطلاعات را بر عهده دارد، در حالی که قابلیت Fast Search میزان توان پردازشی اختصاصیافته برای رتبهبندی نتایج در API را تنظیم میکند. طبق دادههای منتشرشده از سوی Perplexity، میانه تاخیر این API به ۱۶۰ میلیثانیه و تاخیر صدک نود و پنجم (p95) آن به ۲۳۰ میلیثانیه رسیده است؛ همچنین تخمین زده میشود هزینه ترکیبی مدل و جستجو به ازای هر وظیفه در بنچمارکها تا ۶۸ درصد در مقایسه با حالت پیشفرض کاهش یافته باشد. البته ارزیابیهای درونی نشان میدهد این افزایش سرعت با افتی ملموس در دقت رتبهبندی نتایج همراه بوده است.
بررسی ارقام عملکرد در لایههای مختلف
معیار سنجش | نتیجه گزارششده | محدوده بررسی |
|---|---|---|
تاخیر در حالت Fast Search | ۱۶۰ میلیثانیه برای p50 و ۲۳۰ میلیثانیه برای p95 | یک فراخوانی منفرد در Search API |
تاخیر دنباله (Tail Latency) در Photon | حدود ۶۵ میلیثانیه برای p99 | موتور بازیابی در محیط عملیاتی |
تاخیر در موتور قبلی | حدود ۸۰۰ میلیثانیه برای p99 | موتور بازیابی در محیط عملیاتی |
تخمین هزینه به ازای هر وظیفه | ۶۸ درصد کمتر | هزینههای مدل و جستجو در ۶ بنچمارک عمومی |
ظرفیت سرورهای سرویسدهی | نیاز به حدود ۲۰ درصد ماشینهای معادل کمتر | در مقایسه با نودهای سرویسدهی محتوای قبلی |
دادههای پردازششده به ازای هر سند | حدود ۲٫۵ برابر بیشتر | در مقایسه با موتور پیشین |
شاخص p50 نشاندهنده میانه تاخیر است؛ به این معنا که نیمی از درخواستهای ثبتشده در زمانی کمتر از این مقدار به پایان رسیدهاند. شاخصهای p95 و p99 نیز بیانگر وضعیت درخواستهای کندتر در انتهای دنباله توزیع هستند. از آنجا که تاخیر ۶۵ میلیثانیهای در صدک ۹۹ متعلق به زیرساخت Photon و تاخیر ۱۶۰ میلیثانیهای صدک ۵۰ مربوط به Fast Search در دو لایه متفاوت اندازهگیری شدهاند، این ارقام شاخصهایی مستقل بهشمار میروند و نباید مستقیماً با یکدیگر مقایسه شوند.
چرا معماری قدیمی با افت سرعت مواجه شد؟
شرکت Perplexity پیش از این از یک نسخه اختصاصی (فورکشده) از موتورهای جستجوی متنباز استفاده میکرد که مدل ذخیرهسازی و ایندکسگذاری آن توان پاسخگویی به بارهای کاری سنگین این پلتفرم را نداشت. حجم دادهها فراتر از حافظه رم (RAM) در دسترس رشد کرده بود و این مسئله باعث میشد خواندن اطلاعات قدیمی و سرد، خطاهای حافظه (Major Page Faults) متعددی را به بار آورد؛ چرا که سیستمعامل ناچار بود دادهها را مستقیماً از دیسک فراخوانی کند.
از سوی دیگر، ادغامهای دورهای ایندکسها عامل دیگری در افزایش تاخیر دنباله به شمار میرفت. در جریان این فرایندها، زمان پاسخدهی در صدک ۹۹ از حدود ۸۰۰ میلیثانیه به رقمی در حدود ۱٫۲ ثانیه افزایش مییافت و این وضعیت برای بازههای زمانی ۱۰ تا ۱۵ دقیقهای ادامه پیدا میکرد. علاوه بر این، آمادهسازی یک کلاستر جدید یا بازیابی نودی که دچار اختلال شده بود، گاهی به بیش از یک هفته زمان برای همگامسازی دادهها نیاز داشت.
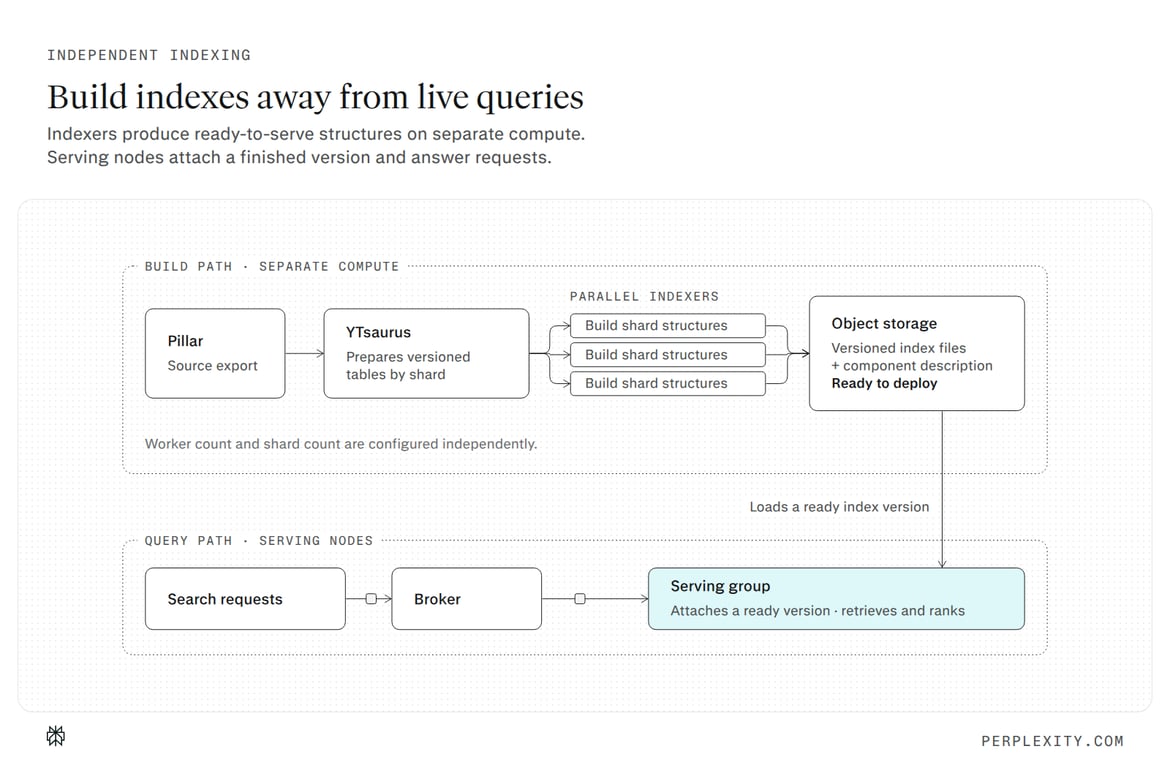
تیم مهندسی این شرکت به کمک ایجنتهای کدنویسی، آن سیستم سنتی را با Photon جایگزین کرد. معماری جدید دسترسی به دیسک را به شکلی دقیق و صریح کنترل میکند، دادههای رتبهبندی را در قالب فشردهتری ذخیره میسازد و فرایند ساخت ایندکس را از سرورهایی که کوئریهای زنده کاربران را پاسخ میدهند، تفکیک کرده است.
چهار ستون اصلی در طراحی معماری Photon
- ایندکسهای معکوس آگاه به فرمت (Format-aware inverted indexes):
یک ایندکس معکوس، هر واژه را به اسناد حاوی آن واژه نگاشت میکند. موتور Photon فهرستهای کوتاه ارسال را به صورت مستقیم در یک صفحه ذخیره میکند و فهرستهای طولانیتر را به بلوکهای مجزا تقسیم مینماید. بلوکهای پراکنده با استفاده از آرایهها و جستجوی جهشی (Galloping Search) پیمایش میشوند که از میان شناسههای مرتبشده اسناد جهش میکند؛ در حالی که بلوکهای پرتراکم بر پایه بیتمپها (Bitmaps) پیادهسازی شدهاند. همچنین فهرستهایی که مرتباً فراخوانی میشوند، در مجاورت یکدیگر روی دیسک قرار میگیرند تا عملیات خواندن به حداقل برسد. - ثبت فوقفشرده دادههای رتبهبندی (Compact ranking records):
هر سند حاوی یک «docblob» اختصاصی است که فراوانی کلمات، ماسک فیلدها و موقعیت واژهها را در خود نگه میدارد. موتور Photon این مقادیر ترتیبی را با استفاده از الگوریتم Elias-Fano فشردهسازی میکند که روشی بسیار کارآمد برای نمایش دنبالههای صعودی اعداد صحیح است. به لطف این رویکرد، ماژول رتبهبندی میتواند دادههای مربوط به یک واژه جستجو را بدون نیاز به رمزگشایی کامل کل پرونده یا انجام عملیات خواندن پراکنده، به سرعت استخراج کند. - ورودی/خروجی ناهمگام و دستهای (Batched asynchronous I/O):
موتور Photon پیش از ثبت هرگونه درخواست خواندن روی دیسک از طریق رابط مدرنio_uringدر لینوکس، حافظه کش رم را بررسی میکند. تردهای مجزای Reactor درخواستها را به صورت دستهای گروهبندی کرده و زمانهای انتظار دیسک را همپوشانی میکنند؛ رویکردی که در مقایسه با طراحیهای مبتنیبر نگاشت حافظه (Memory-mapped) که وابسته به Page Fault سیستمعامل هستند، کنترل بسیار بیشتری به موتور جستجو میبخشد. - انتخاب نامزدها با بودجه مشخص (Budgeted candidate selection):
الگوریتمی مبتنیبر سبک WAND فهرستهای واژگان را به دو بخش «فهرستهای هدایتکننده» (برای پیشنهاد اسناد اولیه) و «فهرستهای کاوشگر» (برای افزودن دادههای امتیازدهی تکمیلی) تقسیم میکند. تعیین سقف امتیازی باعث میشود نامزدهای ضعیف پیش از اجرای فرایندهای سنگین خواندن فراوانی واژهها حذف شوند و به این ترتیب، میزان پردازش هر کوئری در چارچوب یک سقف محاسباتی از پیش تعیینشده باقی بماند.
تفکیک کامل ساخت ایندکس از مسیر پردازش درخواستها
در معماری جدید، فرایند تولید و ساخت ایندکسها روی نودهای کاملاً مجزا و دور از ماشینهای پاسخدهنده به کاربران اجرا میشود. ماژولهای ایندکسگذار ساختارهای نسخهبندیشده و آماده سرویسدهی را روی فضاهای ذخیرهسازی ابری (Object Storage) مینویسند و یک بخش کنترلکننده مرکزی، هر نسخه را به نوبت برای یک گروه از سرورهای عملیاتی مستقر میکند.
هر گروه از سرورها پیش از دریافت ترافیک واقعی، یک مرحله گرمسازی (Warmup) را بر پایه لاگهای گذشته جستجو پشت سر میگذارد. کنترلکننده مرکزی پس از اطمینان از سلامت و آمادگی کامل ایندکسها، این گروه را به مسیر مسیریابی ترافیک بازمیگرداند. این سازوکار، فرایند سنگین ساخت ایندکس را از مسیر اجرای کوئریها حذف کرده، جهشهای ناگهانی تاخیر را در زمان بهروزرسانی برطرف میکند و چرخه چندروزه همگامسازیهای پیشین را پایان میدهد.
بهای سرعت؛ کاهش نسبی کیفیت بازیابی
بررسیهای داخلی Perplexity حاکی از افت نسبی امتیاز بازیابی در حالت Fast Search است؛ چرا که در این پیکربندی توان محاسباتی کمتری به رتبهبندی نتایج اختصاص مییابد. معیار Relevance DCG (که مقادیر بالاتر آن نشاندهنده رتبهبندی دقیقتر است) ۰٫۲۴ امتیاز افت کرده و شاخص در دسترس بودن پاسخ نیز ۲٫۹ درصد کاهش یافته است.
شاخص | حالت پیشفرض | حالت Fast Search | تفاوت |
|---|---|---|---|
معیار رتبهبندی Relevance DCG | ۲٫۴۵ | ۲٫۲۱ | ۰٫۲۴- |
در دسترس بودن پاسخ (Answer availability) | ۵۹٫۶٪ | ۵۶٫۷٪ | ۲٫۹- درصد |
با وجود افت شاخصهای اولیه بازیابی، نتایج حاصل از اجرای ۶ بنچمارک عمومی نشان داد که خروجی نهایی مدل در پاسخ به وظایف مختلف تغییر چندانی نکرده است. شرکت Perplexity دلیل این موضوع را توانایی استدلال مدلهای زبانی میداند؛ زیرا این مدلها میتوانند حتی از میان مجموعهای از نتایج با رتبهبندی نهچندان بینقص، اطلاعات موردنیاز خود را استخراج کنند. با این حال در تسکهایی با پرسشهای مبهم، توان استدلال محدود مدل یا نیاز شدید به استناد دقیق به منابع، این شکاف در کیفیت بازیابی خود را با وضوح بیشتری نشان خواهد داد.
انتخاب حالت مناسب بر اساس سناریوی کاری
زمانی که یک ایجنت هوش مصنوعی دهها جستجوی متوالی انجام میدهد، تاخیر و هزینه در هر مرحله به شکل تصاعدی انباشته میشود. بنابراین، حالت Fast Search بهترین انتخاب برای جریانهای کاری تکرارشونده و تعاملی است؛ جاهایی که مدل اطلاعات را در طول فراخوانیهای متعدد جمعآوری کرده و خود توانایی پالایش و بازرتبهبندی دادهها را دارد.
سناریوی کاری | گزینه پیشنهادی | دلیل |
|---|---|---|
تحقیقات چندمرحلهای (Multi-hop) با جستجوهای متعدد | Fast Search | انباشت شدید تاخیر و هزینه جستجو در فراخوانیهای مکرر |
ایجنتهای مرور وب و چرخههای Deep Research | Fast Search | بررسی صفحات پرشمار توسط مدل پیش از تدوین پاسخ نهایی |
سیستمهای RAG مجهز به ماژول بازرتبهبندی (Reranking) مجزا | Fast Search (پس از ارزیابی اولیه) | جبران ضعف اولیه در چیدمان نتایج توسط رتبهبند اختصاصی |
پرسشهای حساس، مبهم و حیاتی | حالت پیشفرض (Default) | اولویت قطعی دقت در بازیابی نسبت به سرعت پاسخدهی |
پرسشهای تکی و با ارزش بالا از سوی کاربر | حالت پیشفرض (Default) | محدود بودن صرفهجویی مالی در یک فراخوانی منفرد |
کاهش ۶۸ درصدی گزارششده نشاندهنده برآورد صرفهجویی در هزینه تجمیعی مدل و جستجو به ازای تکمیل هر وظیفه در بنچمارکها است و نباید آن را تخفیف مستقیم بر تعرفه API تلقی کرد. میزان صرفهجویی واقعی برای هر توسعهدهنده به حجم فراخوانیها، مدل مورد استفاده، پیچیدگی درخواست و تعداد جستجوهای اضافهای بستگی دارد که در صورت دریافت نتایج اولیه ضعیفتر نیاز خواهند شد.
ضرورت ارزیابی کل چرخه کاری ایجنتها
تیمهایی که قصد دارند Fast Search را بررسی کنند، بهتر است سناریوهای واقعی خود را روی هر دو حالت اجرا کرده و کل جریان کاری را مقایسه نمایند، نه اینکه صرفاً زمان پاسخدهی یک درخواست تک را ملاک قرار دهند. یک ارزیابی جامع باید شامل موارد زیر باشد:
- سنجش تاخیر سرتاسری (End-to-End) در صدکهای p50، p95 و p99 برای هر وظیفه
- تعداد فراخوانیهای جستجو و توکنهای مصرفی مدل تا دستیابی به نتیجه نهایی
- میزان ارتباط محتوای بازیابیشده، پوششدهی پاسخها و دقت ارجاع به منابع
- نرخ خطا در کوئریهای پیچیده، کمیاب (Long-tail) و نیازمند دادههای کاملاً بهروز
- محاسبه هزینه مجموع مدل و جستجو به ازای هر نتیجه موفق
این قابلیت تازه هماکنون از طریق کنسول Search API در دسترس توسعهدهندگان قرار گرفته و زیرساخت Photon توسط خود Perplexity میزبانی میشود. به این ترتیب، برنامهنویسان میتوانند حالت Fast Search را در سطح API انتخاب کنند و در عین حال، برای سناریوهایی که نیازمند محاسبات سنگینتر رتبهبندی هستند، همچنان از حالت پیشفرض بهره ببرند.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی

رکورد ۸۳۳ هزار دانلود ماهانه برای LEGAL-BERT؛ وقتی توسعهدهندهها قید مدلهای گرانقیمت را میزنند!
مدل زبانی تخصصی LEGAL-BERT با ثبت بیش از ۸۳۳ هزار دانلود در ماه روی پلتفرم هاگینگ فیس حسابی خبرساز شده است. این ابزار جمعوجور و تخصصی نشان میدهد که برای پردازش و تحلیل متون حقوقی، حتماً نیازی به مدلهای غولپیکر و پرهزینه ندارید و گزینههای بهینه همچنان در اوج هستند.

جاسوسی هوش مصنوعی در محل کار؛ کارمندان میگویند کارفرماها باید قانوناً مچگیریهایشان را لو بدهند!
نظرسنجیهای تازه نشان میدهد که بیشتر کارمندان حس میکنند مدیرانشان با ابزارهای هوش مصنوعی تمام حرکات آنها را زیر نظر گرفتهاند. حالا بیش از ۸۰ درصد شاغلان خواستار تصویب قانونی شدهاند که شرکتها را مجبور کند هرگونه مچگیری و نظارت هوش مصنوعی در محیط کار را رسماً اعلام کنند.

گزارش داغ مایکروسافت از نفوذ جهانی هوش مصنوعی؛ امارات در صدر و رتبه عجیب آمریکا!
مایکروسافت در تازهترین گزارش خود از ضریب نفوذ هوش مصنوعی در جهان پرده برداشت؛ آماری شگفتانگیز که نشان میدهد امارات و سنگاپور با فاصلهای خیرهکننده پیشتاز دنیا هستند و در مقابل، آمریکا در رتبه ۲۱ جا مانده است. همچنین الگوی استفاده از هوش مصنوعی میان کشورهای غربی و کشورهای در حال توسعه، از تفاوتی عمیق میان کاربردهای روزمره و آموزش پرده برمیدارد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.