محققان با تبدیل خودکار مقالات علمی به کد، کارایی ایجنتهای هوش مصنوعی را بدون بازآموزی ارتقا دادند
محققان مایکروسافت و دانشگاه کالیفرنیا فریمورک جدیدی به نام ScholarEvolve توسعه دادهاند که با تحلیل مقالات پژوهشی و تبدیل آنها به کدهای پایتون، توانایی ایجنتهای هوش مصنوعی را بهشکل چشمگیری ارتقا میدهد. این روش بدون نیاز به تغییر یا بازآموزی وزنهای مدل، بخش عمدهای از فاصله کارایی مدلهای وزنباز با سیستمهای پیشرفته را جبران میکند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- فریمورک نوآورانه ScholarEvolve با تحلیل مقالات آرکایو (arXiv) و تبدیل تکنیکهای علمی به کدهای پایتون، قابلیتهای ایجنتهای هوش مصنوعی را ارتقا میدهد.
- در آزمونهای بنچمارک، این روش توانست بدون دستکاری وزنهای مدل Qwen3.5-27B، حدود ۷۴ درصد از فاصله عملکردی آن با مدل پیشرفته GPT-5.4 را جبران کند.
- با تفکیک ایجنت به ۵ ماژول مجزا و تست خودکار سلامت کد، تیمهای مهندسی میتوانند بدون هزینههای سنگین بازآموزی، ایجنتهای دقیقتری توسعه دهند.
ایجنتهای هوش مصنوعی این روزها به قابلیتهای جدیدی مجهز شدهاند تا بتوانند بخشهای مختلف ساختار خود، از جمله پرامپتها، مدیریت زمینه (کانتکست)، جریانهای کاری و کدهای اجرایی را بهینهسازی کنند. با این حال، بهینهسازهای خودتکاملیافته فعلی معمولاً فقط به دانش پیشین مدل پایه یا مسیرها و تجربیاتی متکی هستند که ایجنت تا به این لحظه در تعاملاتش پشت سر گذاشته است.
اکنون فریمورک جدیدی که توسط پژوهشگران دانشگاه کالیفرنیا در سانتا باربارا (UCSB) و مایکروسافت توسعه یافته، این گلوگاه را هدف قرار داده است. این فریمورک که ScholarEvolve نام دارد، اطلاعات و ایدههای جدید را بهصورت خودکار از مقالات علمی استخراج کرده و آنها را در قالب بهروزرسانیهای کدی به بدنه هارنس ایجنت تزریق میکند.
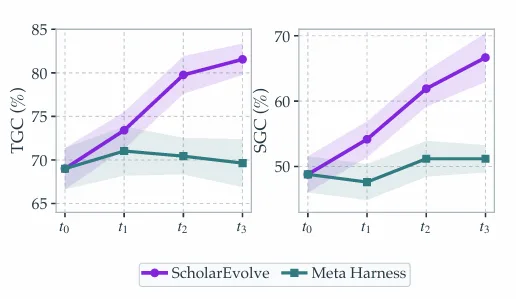
در آزمونهای بنچمارک، ScholarEvolve موفق شد نرخ تکمیل موفق وظایف را در مدل وزنباز Qwen3.5-27B در مجموعه آزمایشی AppWorld Normal از ۶۹٫۰ درصد به ۸۱٫۴ درصد برساند؛ جهشی چشمگیر که بدون نیاز به تغییر حتی یک وزن از مدل، حدود ۷۴ درصد از فاصله عملکردی آن را با مدل پرچمدار GPT-5.4 جبران کرد.
برای تیمهای مهندسی در سازمانها، این رویکرد مسیری تازه برای افزایش کارایی ایجنتها بدون نیاز به بازآموزی پرهزینه مدلهای پایه فراهم میکند و همزمان نقشهای جامع برای بهروزرسانی مداوم هارنس ایجنت و سازگاری با APIهای ناآشنا ارائه میدهد.
نقطه بنبست بهینهسازهای فعلی ایجنت
طی سال گذشته، فریمورکهای خودکار بهینهسازی هارنس معمولاً یکی از دو مسیر کلی را دنبال کردهاند. دسته اول ابزارهای مبتنی بر مؤلفههای خاص، نظیر WikiSkill گوگل، SkillOpt مایکروسافت و Memento-Skills هستند که تاریخچه اجرای ایجنت را تحلیل میکنند تا یک بخش خاص از سیستم، مانند کتابخانه مهارتها یا حافظه را بهبود بخشند.
در سوی دیگر، بهینهسازهای جامع هارنس مانند DarwinX سیلزفورس، HarnessX شیائومی، Self-Harness و Meta-Harness دانشگاه استنفورد قرار دارند که با استفاده از یک «متا-ایجنت» کدنویس، گزارشهای خطا را بررسی کرده و ساختار پایه یا قوانین عملیاتی ایجنت را بازنویسی میکنند.
اگرچه این روشها کاربردی هستند، اما تیم پژوهشگران این پروژه استدلال میکنند که تکیه صرف بر بازخورد حاصل از اجرای وظایف، یک چرخه بسته ایجاد میکند که خیلی زود به نقطه بازده نزولی میرسد.
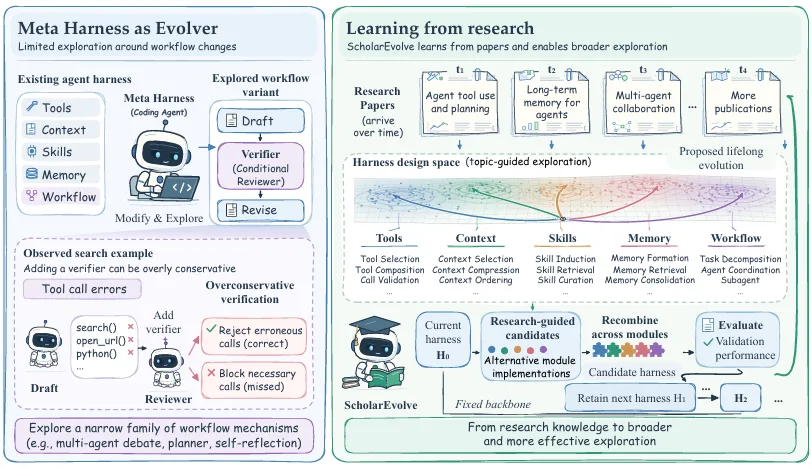
نخست آنکه متا-ایجنت همواره در چارچوب دانش پارامتریک مدل پایه خود محدود میماند. محققان در این زمینه مینویسند: «راهکارهایی که یک متا-ایجنت پیشنهاد میدهد، کاملاً وابسته به دانش و توان استدلال مدل پشتیبان آن است. ردیابی یک خطا ممکن است جای خالی یک قابلیت را برملا کند، اما راهنمایی چندانی درباره تکنیک مورد نیاز برای پیادهسازی آن ارائه نمیدهد.»
هنگامی که یک متا-ایجنت کدنویس با خطاهای پیاپی در فراخوانی ابزارها روبهرو میشود، اغلب به الگوهای تکراری مهندسی نرمافزار، نظیر افزودن یک مرحله اعتبارسنجی یا حلقه بحث میان چند ایجنت پناه میبرد. برای نمونه در این بررسی، متا-ایجنت پس از مشاهده خطاهای مکرر در جستجو و فراخوانی ابزارهای پایتون، یک ماژول بازبینی شرطی برای بررسی تکتک اقدامات اضافه کرد. با وجود اینکه این ماژول مانع فراخوانیهای نادرست شد، اما بهشدت محتاطانه عمل کرد و حتی فراخوانیهای معتبر API را که برای تکمیل مأموریت ضروری بودند مسدود ساخت.
مسئله دیگر این است که تکامل مبتنی بر ردگیری خطاها ماهیتی واکنشی دارد. محققان توضیح میدهند: «تکاملی که بر پایه مسیرهای طیشده و بازخورد خطاها هدایت میشود، شواهد خود را صرفاً از موقعیتهایی به دست میآورد که قبلاً رخ دادهاند. در نتیجه در محیط عملیاتی، یک نقطهضعف ممکن است پیش از آنکه شواهد کافی برای ارتقای سیستم جمعآوری شود، تجربه کاربران را تحت تأثیر قرار دهد و مشکلساز شود.»
این محدودیتها تیم تحقیقاتی را به طرح یک سؤال بنیادین سوق داد: «یک پژوهشگر باتجربه چگونه میتواند به راهکارهایی برای ارتقای سیستم دست یابد که تجربه خودِ ایجنت هنوز موفق به کشف آنها نشده است؟»
نگاهی به معماری و سازوکار ScholarEvolve
فریمورک ScholarEvolve خطاهای رخداده در یک مجموعه آموزشی را تحلیل میکند، در مقالات علمی به دنبال تکنیکهایی برای رفع آنها میگردد، آن تکنیکها را در ماژولهای هارنس پیادهسازی مینماید و نحوه همکاری این بخشها با یکدیگر را ارزیابی میکند.
برای جلوگیری از اینکه تغییرات کدی در یک بخش ایجنت باعث از کار افتادن بخشهای دیگر شود، ScholarEvolve هارنس ایجنت را به پنج ماژول مجزا با رابطهای ورودی و خروجی سختگیرانه تقسیم کرده است: رابط ابزارها، مدیریت زمینه (کانتکست)، مهارتها، حافظهها و جریانهای کاری ایجنتیک.
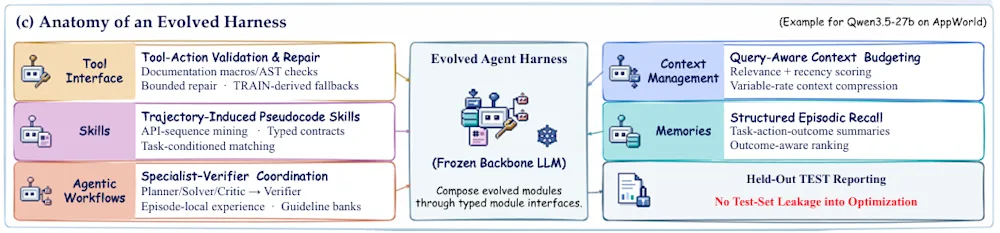
چرخه بهینهسازی این سیستم در چهار مرحله انجام میشود:
حسابرسی خطاها و بازیابی مقالات علمی: یک مدل حسابرس وظایف ناموفق را در مجموعهدادههای آموزشی بررسی کرده و کمبودهای مهارتی عمومی، نظیر از دست دادن سرنخ مشاهدات قبلی یا ناتوانی در بازیابی بعد از خطاهای ساختاری (Syntax Errors) را شناسایی میکند. سپس کوئریهای جستجویی برای دریافت چکیده و متن مقالات مرتبط از پایگاه آرکایو (arXiv) تولید مینماید.
مدلسازی موضوعی برای کشف ایدههای متنوع: برای جلوگیری از واکشی مقالات تکراری یا مشابه، ScholarEvolve از روش مدلسازی موضوعی به نام TopicGPT استفاده میکند که مقالات را بر اساس خانواده ساختاریشان در هر ماژول دستهبندی مینماید. این کار تضمین میکند که ایجنت کدنویس، ایدههای مهندسی متنوعی را مورد آزمایش قرار دهد.
طرحهای اولیه و بررسیهای سلامت کد (Health Probes): برای هر مقاله انتخابشده، یک ایجنت پژوهشگر متن کامل و کدهای رسمی منتشرشده را بررسی میکند تا نقشه تغییرات (Mutation Blueprint) را تدوین کند. سپس یک ایجنت کدنویس پیادهسازی پایتون را منحصراً برای آن ماژول مینویسد، در حالی که چهار ماژول دیگر ثابت باقی میمانند. در ادامه، آزمایشهای خودکار سلامت کد اطمینان حاصل میکنند که کد جدید بدون مشکل ایمپورت میشود، قراردادهای رابط را رعایت میکند و پیش از ارزیابی نهایی، اقدامات معتبری انجام میدهد.
ترکیب ماژولها و انتخاب نهایی (Crossover): پس از امتیازدهی به بهروزرسانیهای هر ماژول در دادههای اعتبارسنجی، ScholarEvolve با استفاده از فرآیند ترکیب ژنتیکی، ماژولهای برتر را در قالب هارنسهای کامل با یکدیگر ترکیب میکند. هر گزینه ترکیبی از آزمون رگرسیون مشترک عبور میکند و یک ارزیابی آماری دقیق تضمین مینماید که تنها بهبودهای قطعی و اثباتشده جایگزین نسخه برتر فعلی شوند.
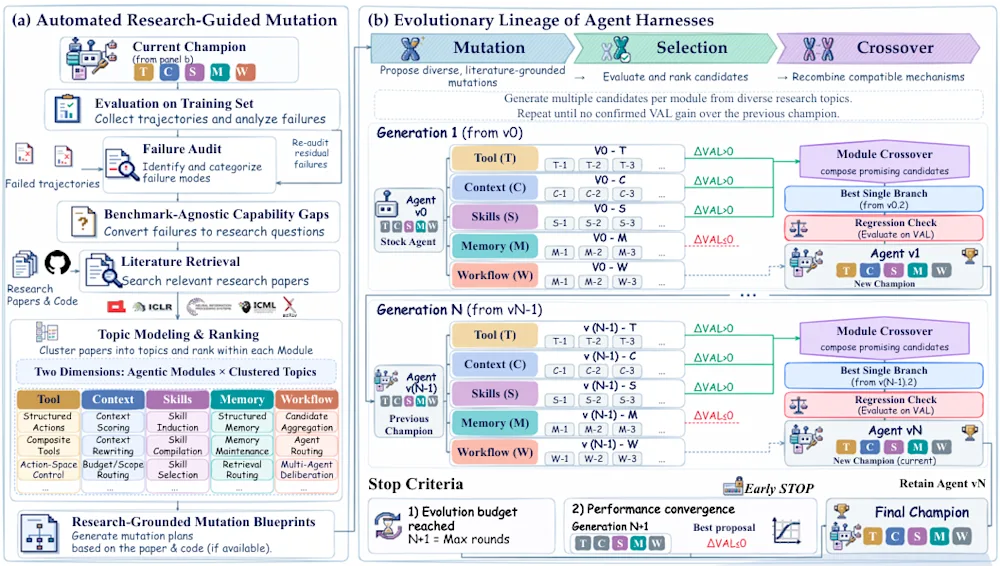
بهعنوان نمونه، هنگامی که فریمورک ScholarEvolve روی مدل Qwen3.5-27B در محیط AppWorld پیاده شد، سه ارتقای شاخص را بههمراه داشت:
رفع فراخوانیهای نابینای API (رابط ابزارها): مدل پایه بارها سینتکس نادرست پایتون تولید میکرد یا پارامترهای API را بدون مطالعه مستندات حدس میزد. ScholarEvolve مکانیزمی برگرفته از مقاله ToolACE-R را پیاده کرد که یک بررسی درخت نحو انتزاعی (AST) برای اعتبارسنجی دستورات پایتون پیش از اجرا به سیستم میافزود؛ افزون بر این، ماکرویی تعبیه شد که در لحظه، کدهای پایتون را برای چاپ مستندات API گسترش میداد.
جلوگیری از گم شدن سرنخها و مشاهدات قبلی (مدیریت کانتکست): تاریخچههای طولانی مکالمات باعث میشد ایجنت از سقف حجم زمینه فراتر رود یا شواهد اولیه را فراموش کند. فریمورک با الهام از یک مقاله پژوهشی پیرامون محدودیتهای فشردهسازی پرامپت، یک ماژول تخصیص هوشمند بودجه توسعه داد که سیاستهای سیستمی را دستنخورده نگه میدارد، به تاریخچه تعاملات بر اساس ارتباط با وظیفه و جدید بودن امتیاز میدهد و سقف کاراکترها را با حفظ ترتیب زمانی اختصاص میدهد.
پایان دادن به اختراع دوباره توالیهای API (مهارتها): سیستم بهجای آنکه به ایجنت اجازه دهد در هر اجرا توالیهای چندمرحلهای فراخوانی API را از نو کشف کند، از رویکرد مقاله Skill-as-Pseudocode بهره گرفت. این رویکرد توالیهای تکرارشونده و موفق API را از دادههای آموزشی استخراج کرده و آنها را در قالب الگوهای شبهکد تایپشده گردآوری نمود.
عملکرد ScholarEvolve در میدان آزمون
پژوهشگران فریمورک ScholarEvolve را در دو بنچمارک تعاملی که جنبههای مختلف محیطهای سازمانی را شبیهسازی میکنند محک زدند: بنچمارک AppWorld که در آن ایجنتها به کدنویسی و فراخوانی APIها میان برنامههای مختلف میپردازند، و tau-Bench Telecom که در آن ایجنتها مشکلات خدمات مشتریان، داده تلفن همراه و پیامرسانی را با یک کاربر شبیهسازیشده حلوفصل میکنند. آنها هارنس پایه را با مدلهای Qwen3.5-27B و GPT-5.4-mini تکامل بخشیدند و عملکرد آنها را در برابر هارنسهای اولیه، Meta-Harness دانشگاه استنفورد و مجموعهای از مدلهای پیشگام سنجیدند.
در تمام معیارهای مورد بررسی، ScholarEvolve کارایی هر دو مدل پایه را ارتقا داد. در بنچمارک AppWorld، هارنس تکاملیافته Qwen3.5-27B با جهشی ۱۲٫۴ درصدی در تکمیل هدف وظایف (TGC) و افزایشی ۲۰٫۲ درصدی در تکمیل اهداف سناریو (SGC) که مستلزم موفقیت در سه حالت متغیر از یک سناریوی واحد است، روبهرو شد. در بخش Telecom نیز این فریمورک امتیاز مدل GPT-5.4-mini را از ۷۲٫۷ درصد به ۸۱٫۹ درصد رساند.
تیم پژوهشگران در گزارش خود خاطرنشان میکنند: «طراحی هارنس تأثیر چشمگیری بر توانمندیهای نهایی یک مدل پایه دارد.»
برای توسعهدهندگان سیستمهای سازمانی، چند یافته مهم از این آزمایشها به دست آمده که قابل توجه است:
تعمیمپذیری بدون داده قبلی (Zero-shot) به برنامههای جدید و APIهای پیچیده: چالش AppWorld ایجنتها را با APIهای آمازون و جیمیل مورد ارزیابی قرار میدهد که هرگز در مجموعههای تکامل یا اعتبارسنجی وجود نداشتهاند. با بهرهگیری از هارنس تکاملیافته، مدل Qwen3.5-27B جهشی از ۴۹٫۶ درصد به ۶۳٫۶ درصد (۱۴٫۰ درصد رشد) ثبت کرد و Meta-Harness را با اختلاف ۹٫۰ درصدی پشت سر گذاشت.
چرا بهینهسازی یک ماژول بهصورت منفرد تیمها را به اشتباه میاندازد: در آزمایش تفکیک مؤلفهها روی وظایف توسعه، ارتقای مجزای ماژول مهارتها برای مدل Qwen3.5-27B بهتنهایی امتیاز ۷۵٫۴ درصد گرفت، در حالی که ماژول Skill-as-Pseudocode بهتنهایی امتیاز پایینترِ ۷۳٫۷ درصد را ثبت کرد. با این حال، وقتی این ماژول با ماژولهای تکاملیافته رابط ابزار، زمینه، حافظه و جریان کاری ترکیب شد، سیستم کلی قدرتمندتری ساخت (۸۴٫۸ درصد در برابر ۸۰٫۷ درصد تکمیل وظایف). محققان تأکید میکنند: «بنابراین، امتیازات کسبشده در حالت تکماژوله نشاندهنده بهترین ترکیب نهایی سیستم نیستند.»
بازیابی و جبران خطا در میانه مسیر: در محیطهای عملیاتی، بروز خطا در فراخوانی ابزارها امری اجتنابناپذیر است. آنچه ایجنتهای پایدار را از سیستمهای شکننده متمایز میکند، نحوه واکنش آنها به پیامهای خطا (Traceback) است. در چالش AppWorld، میان اجراهایی که با خطای میانی اجرای پایتون مواجه شدند، هارنس تکاملیافته Qwen3.5-27B موفق شد در ۵۹٫۹ درصد موارد کار را به پایان برساند؛ رقمی که برای هارنس پایه ۴۴٫۹ درصد بود. محققان مینویسند: «این آمار نشان میدهد که چرا بروز یک خطای میانی معیار کاملی برای قضاوت درباره توانایی ایجنت نیست؛ چراکه بسیاری از مأموریتهای موفق مستلزم استفاده از همان خطای بازگشتی برای اصلاح اقدامات بعدی هستند.»
ملاحظات پیادهسازی برای تیمهای سازمانی
پژوهشگران به یک مخزن گیتهاب ارجاع دادهاند که البته در زمان انتشار این پژوهش خالی بوده است؛ با این حال پیوستهای مقاله حاوی بخشهایی از کدهای پنج ماژول برگزیده هارنس است. از آنجا که وزنهای مدل پایه در سراسر این فرآیند دستنخورده باقی میمانند، تیمهای مهندسی نیازی به ذخیره و مدیریت چکپوینتهای سفارشی مدل نخواهند داشت.
اگر قصد بهکارگیری این دستاوردها را دارید، باید توجه داشته باشید که فریمورک ScholarEvolve مقالات و کدهای رسمی مرتبط با آنها را دریافت میکند و آزمونهای خودکار سلامت کد، مواردی نظیر قابلیت ایمپورت پایتون، سازگاری رابطها، ساخت خروجیها و قالببندی معتبر اقدامات را بررسی مینمایند. با این حال، در این مقاله اشارهای به اسکن امنیتی برای بررسی وابستگیهای مخرب در مقالات یا کدهای متفرقه، الگوهای ناامن اجرا یا آسیبپذیریهای تزریق پرامپت (Prompt Injection) نشده است.
تیمهای سازمانی نباید به یک متا-ایجنت اجازه دهند تغییرات کدیِ بررسینشده برگرفته از مقالات را مستقیماً وارد محیط عملیاتی کند. در عوض، تیمها باید یک درگاه اعتبارسنجی امنیتی ایجاد کنند یا فریمورک را به مخزن داخلی و گزینششدهای از مقالات تأییدشده و اسناد طراحی مهندسی متصل نمایند.
همچنین باید در نظر داشت که تکامل هارنس نمیتواند تمام ایرادات موجود در چرخه عملکرد ایجنت را برطرف کند. این رویکرد نحوه قالببندی خروجیها، مدیریت حجم کانتکست و بازیابی پس از خطاهای API را اصلاح میکند، اما هرگز جایگزین حفاظهای امنیتی قطعی در درگاههای API نخواهد شد و ضعفهای سیستمهای بازیابی اطلاعات (Retrieval) در مراحل اولیه را نیز جبران نمیکند.
پژوهشگران همچنین سه دور متوالی از بهروزرسانیهای مبتنی بر مقالات علمی را بدون تغییر وزنهای مدل Qwen یا دادههای قبلی آزمایش کردند. کارایی مدل در هر سه دور در محیط AppWorld Normal بهبود یافت، هرچند که در این آزمایش سازگاری مداوم در یک محیط عملیاتی زنده سنجیده نشده است.
محققان در جمعبندی خود مینویسند: «تکامل بر پایه مقالات علمی بهصورت طبیعی از سازگاری پیشدستانه پشتیبانی میکند؛ مقالات جدید گزینههایی برای بهبود سیستم ارائه میدهند، حتی قبل از آنکه خطای متناظر با آنها در ایجنت عملیاتی مشاهده شود. برای نمونه، یک ایجنت مستقر در محیط کار میتواند هر ماه جدیدترین پژوهشها را بررسی کرده و بهروزرسانیهای امیدبخش را در وظایف اعتبارسنجی ارزیابی کند.»
مطالب مرتبط و پیشنهادی
مارک زاکربرگ با وجود تهدید مالیات سنگین میلیاردرها، برای هدایت پروژههای هوش مصنوعی در کالیفرنیا میماند
مارک زاکربرگ با وجود خطر مالیات چند میلیارد دلاری برای میلیاردرها، طبق توافقی هشتساله در کالیفرنیا خواهد ماند تا جاهطلبیهای هوش مصنوعی متا را هدایت کند. هیئتمدیره متا با طراحی ساختار سهامی جدید، نقدینگی لازم را برای توسعه مراکز داده هوش مصنوعی و ماندن زاکربرگ در سیلیکونولی فراهم کرده است.
بلکراک: بدهی سنگین غولهای فناوری برای زیرساخت هوش مصنوعی فرصتی تاریخی برای سرمایهگذاران است
مدیر ارشد سرمایهگذاری بلکراک از فرصتی کمنظیر در بازار اوراق قرضه شرکتی پرده برداشته است؛ جایی که غولهای فناوری برای توسعه زیرساختهای هوش مصنوعی صدها میلیارد دلار اوراق با بازدهی جذاب عرضه کردهاند. بااینحال، کارشناسان هشدار میدهند سرمایهگذاران باید در انتخاب شرکتهای کوچکتر حوزه هوش مصنوعی و مراکز داده بهشدت محتاط باشند.
آنتروپیک از Claude Duet پرده برداشت؛ ایجنت هوشمندی که حتی هنگام خواب کارهای شما را پیش میبرد
آنتروپیک از محصول جدیدی به نام Claude Duet رونمایی کرد؛ ایجنت خودکاری که حتی هنگام خاموش بودن لپتاپ یا گوشی، در پسزمینه حسابهای کاری شما را بررسی و وظایف محوله را اجرا میکند. این سیستم با بهرهگیری از مدل پیشرفته Opus 5.5، کارها را اولویتبندی کرده و تنها برای تأیید تصمیمهای مهم به سراغ کاربر میآید.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.