مدلهای هوش مصنوعی چگونه تصاویر علمی را تحلیل میکنند؟ تفاوت رویکردها در بنچمارک VIALS-AA
بررسی جامع شیوه تعامل مدلهای هوش مصنوعی با تصاویر علمی نشان میدهد که هر سیستم استراتژی بصری متفاوتی را دنبال میکند. در حالی که برخی مدلها بخش عمده توان خود را صرف برش و اندازهگیری دقیق پیکسلی میکنند، برخی دیگر با بازبینیهای سریع و استدلال متنی به پاسخ میرسند. ارزیابی بنچمارک VIALS-AA از تفاوت چشمگیر الگوهای پردازشی و هزینه عملیاتی مدلها پرده برمیدارد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- بیش از ۸۵ درصد از فراخوانی ابزارها توسط مدلهای هوش مصنوعی در تحلیل تصاویر علمی به مشاهده، آمادهسازی یا اندازهگیری پیکسلی اختصاص دارد.
- مدلهای خانواده Claude بیش از یکچهارم توان ابزاری خود را صرف اندازهگیری دقیق تصاویر میکنند در حالی که مدلهای GPT تمرکز بسیار کمتری بر این شیوه دارند.
- مدلهای قدرتمندتر به لطف توانایی تحلیلی بالاتر معمولاً با فراخوانی کمتر ابزارها و صرف هزینه بهینهتر به پاسخ نهایی دست پیدا میکنند.
نمای کلی
مسیرهای نمونه؛ رویکردهای گوناگون در تحلیل تصاویر علمی
بررسی سریع یا اندازهگیری دقیق؛ هر دو شیوه میتوانند کارآمد باشند
تفسیر تصاویر بدون اتکا به قابلیت بینایی ذاتی
تفاوت چشمگیر مدلها در شیوه استفاده از ابزارها
در بررسی عملکرد ۱۹ مدل مختلف در قالب ۹٬۱۷۷ اجرای آزمایشی، نحوه استفاده از ابزارها دستهبندی شد. بخش عمده این فراخوانیها مستقیماً با شواهد بصری در ارتباط بود. ۳۸٫۳ درصد از کل فراخوانیهای ابزار مربوط به مشاهده تصویر بود، در حالی که ۴۷٫۳ درصد از آنها به آمادهسازی یا اندازهگیری تصاویر اختصاص یافتفعالیتهایی که مواردی مانند برش زدن، بهبود نماها و استخراج ابعاد دقیق از پیکسلها را در بر میگرفت. سهم اندازهگیری تصویر در فراخوانی ابزارهای مدلهای GPT-6 Astra (max) و GPT-6.1 Sol (max) تنها ۵ تا ۶ درصد بود، در حالی که این رقم برای مدلهای Claude Opus 5.5 (max) و Claude Sonnet 5.5 (max) به ۲۵ تا ۲۷ درصد میرسید.
بنچمارک VIALS-AA: تعداد فراخوانی ابزار به ازای هر وظیفه
میانگین تعداد فراخوانی ابزار به ازای هر وظیفه، بر پایه میانگین سه تکرار مستقل محاسبه شده است.
فاقد رابط برنامهنویسی (API) در دسترس عموم
فراخوانیهایی که به پایان یا رها کردن وظیفه منجر میشوند از شمارش ابزارها کنار گذاشته شدهاند. مقادیر هر وظیفه بر اساس میانگین تکرارهای ثبتشده با حداکثر ۴۸۳ مشاهده برای هر مدل محاسبه شده است. تعداد فراخوانی ابزار در هر نوبت، حاصل تقسیم کل ابزارهای شمارششده بر مجموع نوبتهای کاری تکمیلشده توسط مدل است. تکرارهایی که فاقد تعداد نوبت ثبتشده هستند، مانند توقفهای فوری ناشی از پروتکلهای ایمنی، در این ارزیابی لحاظ نشدهاند.
شیوه دستهبندی فراخوانی ابزارها
دستهبندی | شامل |
|---|---|
مشاهده تصویر (Image Viewing) | تصاویر اصلی، نماهای برشخورده و سایر تصاویر پردازششده |
آمادهسازی تصویر (Image Preparation) | برش زدن، بزرگنمایی یا تغییر اندازه، چرخش، تنظیم کنتراست و روشنایی، نشانهگذاری و خطوط راهنما، ماسکها یا رنگهای کاذب و رندرهای اسکی (ASCII) |
اندازهگیری تصویر (Image Measurement) | شمارش اجزا، محاسبه مساحت، شدت نور باندها، مشخصات طیفی، مختصات، فواصل، روابط ساختاری و نمودارهای اندازهگیری |
توضیحات و بدون عملیات (Commentary / No-op) | کامنتها، کدهای خالی، ثبت توضیحات متنی یا استدلالهای ایستا |
سایر موارد |
|
برای هر فراخوانی، متناسب با فعالیت اصلی آن یک دستهبندی پایه تعیین شده است.
مشاهده تصاویر از طریق ابزار view_image انجام میشود و سایر گروههای فعالیتی، فراخوانیهای ابزار اجرای کد (code_exec) را پوشش میدهند. بخش سایر موارد شامل بررسی فایل و محیط، ثبت پاسخ، محاسبات، استخراج متن (OCR) و فعالیتهای نامشخص است. ابزار OCR حدود ۱۲٫۴ درصد از فراخوانیهای بخش سایر موارد را تشکیل میدهد و مدل Gemini 3.8 Flash (high) بهتنهایی عامل ۲۱ درصد از درخواستهای OCR بهشمار میرود.
هر اجرای کدی لزوماً به معنای تحلیل نیست
مدل Gemini 3.8 Flash (high) عامل ۸۶٫۷ درصد از کل فراخوانیهای دستهبندی commentary/no-op در میان تمام مدلها بوده است. این سهم نمایانگر ۵٫۶ درصد از کل ابزارهای مورد استفاده این مدل یا حدود ۳٫۸ فراخوانی از میانگین ۶۷٫۵ ابزار در هر وظیفه است.
فراخوانیهای گروه commentary/no-op مواردی همچون روایتگری ایستا، ثبت کامنت یا چاپ متن را بدون انجام پردازش جدید یا تحلیل فایل شامل میشوند. برای نمونه در بررسی نمونه پروتئینی Protein spot 22، فراخوانی این ابزار متنی صرفاً تفسیری از برچسبهای نقاط را چاپ میکند. در این رویکرد، ابزار اجرای کد مانند یک دفترچه یادداشت به کار گرفته میشود؛ مدل تفسیر خود را یادداشت میکند و همان متن در درخواست بعدی مجدداً به مدل ارسال میشود.
مدلهای هوشمندتر تمایل دارند از ابزارهای کمتری استفاده کنند
تعداد مسائل حلشده در مدلها به هم نزدیک است، اما گزینههای برتر ثبات عملکرد بسیار بیشتری دارند
پیشتازی Gemini 4 Carbon (high) در سه حوزه از هشت حوزه ارزیابی
اختلاف نزدیک به ۱۰۰ برابری در هزینه حل هر مسئله میان مدلهای گوناگون
منابع و مستندات بنچمارک VIALS-AA
مطالب مرتبط و پیشنهادی
اختیارات ویژه دولت بریتانیا برای بازرسی شرکتها هنگام سرکشی ایجنتهای هوش مصنوعی
دولت بریتانیا در حال تدوین اختیارات قانونی ویژهای برای بازرسی و تفتیش شرکتها در زمان خارجشدن ایجنتهای هوش مصنوعی از کنترل است. این طرح اپراتورهای خدمات حیاتی و سرویسهای ابری را ملزم میکند حوادث امنیتی سیستمهای خودکار را فوراً گزارش کنند و تدابیر حفاظتی سختگیرانهتری در پیش بگیرند.
توبیخ شدید وکلای تنبل توسط قاضی فدرال آمریکا؛ تنظیم لوایح دادگاه با متون بیکیفیت هوش مصنوعی
یک قاضی فدرال در ایالت تگزاس آمریکا، وکلای یک متهم را بهدلیل ثبت لوایح بیارزش و پر از متون سطحی تولیدشده با هوش مصنوعی بهشدت توبیخ کرد. او این اقدام را نشانه بارز تنبلی شغلی دانست و هشدار داد که ادامه اتلاف منابع دادگاه میتواند به محرومیت آنها از وکالت منجر شود.
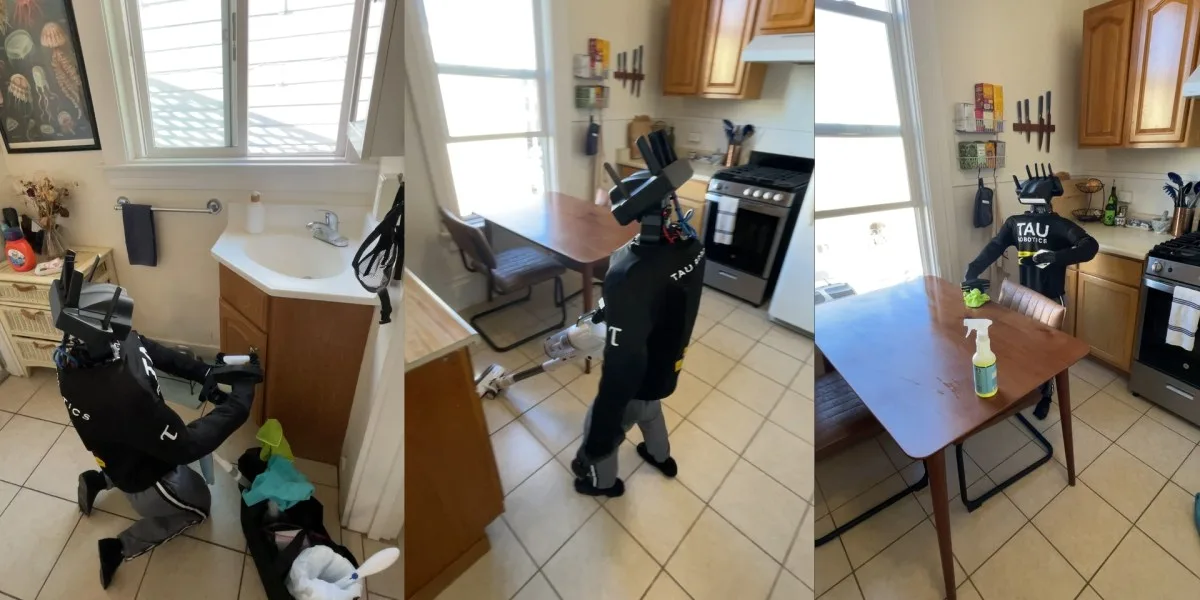
وقتی ربات انساننما خانه را تمیز میکند؛ نگاهی ملموس به آینده رباتیک خانگی
استارتاپ Tau Robotics با اعزام رباتهای انساننما برای نظافت منازل در سانفرانسیسکو، تجربه زندگی در آینده را برای کاربران تداعی میکند. این رباتها اگرچه هنوز برای انجام کارهای پیچیده به هدایت اپراتور انسانی وابستهاند، اما با هر بار تمیزکاری، دادههای ارزشمندی برای خودکارسازی کامل یاد میگیرند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.