تنسنت مدل Hy-SimulMT را معرفی کرد؛ ترجمه همزمان گفتار با شبیهسازی زنده صدا
تیم هوش مصنوعی تنسنت از مدل متنباز Hy-SimulMT رونمایی کرد که امکان ترجمه همزمان و دوطرفه میان زبانهای انگلیسی و چینی را فراهم میکند. این مدل با تأخیر ناچیز حدود ۳ ثانیه کار میکند و میتواند همزمان با ترجمه، لحن و ویژگیهای صدای گوینده اصلی را نیز شبیهسازی کند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- ترجمه همزمان در حین صحبت: مدل Hy-SimulMT بدون نیاز به پایان سخنرانی، بهصورت لحظهای صدا را پردازش کرده و ترجمه متنی و صوتی را تولید میکند.
- شبیهسازی زنده صدای گوینده: سیستم خروجی صدا را با حفظ ویژگیها و طنین صدای گوینده اصلی بازتولید میکند تا دنبال کردن گفتوگوهای چندنفره بسیار آسانتر شود.
- سرعت بالا و تأخیر ۳ ثانیهای: این مدل بر پایه معماری MoE با ۳۰ میلیارد پارامتر کل طراحی شده و در سنجشهای استاندارد سرعتی بالاتر از ابزارهای تجاری به نمایش گذاشته است.
معرفی مدل Hy-SimulMT؛ ترجمه بلادرنگ صوت به صوت
مدل Hy-SimulMT یک سیستم هوش مصنوعی پیشرفته برای ترجمه همزمان و بلادرنگ گفتار است که توسط تیم Hunyuan در شرکت تنسنت بهصورت متنباز منتشر شده است. این ابزار از ترجمه دوطرفه گفتار به گفتار میان زبانهای چینی و انگلیسی پشتیبانی میکند؛ به این معنا که همزمان با صحبت کردن گوینده، جریان صدا را بدون وقفه دریافت و ترجمه کرده و هم خروجی متنی و هم صوتی تولید مینماید. ویژگی متمایز این مدل، بهرهگیری از فناوری شبیهسازی زنده صدا است که مشخصات آوایی و طنین صدای گوینده را در زبان مقصد حفظ میکند.
مدل اصلی این پروژه با عنوان Hy-SimulMT-30B-A3B شناخته میشود که بر پایه معماری ترکیبی از متخصصان (MoE) با حدود ۳۰ میلیارد پارامتر کل و ۳ میلیارد پارامتر فعال در هر توکن توسعه یافته است. این مدل تحت پروانه آپاچی ۲ (Apache-2.0) روی پلتفرمهای Hugging Face و ModelScope در دسترس همگان قرار دارد. مخزن گیتهاب رسمی پروژه به نشانی Tencent-Hunyuan/Hy-SimulMT شامل سرویس استنتاج SimulInfer و ابزارهای بهینهسازی SimulTrain است و امکان آزمایش عملکرد آن در اپلیکیشن Hy Translate نیز مهیا شده است.
دستیابی به تأخیر زمانی حدود ۳ ثانیه همزمان با بازتولید صدای گوینده در قالب یک ابزار متنباز، گامی رو به جلو در کاربردیسازی مدلهای ترجمه زنده به شمار میرود.
ویژگیها و قابلیتهای محوری
- ترجمه همزمان با گوش دادن: این ابزار بهطور اختصاصی برای جلسات کاری، سخنرانیهای زنده و مصاحبهها بهینهسازی شده و تعادلی هوشمند میان انتظار برای درک سیاق کلام و شروع زودهنگام سخن برقرار میکند.
- تأخیر بسیار اندک: در ارزیابی جامع با شاخص RealSI برای ورودیهای صوتی بلند، میزان تأخیر جریان (StreamLAAL) این مدل به حدود ۳ ثانیه رسیده که کمترین رقم در میان سیستمهای مقایسهشده است (این شاخص با زمان تولید اولین واژه تفاوت ساختاری دارد).
- کیفیت خروجی بالا: در ارزیابی بر پایه شاخص استاندارد GEMBA، عملکرد مدل از تمام رقبای متنباز و همچنین چهار سرویس تجاری نامآشنا بالاتر ثبت شده است.
- شبیهسازی مشخصات صدا: گفتار خروجی در زبان مقصد، ویژگیهای منحصربهفرد صدای هر گوینده را بازآفرینی میکند؛ امری که دنبال کردن دیالوگهای چندنفره را به مراتب سادهتر میسازد (خروجی صوتی نیازمند فعالسازی سرویس تبدیل متن به گفتار است).
نتایج بنچمارکهای ارزیابی گفتار کوتاه
مدل / رابط کاربری تجاری | FLEURS | CoVoST2 | ACL6060 | RealSI-Sentence |
|---|---|---|---|---|
Hy-SimulMT | ۹۰٫۳ | ۷۵٫۵ | ۸۱٫۲ | ۸۴٫۷ |
Qwen3.8-LiveTranslate | ۸۸٫۴ | ۸۲٫۱ | ۸۰٫۵ | ۸۴٫۴ |
Gemini3.5-LiveTranslate | ۹۲٫۴ | ۷۴٫۴ | ۸۲٫۶ | ۸۲٫۲ |
Seed-LiveInterpret2.0 | ۸۵٫۸ | ۶۷٫۷ | ۷۴٫۸ | ۸۰٫۰ |
GPT-Realtime-Translate | ۷۷٫۷ | ۵۰٫۸ | ۷۶٫۴ | ۷۶٫۷ |
تیم پژوهشگران همچنین یک بررسی تجربی با ۱۸ فایل صوتی جدید به زبانهای چینی و انگلیسی (هرکدام حدود ۶ دقیقه در ۱۰ حوزه موضوعی مختلف) ترتیب داده و عملکرد مدل را در برابر ۶ مترجم همزمان انسانی دارای مدرک سطح ۱ یا ۲ آزمون تخصصی CATTI سنجیدهاند. نتایج این آزمون کیفیتی همپای مترجمان حرفهای و در بسیاری از سناریوها تأخیری کمتر را نشان میدهد؛ اگرچه پژوهشگران خاطرنشان کردهاند که این نتایج محدود به همین نمونه آزمایشی است.
نسخههای مختلف مدل
نسخه مدل | ویژگیها و کاربرد |
|---|---|
Hy-SimulMT-30B-A3B | ارائه خروجی ترجمه بهتنهایی |
Hy-SimulMT-30B-A3B-Interleave | تولید متن زبان مبدأ بههمراه متن ترجمهشده |
نسخههای FP8 و GGUF از هر دو مدل | نسخههای کوانتایز شده برای کاهش مصرف حافظه و ارتقای سرعت اجرا |
راهنمای راهاندازی و اجرا با فریمورک vLLM
برای پیادهسازی این سیستم به سیستمعامل لینوکس، نسخه پایتون ۳٫۱۲ به بالا، Git و یک کارت گرافیک NVIDIA با حافظه ویدیویی مناسب نیاز است. پیشنیازهای نرمافزاری شامل کتابخانه vLLM نسخه ۰٫۳۱ به بالا با پشتیبانی از HYV3ForCausalLM بههمراه ماژول simulst است.
git clone https://github.com/Tencent-Hunyuan/Hy-SimulMT.git Hy-SimulMT
cd Hy-SimulMT/SimulInfer
bash deploy.sh --install-server --model tencent/Hy-SimulMT-30B-A3B-Interleave
پس از دریافت پیام Ready: http://127.0.0.1:8080/، پیوند وب را باز کرده، جهت ترجمه را انتخاب و فایل صوتی را بارگذاری یا ورودی میکروفون را فعال کنید (اتصال میکروفون از راه دور نیازمند پروتکل HTTPS است). برای ارسال مستقیم استریم صوتی از خط فرمان نیز میتوان از دستور زیر استفاده کرد:
curl -N http://127.0.0.1:8080/translate/stream \\
-F direction=en-zh -F file=@audio.wav- اتصال به سرور واسط موجود:
bash deploy.sh --backend-url http://model-host:8800/v1 - پیکربندی چند پردازنده گرافیکی: با تعیین آرگومانهای
--gpus 0,1 --tensor-parallel-size 2 - استفاده از llama.cpp: پشتیبانی کامل از فرمت GGUF هنوز وارد شاخه اصلی نشده است و پیشنهاد میشود تا بهروزرسانیهای آتی منتظر بمانید.
- آموزش تکمیلی مدل: از طریق ماژول SimulTrain موجود در مخزن امکانپذیر است.
جامعه هدف و کاربردها
- نشستهای زنده، پخش مستقیم اینترنتی و مصاحبههایی که به ترجمه فوری میان چینی و انگلیسی نیاز دارند.
- شرکتها و تیمهای توسعه که مایل به راهاندازی پایدار و بومی سامانه ترجمه همزمان بر بستر پردازندههای گرافیکی اختصاصی خود هستند.
تیم توسعهدهنده یادآور شده است که در موقعیتهای حقوقی حساس و مذاکرات کلیدی که نیازمند دقت قطعی و پاسخگویی مستقیم هستند، بهرهگیری از مترجمان حرفهای انسانی همچنان ضروری است. ایمیل ارتباطی تیم: hunyuan_opensource@tencent.com
مطالب مرتبط و پیشنهادی
هشدار جیم کریمر؛ موج سنگین عرضه اولیه شرکتهای هوش مصنوعی رونق بازار سهام را تهدید میکند
جیم کریمر هشدار میدهد که هجوم عرضههای اولیه غولآسا و جذب سرمایههای سنگین از سوی شرکتهایی مانند Anthropic میتواند نقدینگی بازار سهام را ببلعد. به باور این تحلیلگر، عطش بیپایان شرکتهای هوش مصنوعی برای تأمین مالی ممکن است با کمبود تقاضای سرمایهگذاران روبرو شود و رونق فعلی والاستریت را به خطر بیندازد.
احضار مدیران ارشد Anthropic به کمیسیون تجارت فدرال آمریکا؛ تحقیقات ایمنی هوش مصنوعی شدت گرفت
کمیسیون تجارت فدرال آمریکا (FTC) در ادامه تحقیقات خود درباره آسیبهای احتمالی هوش مصنوعی برای کاربران، مدیران ارشد Anthropic را برای ادای شهادت احضار کرد. این اقدام همزمان با آمادهسازی این استارتاپ برای یکی از بزرگترین عرضههای اولیه سهام در بورس صورت میگیرد و میتواند هزینههای سنگینی بههمراه داشته باشد.
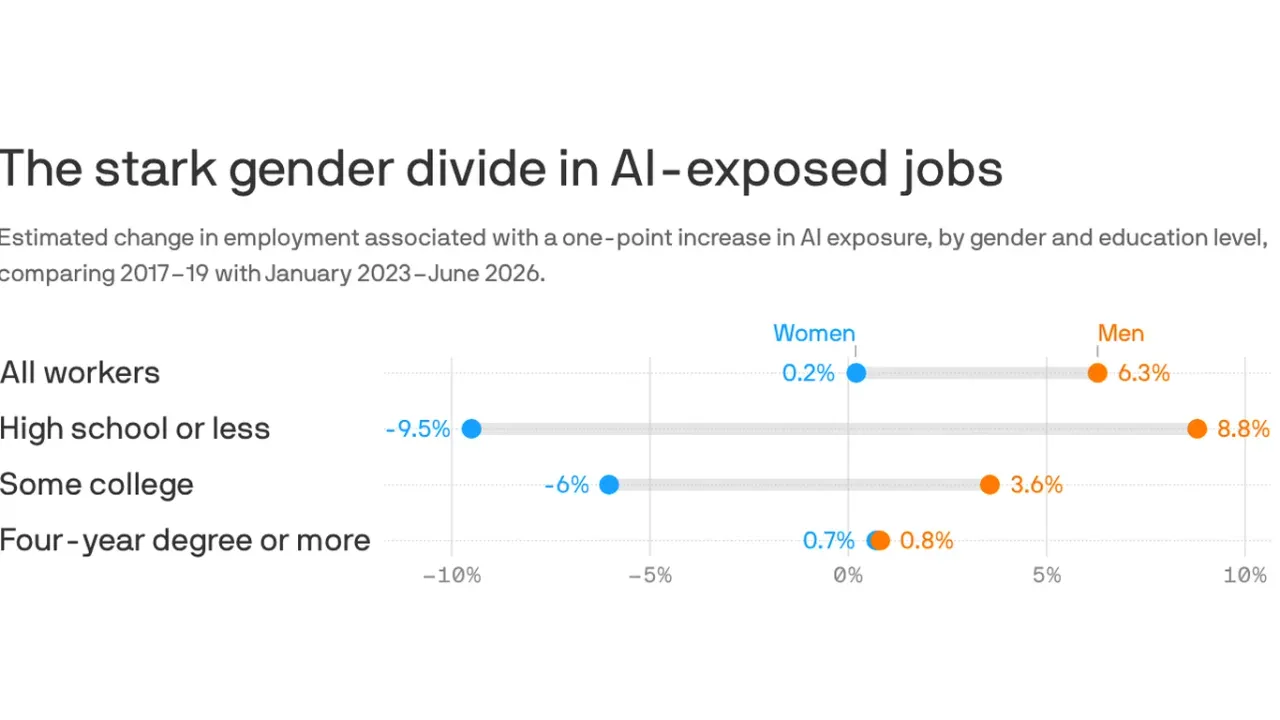
گزارش تازه مرکز Pew: هوش مصنوعی امنیت شغلی زنان را بیشتر از مردان تهدید میکند
یافتههای پژوهش جدید نشان میدهد که گسترش هوش مصنوعی میتواند بازار کار زنان را دچار ناامنی اقتصادی بیشتری نسبت به مردان کند. این شکاف بهویژه میان نیروهای کاری که مدرک دانشگاهی چهارساله ندارند چشمگیرتر است و تفاوت در ماهیت مشاغل، زنان را بیشتر در معرض آسیبهای ناشی از اتوماسیون قرار میدهد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.