رونمایی استارتاپ کرهای آپاستیج از مدل Solar Mini 4؛ سریع در خروجی، اما ۵ برابر گرانتر در دنیای واقعی!
استارتاپ هوش مصنوعی کرهای آپاستیج (Upstage) از مدل استدلالی جدید Solar Mini 4 با ۳ میلیارد پارامتر فعال رونمایی کرد که در بنچمارکهای هوش عملکردی فراتر از ابعاد کوچکش به نمایش گذاشته است. با این حال، مصرف سرسامآور توکنهای استدلالی و بازدهی ضعیف سیستم کش باعث شده اجرای هر تسک با این مدل تا ۵ برابر گرانتر از رقبایی مثل GPT-6 Luna تمام شود.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- استارتاپ کرهای Upstage مدل استدلالی اختصاصی جدید خود به نام Solar Mini 4 را با ۳ میلیارد پارامتر فعال معرفی کرد که رکورد پرچمدار نسل قبلی این شرکت را با جهشی چشمگیر شکسته است.
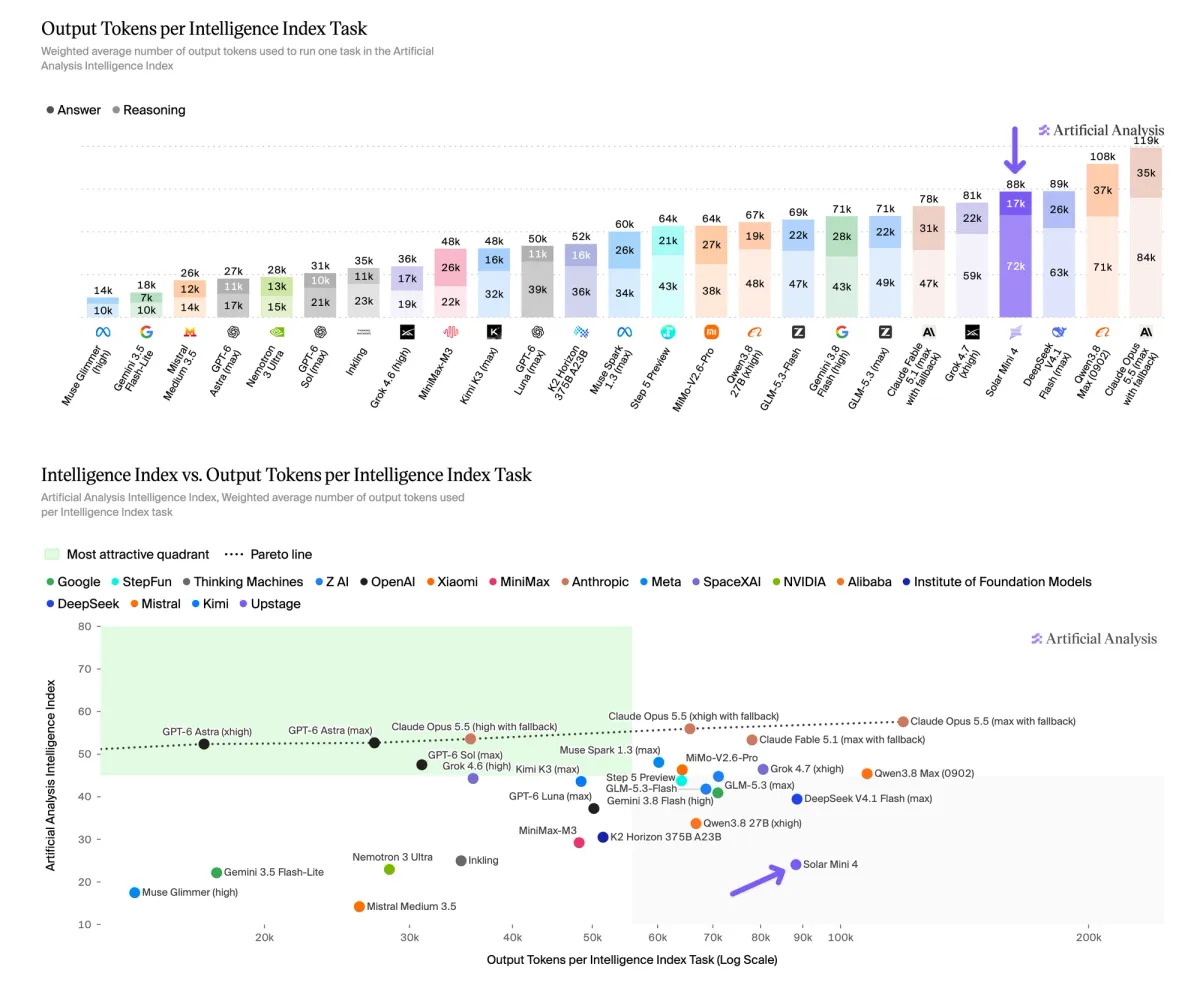
- این مدل در تولید توکن بسیار پرسرعت است (۲۰۸ توکن بر ثانیه)، اما به دلیل مصرف بیش از ۸۸ هزار توکن استدلالی برای هر تسک، حل هر مسئله به طور میانگین بیش از ۷ دقیقه معطلی دارد.
- با وجود قیمت اسمی پایین توکنها، بازدهی ضعیف در کش کردن اطلاعات (فقط ۴۸ درصد) باعث شده هزینه واقعی هر تسک با این مدل حدود ۵ برابر گرانتر از رقیبی مثل GPT-6 Luna تمام شود.
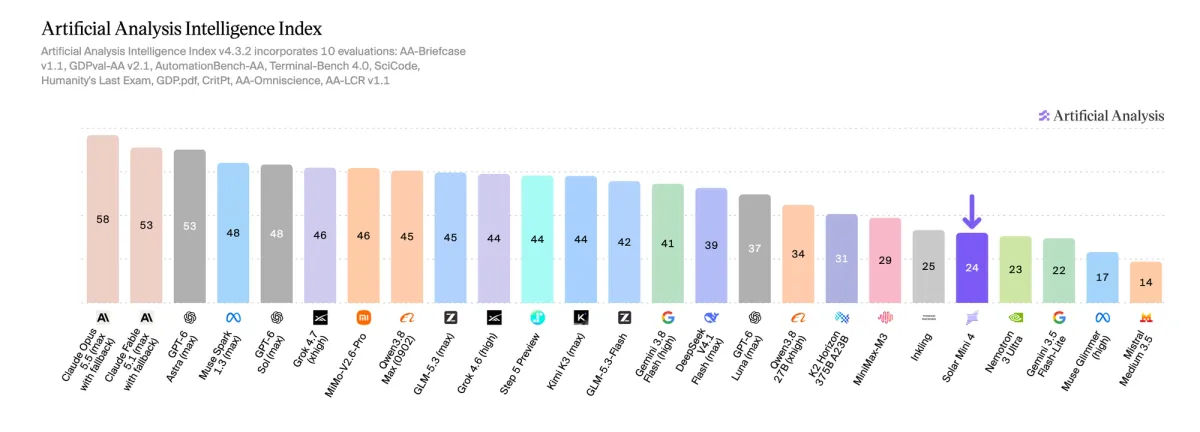
آزمایشگاه هوش مصنوعی کرهای 🇰🇷 استارتاپ Upstage از مدل استدلالی Solar Mini 4 رونمایی کرد؛ مدلی که در شاخص جامع هوش امتیاز ۲۴ را ثبت کرده، اما با وجود قیمت ظاهراً مشابه توکنها، هزینه نهایی انجام هر تسک با آن حدود ۵ برابر بیشتر از GPT-6 Luna تمام میشود!
استارتاپ کرهای آپاستیج (Upstage) مدل استدلالی اختصاصی جدیدی به نام Solar Mini 4 را عرضه کرده است. طبق اعلام این استارتاپ، مدل مذکور از ۳۵ میلیارد پارامتر کل و ۳ میلیارد پارامتر فعال بهره میبرد و توانسته نقطه بهینه جدیدی (Pareto optimal) را میان «شاخص هوش» و «پارامترهای فعال» برای مدلهای زیر ۳ میلیارد پارامتر به ثبت برساند. این مدل همچنین نسبت به پرچمدار نسل قبلی همین شرکت یعنی Solar Pro 3 (با امتیاز ۸)، ۱۶ امتیاز بالاتر ایستاده و قیمت هر یک میلیون توکن ورودی و خروجی را هم با کاهشی یکسومی، به ترتیب به ۰.۱۰ و ۰.۴۰ دلار رسانده است.
مهمترین نتایج و ارزیابیهای کلیدی:
➤ عملکرد فوقالعاده نسبت به جثه و پارامترهای فعال: مدل Solar Mini 4 موفق شده ۶ امتیاز بالاتر از مدل استدلالی Qwen3.6 35B A3B (که آن هم ۳ میلیارد پارامتر فعال دارد) و حتی ۱ امتیاز بالاتر از غول Nemotron 3 Ultra با ۵۵ میلیارد پارامتر فعال ثبت کند! البته از آنجا که این مدل اختصاصی و متنبسته است، امکان راستیآزمایی مستقل ابعاد واقعی آن وجود ندارد.
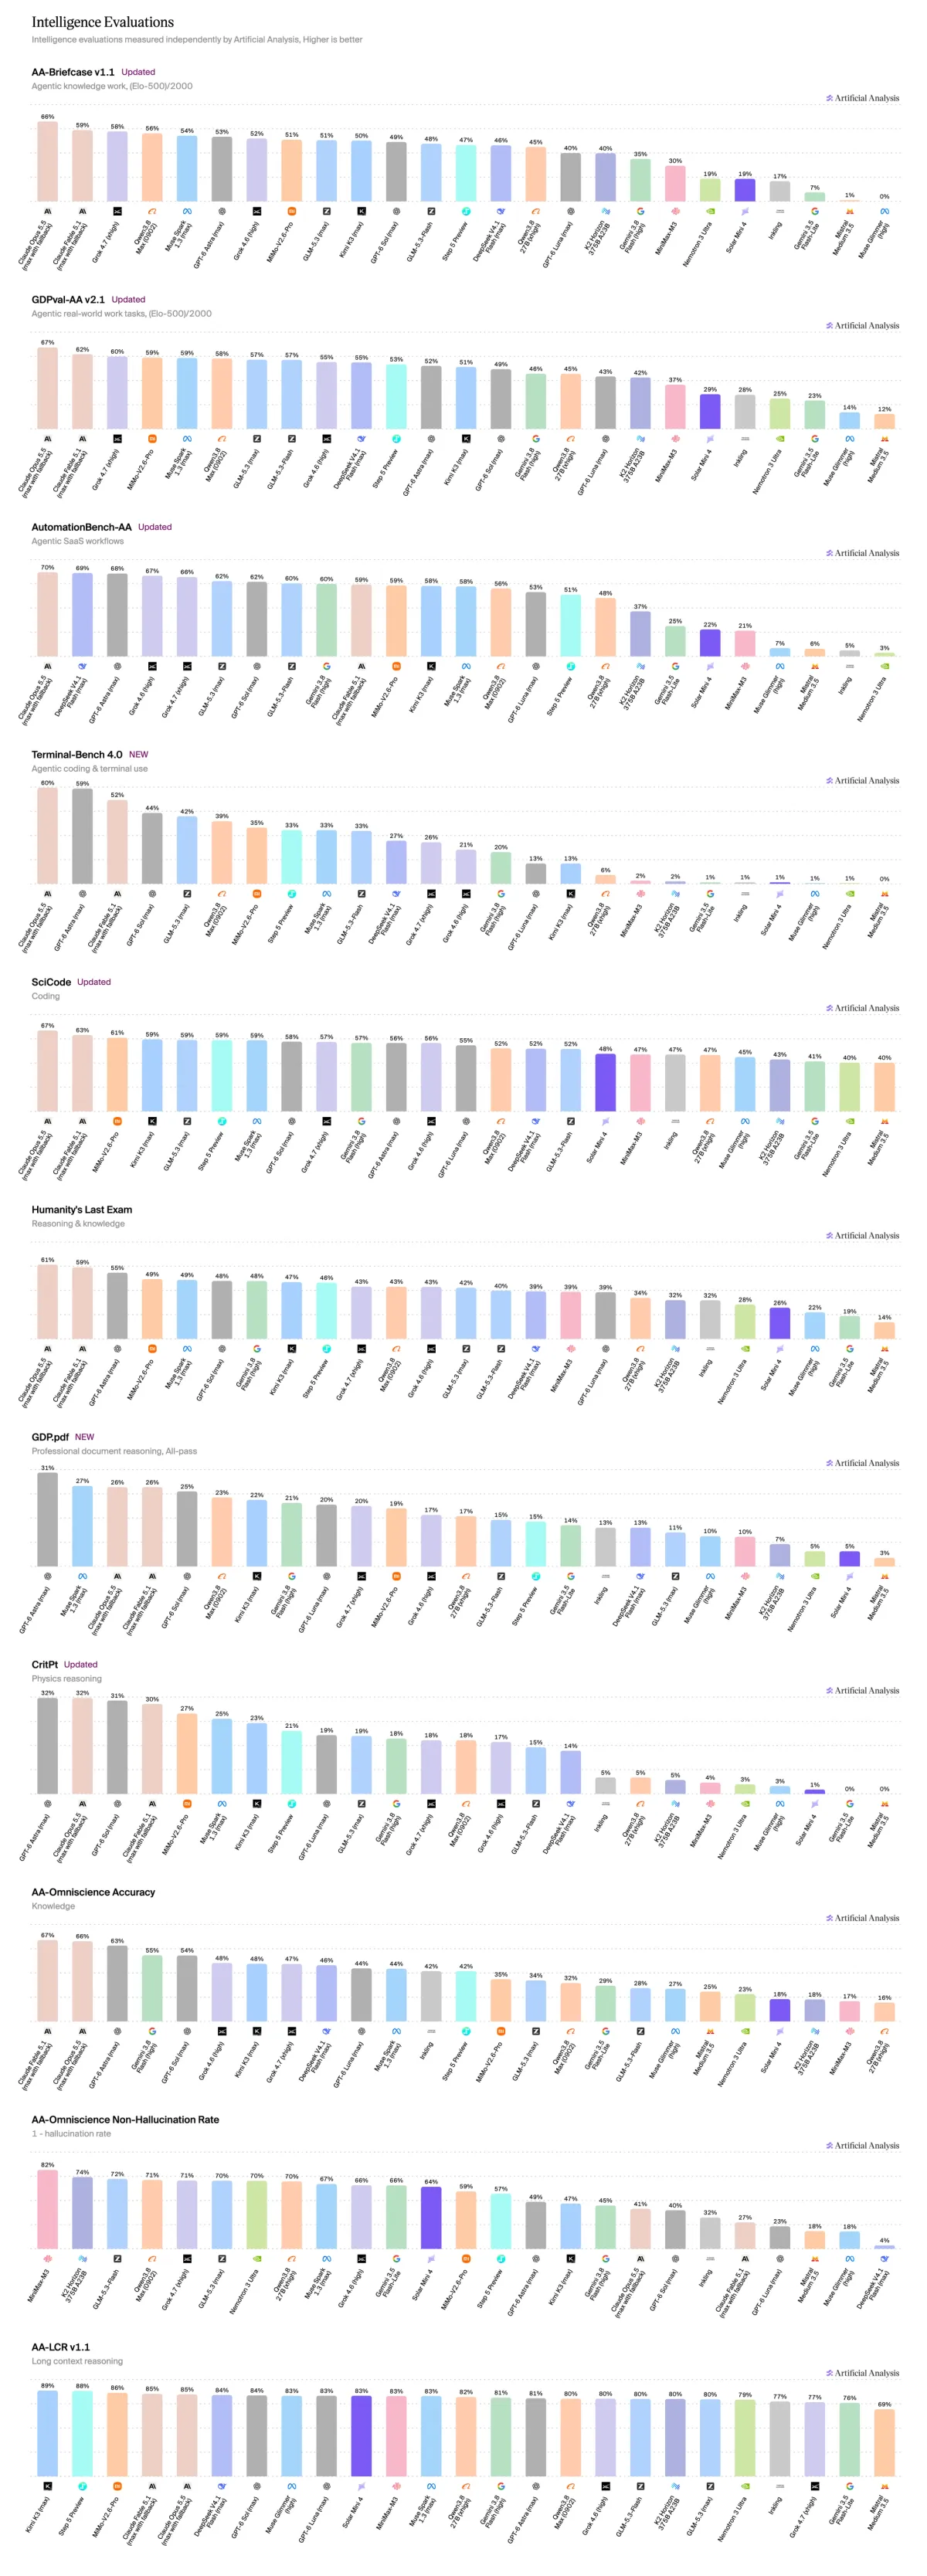
➤ استدلال در بافتهای طولانی، برگ برنده این مدل: مدل جدید آپاستیج در بنچمارک استدلال در بافت طولانی (LCR v1.1) به امتیاز عالی ۸۳ درصد رسیده و با غولهایی مثل MiniMax-M3 و GPT-6 Luna برابری میکند؛ عملکردی که حتی بالاتر از مدلهای نامآشنایی نظیر Gemini 3.8 Flash و GPT-6 Astra با امتیاز ۸۱ درصد قرار میگیرد. علاوه بر این، در بنچمارک برنامهنویسی علمی SciCode نیز امتیاز ۴۸ درصد را ثبت کرده و از MiniMax-M3 و Inkling (با امتیاز ۴۷ درصد) جلو افتاده است.
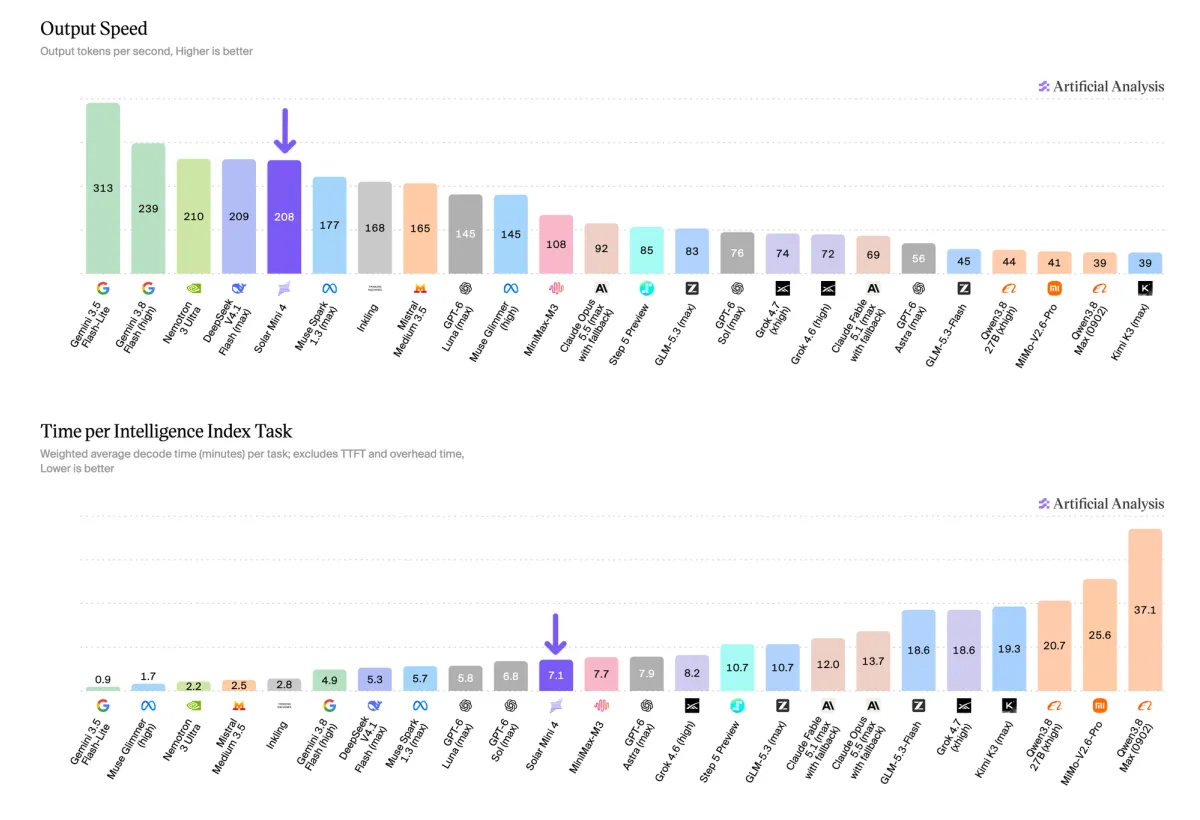
➤ خروجی برقآسا اما معطلی در اجرای کارها: مدل Solar Mini 4 با سرعت خیرهکننده ۲۰۸ توکن در ثانیه خروجی تولید میکند که حسابی از GPT-6 Luna با سرعت ۱۵۲ توکن بر ثانیه سریعتر است. اما داستان به این سادگی نیست؛ این مدل برای حل هر تسک در شاخص هوش، حدود ۸۸ هزار توکن خروجی تولید میکند و همین زیادهگویی باعث شده اجرای هر تسک به طور میانگین ۷.۱ دقیقه طول بکشد و کاربر را معطل کند!
➤ نقطه ضعف نسبی در کدنویسی ایجنتی: مدل جدید در کارهای ایجنتی و برنامهنویسی عملکرد چندان درخشانی ندارد؛ به طوری که در بنچمارک Terminal-Bench 4.0 امتیاز ناامیدکننده ۱ درصد و در بنچمارک اتوماسیون (AutomationBench) امتیاز ۲۲ درصد را کسب کرده است. البته در کارهای دانشی مبتنی بر ایجنتها، وضعیت بهتر است و با کسب امتیاز ۱۰۷۲ Elo در بنچمارک GDPval و ۸۷۲ Elo در Briefcase، عملکردی نزدیک به مدل Inkling نشان میدهد.
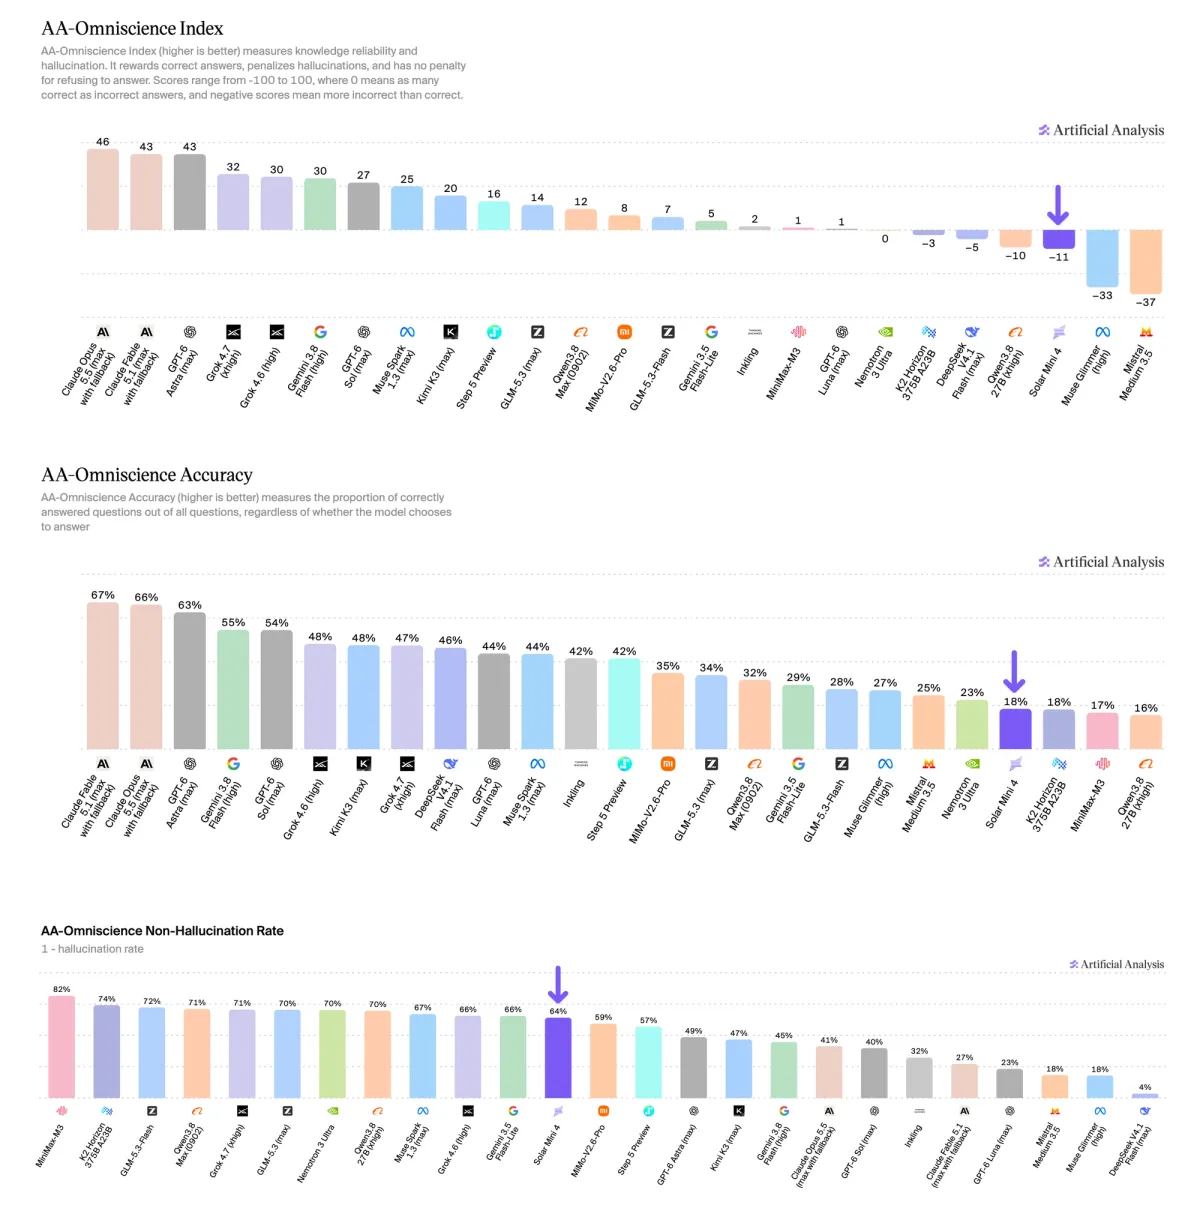
➤ دقت پایین در دانش عمومی، اما توهم اندک: مدل Solar Mini 4 در بنچمارک ارزیابی دانش و توهم (Omniscience) امتیاز ۱۱- و دقت ۱۸ درصدی به دست آورده است. نکته جالب اینجاست که مدل به جای زدن حرفهای نامربوط، ترجیح میدهد به نیمی از سؤالات پاسخ ندهد! به همین دلیل نرخ عدم توهم آن به ۶۴ درصد رسیده که بسیار بهتر از Inkling با ۳۲ درصد و GPT-6 Luna با ۲۳ درصد است.
سایر مشخصات فنی مدل:
➤ پنجره زمینه (Context Window): یک میلیون توکن
➤ حداکثر توکنهای خروجی: ۲۶۲ هزار توکن
➤ لایسنس و دسترسی: اختصاصی و تجاری (وزنهای مدل منتشر نشده است)
➤ تعداد پارامترها: ۳۵ میلیارد پارامتر کل و ۳ میلیارد پارامتر فعال (طبق گزارش رسمی Upstage)
➤ مودالیتیها: فقط ورودی و خروجی متنی
➤ تاریخ انقضای دانش (Knowledge Cutoff): فوریه ۲۰۲۶
➤ قیمتگذاری: ۰.۱۰ دلار به ازای هر ۱ میلیون توکن ورودی، ۰.۴۰ دلار به ازای خروجی و ۰.۰۱ دلار برای هر بار فراخوانی کش (Cache Hit)
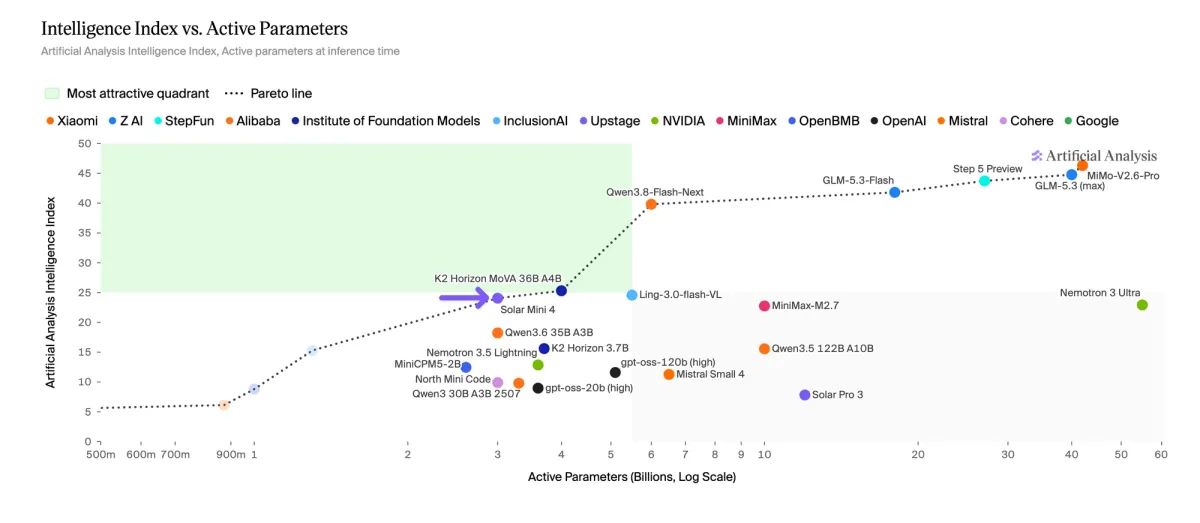
استارتاپ Upstage گزارش داده که Solar Mini 4 دارای ۳۵ میلیارد پارامتر در مجموع و ۳ میلیارد پارامتر فعال است و در این ابعاد، رکورد بهینه پارتو (Pareto) را در مقایسه شاخص هوش در برابر پارامترهای فعال شکسته است. از آنجا که این مدل اختصاصی است، وزنهای آن به صورت عمومی در دسترس نیست. برای مقایسه، مدل Qwen3.6 35B A3B با همین ۳ میلیارد پارامتر فعال امتیاز ۱۸ را کسب کرده، در حالی که K2 Horizon MoVA 36B A4B با ۴ میلیارد پارامتر فعال به امتیاز ۲۵ رسیده است. جالب اینکه پرچمدار نسل پیشین آپاستیج یعنی Solar Pro 3 با وجود ۱۲ میلیارد پارامتر فعال، تنها امتیاز ۸ را گرفته بود.
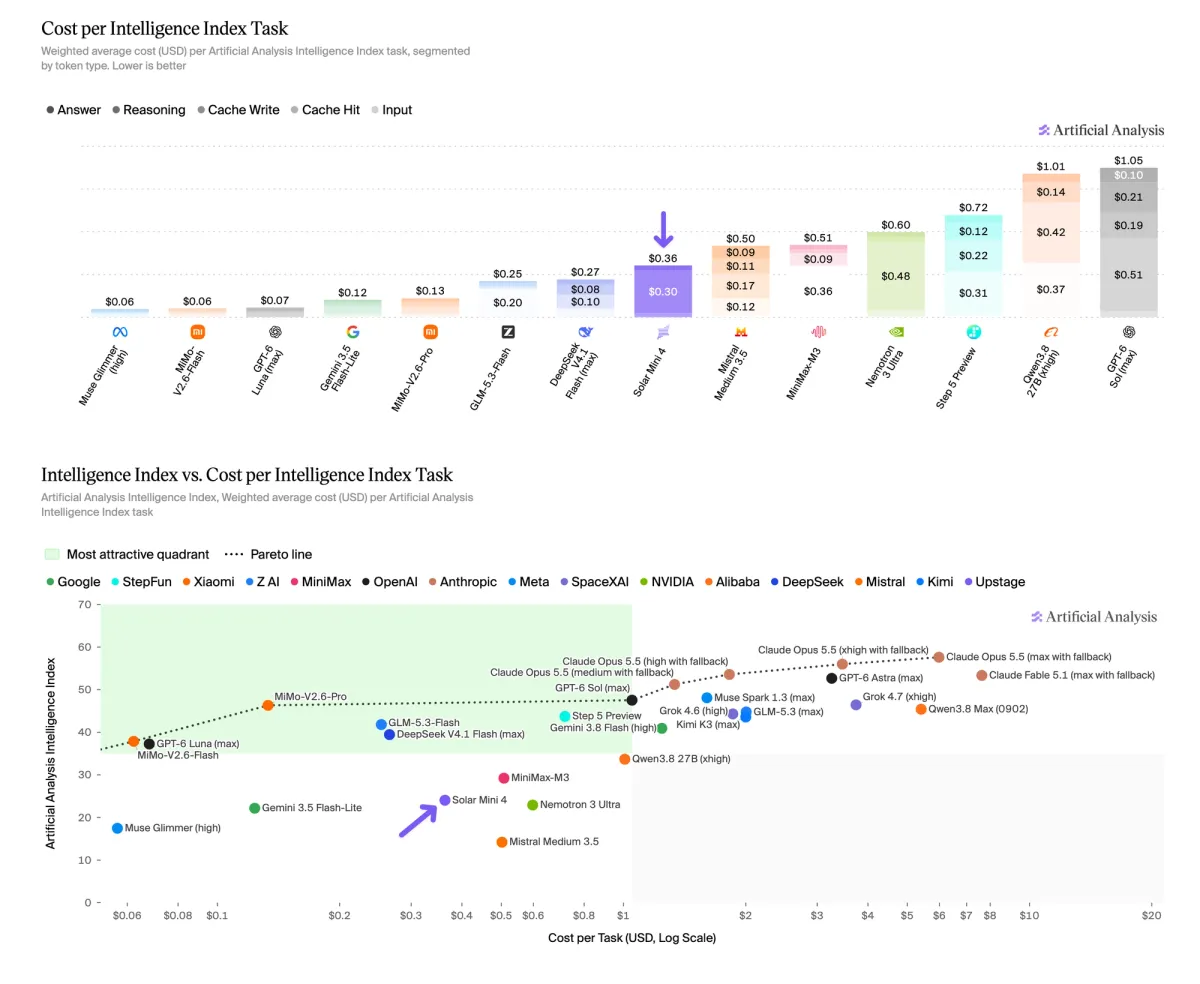
توکنهای ورودی بدون کش، حدود ۰.۳۰ دلار از هزینه کل ۰.۳۶ دلاری Solar Mini 4 برای هر تسک در شاخص هوش را تشکیل میدهند. در تسکهای مبتنی بر ایجنت (مانند Terminal-Bench 4.0 و Briefcase) گفتوگو مدام در هر مرحله طولانیتر و دوباره ارسال میشود؛ بنابراین بهرهوری کش نقشی حیاتی دارد. طبق بررسیها و اندازهگیریهای انجامشده، تنها ۴۸ درصد از محتوای تکراری Solar Mini 4 از طریق حافظه کش پردازش شده است؛ این در حالی است که این رقم برای رقیبی مانند GPT-6 Luna به ۹۹ درصد میرسد و همین موضوع هزینه هر تسک آن مدل را به ۰.۰۷ دلار کاهش داده است. توکنهای استدلال و پاسخ نیز در مجموع تنها حدود ۰.۰۴ دلار به هزینه هر تسک اضافه میکنند.
مدل Solar Mini 4 برای انجام هر تسک در شاخص هوش، حدود ۸۸ هزار توکن خروجی مصرف میکند که حتی از ۷۸ هزار توکن مدل Claude Fable 5.1 هم بیشتر است. جالب اینجاست که ۷۲ هزار مورد از این توکنها، صرفاً توکنهای زنجیره استدلال (Reasoning Tokens) هستند. مصرف توکن خروجی این مدل تقریباً ۲.۵ برابر مدل Inkling و ۵ برابر مدل Gemini 3.5 Flash-Lite (با امتیازهای به ترتیب ۲۵ و ۲۲) است. هرچند با قیمت ۰.۴۰ دلار به ازای هر میلیون توکن خروجی، این حجم توکن تأثیر مالی وحشتناکی روی قیمت ندارد، اما زمان پردازش کارها را به شدت طولانی و خستهکننده میکند.
مدل Solar Mini 4 با سرعت ۲۰۸ توکن در ثانیه خروجی تولید میکند، اما به دلیل حجم عظیم توکنهای تولیدی، زمان تکمیل کارها در مقایسه با GPT-6 Luna بسیار کندتر است. میانگین زمان رمزگشایی و پردازش برای هر تسک در شاخص هوش با این مدل ۷.۱ دقیقه است؛ در حالی که مدل GPT-6 Luna با سرعت ۱۵۲ توکن در ثانیه کار را ظرف ۵.۸ دقیقه و مدل Inkling با سرعت ۱۸۳ توکن در ثانیه ظرف ۲.۸ دقیقه تمام میکنند.
امتیاز ۱۱- مدل Solar Mini 4 در بنچمارک Omniscience، بیش از آنکه نشاندهنده توهم بالا باشد، بیانگر دقت پایین در ذخیره دانش است. این مدل تنها به ۱۸ درصد از سؤالات پاسخ درست داده که در میان مدلهای مقایسهشده جزو ضعیفترینهاست، و در حدود نیمی از سؤالات هم ترجیح داده به جای پاسخ اشتباه سکوت کند! با این حال، نرخ عدم توهم ۶۴ درصدی آن به طور چشمگیری از Inkling (با ۳۲ درصد) و GPT-6 Luna (با ۲۳ درصد) بالاتر و مطمئنتر است.
نتایج کامل مدل Solar Mini 4 در شاخص جامع ارزیابی هوش
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
خط قرمز کالیفرنیا برای کارفرماها: اخراج کارمندان با هوش مصنوعی رسماً ممنوع شد!
ایالت کالیفرنیا با تصویب یک بسته قانونی تازه، دست کارفرماها را در استفاده بیرویه از هوش مصنوعی بست و اخراج کارکنان صرفاً بر اساس تصمیم الگوریتمها را ممنوع اعلام کرد. این قانون علاوه بر الزام به شفافیت در تعدیلهای نیرو، استفاده از هوش مصنوعی برای نظارت تصویری در سرویسهای بهداشتی محل کار را هم قدغن کرده است. فرماندار کالیفرنیا با دفاع از نیروی کار، ادعای امکان خودتنظیمگری شرکتهای هوش مصنوعی را بیاساس خواند.
طوفان هوش مصنوعی در بازار حافظه؛ رکورد تاریخی درآمد ۵۴ میلیارد دلاری میکرون در یک فصل!
عطش سیریناپذیر غولهای فناوری برای توسعه هوش مصنوعی، درآمد فصلی شرکت میکرون را با جهشی باورنکردنی به بیش از ۵۴ میلیارد دلار رساند تا والاستریت شگفتزده شود. این غول تراشهسازی با ثبت درآمد سالانه ۱۳۳ میلیارد دلاری رکورد تاریخ خود را شکست و حالا با تقاضای انفجاری برای حافظههای پیشرفته، چشم به آیندهای درخشانتر دوخته است.
خداحافظی گوگل با Opal؛ جمزها به «اسکیلهای جمینای» برای تمام کاربران تبدیل میشوند!
گوگل در اقدامی تازه برای یکپارچهسازی ابزارهای هوش مصنوعی، سرویس Opal را بازنشسته کرده و دستیارهای اختصاصی جمز را به «اسکیلهای جمینای» تبدیل میکند. این قابلیت که پیش از این در انحصار کاربران اشتراکی بود، حالا با پیروی از استاندارد مشترک ایجنتها و به کمک دستورهای ساده اسلش، به رایگان در دسترس همه کاربران قرار میگیرد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.