رکوردشکنی vLLM روی معماری جدید انویدیا: اجرای مدل MiniMax تا ۸ برابر سریعتر با تراشههای Vera Rubin!
فریمورک محبوب vLLM با انتشار بیلدهای آزمایشی، پشتیبانی از نسل آینده تراشههای انویدیا با معماری Vera Rubin را آغاز کرده و در بنچمارکهای اولیه، به سرعت اعجابانگیز نزدیک به ۸ برابری در اجرای مدلهای زبانی بزرگ دست یافته است. این جهش عظیم به لطف پهنای باند خیرهکننده حافظههای HBM4 و بهینهسازیهای عمیق هستههای پردازشی رقم خورده که مسیر جدیدی را برای استنتاج ارزانتر و سریعتر هوش مصنوعی هموار میکند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- فریمورک محبوب vLLM از همین حالا پشتیبانی آزمایشی از غول جدید انویدیا یعنی Vera Rubin NVL72 را کلید زده و موفق شده در اجرای مدل MiniMax M3 به جهش خروجی خارقالعاده ۷.۸۴ برابری به ازای هر پردازنده گرافیکی دست پیدا کند.
- راز این جهش چشمگیر در پهنای باند سرسامآور حافظههای نسل جدید HBM4 و قابلیتهای نوین کوودا ۱۳.۴ نهفته است که وزنهای مدلهای ترکیبی از متخصصان (MoE) را درست در مجاورت هستههای پردازشی قرار میدهد.
- البته این نتایج فعلاً روی نسخههای اولیه و آزمایشی به دست آمده و برای اینکه ببینیم این اعداد و ارقام در دنیای واقعی و پروژههای عملیاتی چقدر هزینهها را کاهش میدهند، باید منتظر تستهای مستقل بعدی بمانیم.
فریمورک محبوب و متنباز vLLM در تازهترین کانتینرهای آزمایشی (Nightly) خود که بر پایه CUDA 13.4 و PyTorch 2.15 توسعه یافتهاند، پشتیبانی پیشنمایش از پلتفرم نسل جدید Vera Rubin NVL72 انویدیا را اضافه کرده است. این پروژه با همکاری مستقیم تیمهای Inferact، انویدیا و رد هت (Red Hat) موفق شده مدلهای مطرحی چون دیپسیک (DeepSeek)، کیمی (Kimi)، جیالام (GLM) و مینیمکس (MiniMax) را روی سختافزار پیشرفته روبین اجرا کند. در این میان، کتابخانه FlashInfer نسخه 0.7.0 نیز هستههای محاسباتی بهینهشده برای روبین از جمله مکانیزم توجه (Attention)، ضرب ماتریسی GEMM و شبکههای ترکیبی از متخصصان (MoE) را در اختیار این فریمورک قرار میدهد.
نتایج اولیه منتشرشده در پیشنمایش رسمی vLLM نشان میدهد که توان خروجی و پردازش دادهها در مقایسه با سیستمهای پیشین GB200 و GB300 انویدیا جهش چشمگیری داشته است. این مقایسهها روی دو بار کاری (Workload) کاملاً متفاوت سنجیده شده و البته باید در نظر داشت که این آمارها در حال حاضر معیارهای پیشنمایش هستند و هنوز به عنوان بنچمارکهای نهایی و مستقل در محیطهای عملیاتی تأیید نشدهاند.
دو بار کاری متفاوت با جهشهای اولیه چشمگیر
در نتایج بنچمارک AgentX از مدل MiniMax M3 برای سنجش استنتاج ایجنتی استفاده شده است؛ شرایطی که در آن کانتکستهای طولانی و فراخوانیهای مکرر مدل، فشار بسیار سنگینی به پهنای باند حافظه و اجرای معماری MoE وارد میکند. در طرف مقابل، تستهای بنچمارک استنتاج MLPerf v6.1 با مدل چندحالته قدرتمند Qwen3-VL-235B-A22B انجام شده که در آن سیستم NVIDIA Dynamo درخواستها را میان ورکرهای vLLM توزیع و هدایت میکند.
بنچمارک | مدل و پشته نرمافزاری | سیستم پایه (بیسلاین) | شرایط آزمون | بهبود ثبتشده |
|---|---|---|---|---|
مدل MiniMax M3 روی vLLM | انویدیا GB200 | پاسخدهی تعاملی یکسان (Matched Interactivity) | تا ۷.۸۴ برابر توان خروجی بیشتر به ازای هر پردازنده | |
AgentX | مدل MiniMax M3 روی vLLM | انویدیا GB200 | تولید ۱۵۰ توکن بر ثانیه | ۵.۱۸ برابر توان خروجی بیشتر |
MLPerf Inference v6.1 VLM | مدل Qwen3-VL-235B-A22B با ترکیب vLLM و Dynamo | انویدیا GB300 NVL72 | سناریوهای آفلاین، سرور و تعاملی | تا ۳.۷ برابر توان خروجی بیشتر |
این اعداد و ارقام نشاندهنده پیکربندیهای مجزای بنچمارک هستند و باید دقیقاً متناسب با بارهای کاری اختصاصی خودشان بررسی شوند. معیار «پاسخدهی تعاملی یکسان» سرعت پاسخگویی به کاربر را در یک حد ثابت نگه میدارد و اندازه میگیرد که هر سیستم در مجموع چه حجم ترافیکی را میتواند پردازش و پاسخدهی کند.
پهنای باند فراتر از تصور برای فاز رمزگشایی (Decode)
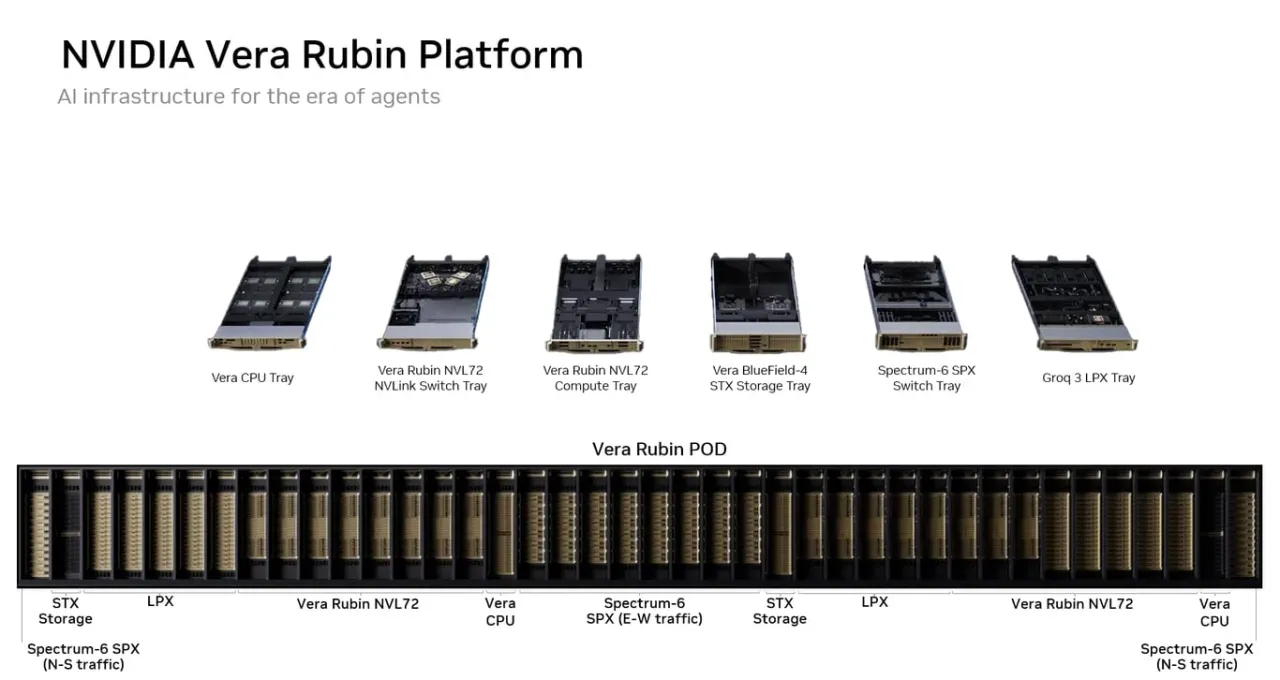
سیستم رکاسکیل Vera Rubin NVL72 تعداد ۷۲ پردازنده گرافیکی روبین را در یک شبکه یکپارچه به هم متصل میکند. معماری روبین بخش اعظم سازگاری نرمافزاری خود را با مدل برنامهنویسی بلکول (Blackwell) حفظ کرده، در حالی که تارگت کامپایل جدید sm107 را معرفی کرده و مجموعه دستورالعملهای هستههای تانسور tcgen05 را نیز ارتقا داده است. شرکت انویدیا در مقایسه روبین با سیستم GB200 NVL72، بهینهسازیهای اوج پردازشی زیر را به ازای هر پردازنده گزارش میدهد:
- تا ۵ برابر قدرت محاسباتی (FLOPS) بیشتر در استنتاج با فرمت NVFP4
- ۲.۴ برابر پهنای باند حافظه HBM بیشتر با مهاجرت از حافظههای HBM3e به نسل پیشرفته HBM4
- تا ۱.۷ برابر پهنای باند ارتباطی بیشتر میان پردازندهها به لطف نسل ششم رابط NVLink
- ۲ برابر توان عملیاتی توابع نمایی در FP32 و ۴ برابر سریعتر در محاسبات BF16/FP16
فرایند استنتاج مدلهای زبانی بزرگ معمولاً با یک فاز اولیه و سنگین پردازش پرامپت (پیشپر کردن کش) شروع میشود و سپس وارد فاز تولید توکن میگردد که وابستگی شدیدی به سرعت و پهنای باند حافظه دارد. حافظههای HBM4 با جابهجایی بسیار سریعتر وزنهای مدل و دادههای حافظه پنهان کلید-مقدار (KV Cache)، کمک شایانی به مرحله رمزگشایی میکنند. علاوه بر این، سرعت محاسبات بالاتر در توابع نمایی باعث تسریع عملیات سافتمکس (Softmax) در مکانیزم توجه میشود؛ بخشی که در گذشته سرعت بهبود آن همواره از عملیات ضرب ماتریسی عقبتر مانده بود.
نزدیکتر شدن وزنهای MoE به واحدهای پردازشی
کیت توسعه CUDA 13.4 قابلیتی موسوم به «دامنههای مکانی» (Locality Domains) را ارائه میدهد که به نرمافزار اجازه میدهد حافظه و محاسبات را درون یک پردازنده گرافیکی درست در مجاورت یکدیگر قرار دهد. از زمان معماری امپر (Ampere)، دسترسی به حافظه سراسری در پردازندههای گرافیکی انویدیا غیریکنواخت (Non-uniform) بوده است؛ به این معنی که یک پردازنده جریانی (Streaming Multiprocessor) میتواند برخی از بخشهای حافظه HBM را با سرعتی بیشتر از بخشهای دیگر بخواند. دامنههای مکانی به محیطهای اجرایی امکانی میدهند تا مستقیماً از این توپولوژی سختافزاری نهایت بهره را ببرند.
در مرحله رمزگشایی مدلهای MoE، فریمورک vLLM ماتریسهای وزن متخصصان یعنی FC1 و FC2 را به بخشهای ستونی (Shards) تقسیم میکند، هر بخش را به یک دامنه مکانی تخصیص میدهد و سپس از قابلیت Green Contexts در کوودا برای اجرای کرنل اختصاصی هر دامنه استفاده مینماید. با این ترفند، چندپردازندههای جریانی به جای اینکه بارها شبکه داخلی حافظه پردازنده را طی کنند، وزنهای متخصص مجاور خود را مستقیماً فراخوانی میکنند.
طبق گزارش تیم vLLM، این بهینهسازی توانسته میانگین سرعت لایههای MoE در مدل MiniMax M3 را حین پاس رو به جلو (Forward Pass) توکنهای کوتاه تا ۱.۲ برابر افزایش دهد. این نتیجه در تمام پیکربندیهای TP2، TP4، EP2 و EP4 پایدار مانده است؛ جایی که TP نشاندهنده موازیسازی تانسور (Tensor Parallelism)، EP نشاندهنده موازیسازی متخصصان (Expert Parallelism) و اعداد معرف اندازه گروههای موازی است.
دریافت نسخه آزمایشی CUDA 13.4
توسعهدهندگانی که به سختافزارهای روبین دسترسی دارند، میتوانند ایمیج آزمایشی CUDA 13.4 این پروژه را با دستور زیر دریافت کنند:
docker pull vllm/vllm-openai:cu134-nightlyپرچمها و تنظیمات اصلی برای انتخاب کرنلها و مسیرهای ارتباطی سازگار با روبین به شرح زیر هستند:
- پرچم
--linear-backend flashinfer_cutedslبکاند متراکم GEMM از نوع CuTe DSL NVFP4 را فعال میکند و به صورت پیشفرض برای چکپوینتهای NVFP4 فعال است. - پرچم
--moe-backend flashinfer_cutedslهسته محاسباتی CuTe DSL NVFP4 را برای لایههای MoE به کار میاندازد. - تنظیم
--kv-cache-dtype fp8به همراه--attention-backend FLASHINFERیاFLASHINFER_MLAمسیر محاسباتی توجه FP8 بر پایه فناوریهای TensorRT-LLM را فعال میکند. - پرچمهای
--enable-expert-parallel --data-parallel-size N --all2all-backend deepep_low_latencyامکان موازیسازی متخصصان، ارتباطات با تاخیر بسیار کم DeepEP و عملیات ماتریسی Masked Grouped GEMM را برای فرمتهای دستهای متخصصان فراهم میآورند.
پوشش کنونی مدلها شامل دیپسیک، کیمی از استارتاپ مونشات (Moonshot AI)، مدل GLM از شرکت Z.ai و مینیمکس است. تراشههای روبین میتوانند کرنلهای کنونی بلکول را که با تارگت روبهجلو و سازگار sm100f ساخته شدهاند اجرا کنند؛ امری که پوشش اولیه گستردهای را فراهم میسازد تا زمانی که کرنلهای اختصاصی sm107 از راه برسند. از آنجا که ایمیجهای نایتلی مرتباً دستخوش تغییر میشوند، پیشنهاد میشود برای ارزیابیهای محیط عملیاتی، حتماً هش شناسه ایمیج (Digest) را ثابت نگه داشته و نسخههای vLLM، FlashInfer، CUDA و درایورها ثبت و مستند شوند.
محاسبات دنیای واقعی به دادههای بیشتری نیاز دارد
در شرایط ایدهآل و با فرض مقیاسپذیری کاملاً خطی، جهش ۷.۸۴ برابری توان به ازای هر پردازنده گرافیکی میتواند تعداد پردازندههای مورد نیاز برای پاسخگویی به همان حجم درخواستهای بنچمارک AgentX را به حدود ۱۳ درصد سیستمهای GB200 کاهش دهد. همچنین نتیجه ۵.۱۸ برابری، این نیاز را به حدود ۱۹ درصد میرساند. با این وجود، برنامهریزی واقعی برای ظرفیت سرورها به عواملی نظیر نرخ بهرهوری، تأخیرهای دمدراز (Tail Latency)، معماری مدل، طول کانتکست، بچینگ، مصرف برق، هزینه رکها و میزان شباهت برنامههای کاربردی به بارهای کاری تستشده وابسته خواهد بود.
- این نتایج حاصل تستهای اولیه روی سختافزار پیشتولید و تعداد محدودی از نودها است.
- اندازهگیریها توسط تیمهای همکار پروژه منتشر شده و هنوز توسط مراجع مستقل بازتولید و راستیآزمایی نشده است.
- عبارت «تا سقف» (Up to) بهترین سناریوی بهینهسازی را نشان میدهد، نه یک جهش تضمینشده در همه مدلها و الگوهای ترافیکی گوناگون.
- دادههای منتشرشده جزئیات کافی از هزینهها و مصرف انرژی برای تحلیل کامل هزینه کل مالکیت (TCO) را شامل نمیشود.
- پشتیبانی از دامنههای مکانی در CUDA هنوز در مرحله توسعه و طراحی فعال قرار دارد.
نقشه راه آینده vLLM مواردی همچون پشتیبانی گستردهتر از دامنههای مکانی برای لایههای MoE، مسیر اختصاصی FlashInfer MegaMoE در sm107 و مگاکرنلهای ادغامشده را شامل میشود تا سربار حافظه و راهاندازی کرنل در درخواستهای حساس به تاخیر به حداقل برسد. این پروژه همچنین در تدارک ارائه هستههای توجه اختصاصی روبین برای مکانیزمهای KDA، MLA، CSA و HCA برای مدلهای Kimi K3 و DeepSeek-V4.1-Flash است. این قابلیتهای تازه نشان خواهند داد که این پشته نرمافزاری تا چه حد میتواند فراتر از مسیرهای فعلی سازگار با بلکول، از نهایت توان این غول سختافزاری کار بکشد.
مطالب مرتبط و پیشنهادی
نقشه اپل برای پادکستهای هوش مصنوعی: جذب بیسروصدای تیم و فناوری استارتاپ Huxe
اپل با امضای قراردادی هوشمندانه، تیم و فناوری استارتاپ Huxe را جذب کرده تا احتمالاً قابلیت تولید پادکستهای صوتی با هوش مصنوعی را به سرویسهای خود بیاورد. بنیانگذاران این استارتاپ همان چهرههایی هستند که پیش از این پادکستهای گفتوگومحور و پر سر و صدای NotebookLM را ساخته بودند.
شاهکار کمخرج آنتروپیک: کلود هایکو ۵.۵ با هزینه باورنکردنی ۲۴ دلار همه رقبا را جا گذاشت!
مدل چابک و جمعوجور کلود هایکو ۵.۵ (Claude Haiku 5.5) موفق شد با عملکرد درخشان و هزینه باورنکردنی ۲۴.۳ دلار به ازای هر ۱۰۰۰ کوئری، در صدر جدول بهرهوری اقتصادی بنچمارک Parallel قرار بگیرد. این مدل با اختلافی اندک نسبت به برادر بزرگتر و فوقالعاده گرانقیمت خود یعنی کلود اوپوس، هزینهها را تا یکسیونهم کاهش داده است. این جهش خیرهکننده نشان میدهد که توسعهدهندگان میتوانند با بودجهای بسیار اقتصادی، ایجنتهای هوش مصنوعی فوقالعاده قدرتمندی برای جستجو و وبگردی بسازند.
اشتهای سیریناپذیر هوش مصنوعی برای زمین و انرژی: دیتاسنترهایی که مزارع چند ایالت آمریکا را میبلعند!
تب تند توسعه هوش مصنوعی حالا پایش به مزارع گندم و چراگاههای آرام آمریکا باز شده و دیتاسنترهای عظیم در حال تصاحب دهها هزار هکتار از اراضی کشاورزی هستند. اما ماجرا فقط از دست رفتن زمینها نیست؛ خلأهای قانونی و فرآیندهای اداری ناقص باعث شده ابعاد واقعی مصرف نجومی برق و زیرساختهای جانبی این غولهای دیجیتال از دید مردم و شوراهای محلی پنهان بماند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.