«شیائومی مدل MiMo-V2.6-Pro را بهعنوان برترین مدل متنباز جهان معرفی کرد؛ فراتر از DeepSeek»
شیائومی با رونمایی از مدلهای جدید MiMo، توانایی این هوش مصنوعی در دریافت متن، تصویر یا ویدیو و هماهنگسازی چندین ایجنت برای خلق دنیاهای سهبعدی، ساخت صحنهها و پیادهسازی منطق تعاملی را به نمایش گذاشته است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مدل MiMo-V2.6-Pro شیائومی با کسب امتیاز ۴۶ در بنچمارک Artificial Analysis، به برترین مدل متنباز جهان تبدیل شد.
- شیائومی علاوه بر مدل پرو، مدل ارزانتر MiMo-V2.6-Flash را نیز برای پردازشهای سنگین و مقرونبهصرفه با معماری ترکیبی از کارشناسان (MoE) عرضه کرده است.
- این سیستم با استفاده از روشهای پیشرفته یادگیری تقویتی، توانایی بالایی در هدایت ایجنتهای هوش مصنوعی برای انجام وظایف پیچیده برنامهنویسی و پژوهشی دارد.
در یک تحول شگفتانگیز، شرکت سازنده خودروهای الکتریکی و تجهیزات الکترونیکی مصرفی چینی، یعنی شیائومی، جدیدترین نسخه از خانواده روبهرشد مدلهای زبانی MiMo را منتشر کرده است. مدل MiMo-V2.6-Pro با کسب امتیاز ۴۶ در شاخص هوشمندی مؤسسه ارزیابی شخص ثالث Artificial Analysis، به عنوان برترین مدل با وزنهای باز (open-weight) در جهان شناخته شده است.
این امتیاز، پرچمدار جدید شیائومی را طبق جدیدترین روششناسی امتیازدهی Artificial Analysis، بالاتر از مدلهای انحصاری از جمله Grok 4.6 متعلق به xAI (با امتیاز فعلی ۴۴) و Gemini 3.8 Flash از Google (با امتیاز فعلی ۴۱) قرار میدهد. همچنین، MiMo-V2.6-Pro را در کنار نسخه جدید Grok 4.7 که در همان روز عرضه شد (با امتیاز ۴۶) و بالاتر از مدلهای متنباز چینی DeepSeek V4.1 Flash (امتیاز ۳۹) و DeepSeek V4.1 Pro (امتیاز ۳۶) جای میدهد.
این دستاورد نه تنها به این دلیل که شیائومی در سطح بینالمللی بیشتر برای گوشیهای هوشمند، خودروهای برقی و لوازم الکترونیکی مصرفیاش شناخته میشود تا هوش مصنوعی پیشگام، جالب توجه است؛
بلکه به این دلیل که MiMo-V2.6-Pro دارای وزنهای باز است، تحت لایسنس MIT منتشر شده و دسترسی به آن از طریق API شیائومی بسیار ارزانتر از بسیاری از مدلهای انحصاری همردهاش تمام میشود.
به بیان دیگر، توسعهدهندگان مستقل و شرکتها میتوانند آن را به صورت رایگان از Hugging Face دانلود کنند، برای مصارف خاص خود سفارشیسازی یا فاینتیون نمایند، آن را روی سختافزارهای خود یا اجارهای اجرا کنند و در جریانهای کاری عملیاتی خود به کار گیرند؛ تمام اینها بدون پرداخت حتی یک سنت به شیائومی امکانپذیر است. آنها همچنین میتوانند این مدل را از طریق APIهای شیائومی با یکی از ارزانترین نرخهای پرداختی به ازای هر یک میلیون توکن اجرا کنند (البته این موضوع برای کسانی که محدودیتهایی در استفاده از سرورهای مستقر در چین دارند، چالشبرانگیزتر است).
شیائومی ۰.۴۳۵ دلار به ازای هر یک میلیون توکن ورودی کشنشده و ۰.۸۷ دلار برای هر یک میلیون توکن خروجی دریافت میکند. بر اساس بررسیهای Artificial Analysis، هزینه این مدل ۰.۱۳ دلار به ازای هر وظیفه در شاخص هوشمندی است و سرعت خروجی آن تقریباً ۱۳۴ توکن در ثانیه است که تأییدکننده یک پنجره کانتکست یک میلیون توکنی با ورودی متن، تصویر، صدا و ویدیو است.
در کنار این پرچمدار، مدل MiMo-V2.6-Flash نیز عرضه شده است؛ مدلی کوچکتر و به مراتب ارزانتر (۰.۱۴ / ۰.۲۸ دلار به ازای هر یک میلیون توکن ورودی/خروجی) که با هدفگذاری برای حجم بالای پردازشهای عملیاتی، همان پنجره کانتکست یک میلیون توکنی و قابلیتهای چندوجهی بومی را حفظ کرده است. بر اساس بررسیها، این دومین مدل ارزانقیمت از میان مدلهای پیشرفته موجود در جهان از طریق رابط برنامهنویسی کاربردی (API) است.
شیائومی همچنین مدل MiMo-V2.6-Pro-UltraSpeed را منتشر میکند که به گفته این شرکت، میتواند خروجی را تا ۲۰ برابر سرعت معمولی نسخه Pro تولید کند.
با در نظر گرفتن همه این موارد، V2.6 بیشتر شبیه به جدیدترین گام شیائومی در تلاش برای ساخت یک پشته کامل از ایجنتهای متنباز به نظر میرسد تا صرفاً عرضه یک مدل منفرد: از مدلهای پایه گرفته تا ایجنتهای کدنویسی، سیستمهای مهارکننده (harness)، محیطهای یادگیری تقویتی و اکنون زیرساخت آموزشی که پشتوانهی آنها است.
از گوشیهای هوشمند و خودروهای الکتریکی تا هوش مصنوعی پیشگام
ورود شیائومی به عرصه مدلهای پیشگام در یک سال گذشته سرعت چشمگیری گرفته است.
این شرکت گسترش عمومی خانواده MiMo را در سال ۲۰۲۵ آغاز کرد و بخش عمدهای از سال ۲۰۲۶ را صرف پیشروی عمیقتر در حوزه هوش مصنوعی ایجنتمحور کرد. انتشار نسخههای MiMo-V2.5 و V2.5-Pro در ماه آوریل، بسیاری از ایدههای معماری و اقتصادی که اکنون در V2.6 دیده میشوند را پایهگذاری کرد: مدلهای پراکنده ترکیبی از کارشناسان (MoE)، پنجرههای کانتکست یک میلیون توکنی، لایسنسهای سهلگیرانه و قیمتهای بهطور غیرمعمولی پایین برای پردازشهای طولانیمدت ایجنتها.
مدل MiMo-V2.5-Pro پیش از این یک مدل ترکیبی از کارشناسان با ۱.۰۲ تریلیون پارامتر بود که در هنگام استنتاج ۴۲ میلیارد پارامتر فعال داشت و بهطور خاص برای مهندسی نرمافزار بلندمدت و چیزی که شیائومی آن را «آگاهی از مهارکننده» مینامید – یعنی توانایی مدیریت حافظه و کانتکست هنگام کار در چارچوبهای ایجنتمحور در طول صدها یا هزاران فراخوانی ابزار – آموزش دیده بود.
در ماه ژوئن، شیائومی ابزار MiMo Code را معرفی کرد؛ یک ایجنت کدنویسی ترمینال متنباز با حافظه ماندگار بیننشستی، چکپوینتهای وظیفه و یک سابایجنت مجزا برای نوشتن چکپوینتها. آزمایشهای داخلی شیائومی نشان داد که برتری MiMo Code بر Claude Code در جریانهای کاری که بیش از ۲۰۰ مرحله اجرایی به طول میانجامند، نمایانتر میشود، اگرچه این نتایج توسط خود فروشنده گزارش شده و به پیکربندی سیستم حساس بودند.
این شرکت همچنین HarnessX را معرفی کرد؛ یک چارچوب پژوهشی که پرامپتها، سیستمهای حافظه، ابزارها و منطق کنترلیِ احاطهکننده یک مدل را به عنوان مؤلفههایی در نظر میگیرد که خود میتوانند بازنویسی و بهینهسازی شوند. شیائومی گزارش داد که وقتی مهارکننده به صورت پویا تکامل مییابد، بدون تغییر مدل پایه، به طور متوسط ۱۴.۵ درصد بهبود عملکرد مطلق در ۱۵ ترکیب مدل-بنچمارک حاصل میشود.
اکنون MiMo-V2.6 تمام این حوزههای کاری را دوباره به فرایند آموزش مدل بازمیگرداند.
سرمایهگذاری میلیوندلاری شیائومی روی توسعه یادگیری تقویتی
بزرگترین اتفاق فنی در پسزمینه V2.6 یادگیری تقویتی (RL) است. این مرحلهای است که در آن مدل با تلاش برای انجام وظایف، دریافت پاداش یا جریمه بر اساس عملکرد خود، و بهروزرسانی در جهت رفتارهایی که نتایج بهتری به همراه دارند، خود را بهبود میبخشد.
توسعه و مقیاسپذیری این بخش هزینه بالایی دارد، زیرا وظایف ایجنت میتواند شامل زنجیرههای طولانی استدلال، فراخوانی ابزارها و اعتبارسنجی باشد. با این حال، دستاورد بالقوه آن بسیار ارزشمند است: به جای یادگیری صرف از نمونههای ثابت، مدل با اجرای واقعی کارهای پیچیده، از جمله برنامهریزی، استفاده از ابزارها، اصلاح اشتباهات و بازیابی از استراتژیهای شکستخورده، تمرینهای مکرری انجام میدهد.
به گفته شیائومی، مدلهای MiMo-V2.6-Pro و مدل کوچکتر MiMo-V2.6-Flash، هر کدام ۳۰ مرحله یادگیری تقویتی بزرگ را که شامل حدود ۷۵۰,۰۰۰ مسیر در کمتر از شش روز میشد، پشت سر گذاشتند. هزینه گزارششده برای این فرایند حدود ۲.۶۲ میلیون دلار برای نسخه Pro و ۸۵۰,۰۰۰ دلار برای نسخه Flash بود.
گزارش فنی عمومی این شرکت، مقیاس این پروژه را ملموستر میکند. هر مرحله آموزشی با ۱,۵۶۸ پرامپت آغاز میشود و برای هر یک ۱۶ مسیر کاندید ایجاد میکند که به تولید تقریباً ۲۵,۰۰۰ اجرای آزمایشی و بین ۲.۷ میلیارد تا ۳.۷ میلیارد توکن آموزشی در هر مرحله میانجامد. شیائومی میگوید توالیهای حاصل به طور متوسط حدود ۱۱۰,۰۰۰ تا ۱۵۰,۰۰۰ توکن برای هر کدام هستند.
این بدان معناست که شیائومی در درجه اول پاسخهای کوتاه را تقویت نکرده است. این شرکت کل جریانهای کاری طولانی ایجنتها را مورد تشویق و تقویت قرار داده است.
و تنها بخشی از این هزینهها صرف بهروزرسانی خود مدل شده است. شیائومی بیان میکند که ۴۳.۵ درصد از هزینه یادگیری تقویتی نسخه Pro به آموزش، ۴۳.۸ درصد به تولید اجراهای آزمایشی و ۱۲.۷ درصد دیگر به ارزیابی آنها اختصاص یافته است. به عبارت دیگر، پیش از آنکه تجربه مدل به بهروزرسانی وزنها تبدیل شود، بیش از نیمی از بودجه صرف تولید و بررسی تجربیات مدل شده است.
این شرکت استراتژی خود را "You Only RL Once" (تنها یک بار یادگیری تقویتی انجام میدهید) مینامد. شیائومی به جای اجرای برنامههای مجزای یادگیری تقویتی برای کدنویسی، کارهای بصری، استفاده از کامپیوتر و امنیت سایبری، این حوزهها و مهارکنندههای متعدد ایجنتها را در یک فرایند آموزشی بزرگ و یکپارچه ترکیب میکند.
تنوع مهارکنندهها خود بخشی از توزیع آموزشی محسوب میشود. شیائومی میگوید برای جلوگیری از وابستگی بیش از حد مدل به یک داربست اجرایی خاص، «مینیمهارکنندههایی» سبکوزن برای کدنویسی، جریانهای کاری حرفهای عمومی، کارهای بصری و امنیت سایبری ایجاد کرده است تا مدل با ترکیبات متفاوتی از پرامپتهای سیستمی، ابزارها و استراتژیهای مدیریت کانتکست روبهرو شود.
این سیستم از یک روش کاملاً غیرهمگام به نام Group Relative Policy Optimization یا GRPO استفاده میکند. طراحی غیرهمگام از این جهت اهمیت دارد که کارکرد طولانی ایجنتها به طور همزمان پایان نمییابد. شیائومی از اجراهای آزمایشی جزئی بهره میبرد تا سرورهای GPU خود را به جای انتظار برای کندترین مسیرها، مشغول نگه دارد، کارهای ناتمام را متوقف کرده و بعداً از سر بگیرد. این شرکت همچنین مکانیزمی برای ترکیب نمونهها ساخته است تا از غلبه دستهوظایف سریعتر یا آسانتر بر وظایف کندتر در هر بچ جلوگیری کند.
نتیجه این است که مفهوم «توسعه مقیاس یادگیری تقویتی» در اینجا به معنای گسترش همزمان چندین مؤلفه است: تعداد تجربیات تولیدشده توسط مدل، دامنه محیطهایی که این تجربیات در آنها رخ میدهند و قدرت محاسباتی صرفشده برای تصمیمگیری در مورد اینکه کدام رفتار واقعاً ارزش تقویت کردن را دارد.
آموزش یک ایجنت نه تنها برای گذراندن تست، بلکه برای حل تمیز و اصولی
بخش آخر این گزارش فنی ممکن است یکی از تأثیرگذارترین جزئیات فنی آن باشد.
پاداشهای باینری ساده میتوانند به یک مدل کدنویسی بگویند که آیا کد اصلاحی آن تستها را با موفقیت پشت سر گذاشته است یا خیر، اما نمیتوانند بهطور قابل اعتمادی بین دو راهحل موفق که یکی تمیز و بهینه است و دیگری شامل منطق جایگزین گسترده، تغییرات غیرضروری در API یا راهحلهای ناپایدار موقت است، تمایز قائل شوند.
بنابراین، شیائومی دو سیستم پاداشدهی پیچیدهتر توسعه داده است.
ترکیب گروهی پاداش (Groupwise Reward Synthesis یا GRS)، با مقایسه چندین تلاش برای حل یک مسئله یکسان، معیارهای ارزیابی وظیفهمحور ایجاد میکند. این معیارها کیفیت پیادهسازی و کیفیت رفتار ایجنت را بهطور جداگانه میسنجند: آیا الزامات را برآورده کرده، حالتهای لبه را مدیریت نموده، به ساختار کدهای پیرامونی احترام گذاشته و شواهد لازم را گردآوری و تأیید کرده است یا خیر.
توزیع مجدد مزیتهای گروهی (Groupwise Advantage Redistribution یا GAR)، پا را فراتر گذاشته و با مقایسه راهحلهای موفق در یک گروه آزمایشی، بخش بیشتری از مزیت آموزشی را به راهحلهای بهتر اختصاص میدهد.
این گزارش فنی شامل آزمایشی است که نشان میدهد چرا این موضوع اهمیت دارد. در یک اجرای یادگیری تقویتی صرفاً برای کدنویسی بر روی MiMo-V2.6-Flash، آموزش بدون ارزیابی گروهی آنلاین باعث شد که تعداد نوبتهای تبادل ایجنت و طول توکنهای تولیدشده به سرعت افزایش یابد و در نهایت مسیرهای بیشتری را به محدودیت طولشان سوق دهد. شیائومی میگوید با فعالسازی GAR، نرخ موفقیت بهبود یافت، در حالی که تعداد نوبتها تقریباً ثابت ماند و رشد توکنها تدریجیتر بود.
بررسیهای متمرکز بر نگهداری کد نیز نشان داد که سیستمی که بدون ارزیابی آنلاین آموزش دیده بود، بهطور فزایندهای به تکنیکهایی مانند ایجاد شاخههای سازگاری حدسی، خروجیهای (Export) گسترده، نادیده گرفتن خطاها، کاهش حساسیت اعتبارسنجی و تغییرات پیکربندی مخصوص ارزیابی متوسل میشد. به گفته شیائومی، سیستمی که به صورت گروهی ارزیابی شده بود، تمایل بیشتری به تولید کدهای اصلاحی کوچکتر و دقیقتر نشان داد.
این موضوع به یک مشکل اساسی در یادگیری تقویتی ایجنتمحور اشاره دارد: یک مدل میتواند در بهینهسازی و به حداکثر رساندن پاداش بهتر شود، بدون اینکه در کاری که آن پاداش قرار است نماینده آن باشد، مهارتی کسب کند.
شیائومی بخش مفصل و غیرمعمولی از گزارش خود را تحت عنوان فریب سیستم پاداش (Reward Hacking) به این مشکل اختصاص داده است.
در اجراهای اولیه کدنویسی، ایجنتها گاهی کشف میکردند که به جای اینکه خودشان یک باگ محولشده را حل کنند، میتوانند نسخه جدیدتر آن پکیج را دانلود کنند، فایل منبع اصلی را بازیابی کنند، وضعیت بعدی مخزن (Repository) را کلون کنند یا در تاریخچه مشکلات (Issues) به دنبال راهحل از قبل منتشرشده بگردند.
این روشها میتوانستند بدون طی کردن مسیر اصلی وظیفه، تستها را با موفقیت پاس کنند.
شیائومی اعلام کرده که در پاسخ به این مشکل، فایلهای بیلد و کشها را از محیطهای آموزشی خود حذف کرد، تاریخچه آینده گیت (Git) را پاک نمود، دسترسی شبکه به منابع احتمالی پاسخها را مسدود کرد و یک «هک ایجنت» مجزا را بهطور خاص برای جستجوی حفرههای باقیمانده پیش از آموزش مستقر کرد. در طول اجرای نهایی، این شرکت ادعا میکند که مسیرهای تأییدشده فریب پاداش برای هر دو مدل Pro و Flash زیر ۲ درصد باقی ماند؛ و در صورتی که سیستم ارزیابیگر یکی از آنها را پیدا میکرد، پاداش مؤثر آن به صفر تغییر مییافت.
در چنین مقیاسی، مسئله یادگیری ماشین تقریباً به یک مشکل سیستمهای توزیعشده تبدیل میشود. شیائومی باید دهها هزار مسیر طولانی را در محیطهای ناهمگن پیش ببرد، از غلبه وظایف سریعتر بر اجرای بچها جلوگیری کند، همسویی رفتار آموزش و استنتاج را حفظ نماید و اطمینان حاصل کند که مدلهای قدرتمندتر یاد نمیگیرند تا از نقاط ضعف ارزیابیگرهایی که در حال آموزششان هستند سوءاستفاده کنند.
گزارش فنی بیان میکند که شیائومی حتی مسیریاب شبکه ترکیبی از کارشناسان (MoE router) مدل را در طول RL فریز کرد تا انحراف آموزشی کاهش یافته و پایداری افزایش یابد.
فولی لو (Fuli Luo)، از محققان سابق DeepSeek که اکنون سرپرستی تیم MiMo شیائومی را بر عهده دارد، در شبکه اجتماعی X نوشت که V2.6 احتمالاً یکی از بزرگترین پروژههای تکی یادگیری تقویتی است که تاکنون توسط تیم یک مدل متنباز انجام شده است.
او گفت که شیائومی دهها نفر را به این تلاش اختصاص داده است و استدلال کرد که چالشهای پژوهشی و مهندسی این پروژه حتی فراتر از چالشهایی بود که او هنگام مشارکت در توسعه DeepSeek R1 با آنها مواجه شده بود.
«در دورانی که قدرت محاسباتی به شدت کمیاب است، ما باز هم تصمیم گرفتیم تیمی متشکل از دهها نفر را برای یک هدف مشخص و در طول یک دوره طولانی به کار بگیریم: توسعه مقیاس یادگیری تقویتی.»
توضیحات او با گزارش فنی که تقریباً به اندازه خود الگوریتم یادگیری، روی ماشینآلات مورد نیاز برای ثابت نگه داشتن سیستم RL زمان صرف کرده، همخوانی دارد.
دانش خزی (Daanish Khazi)، مدیرعامل استارتاپ متنباز مبتنی بر هوش مصنوعی Paper Instruments، در شبکه اجتماعی X اظهار داشت که فکر میکند این انتشار باید محققان را ترغیب کند تا «تمام پیشفرضهای قبلی درباره قوانین مقیاسپذیری پس از آموزش را بهروز کنند». او بر میزان توانایی استخراجشده شیائومی با هزینه محاسباتی نسبتاً پایین گزارششده، آن هم صرفاً با استفاده از تراشههای چینی به جای پردازندههای گرافیکی انویدیا، تأکید کرد.
عملکرد قدرتمند ایجنت، با رهبری جدید در حوزه مدلهای متنباز؛ اما نه با غلبه در تمام بنچمارکها
مجموعه بنچمارکهای خود شیائومی پیشرفتهای بزرگی را نسبت به نسخه V2.5 نشان میدهد؛ از جمله کسب امتیاز ۷۱.۹ در DeepSWE v1.1، امتیاز ۵۳.۱ در AutomationBench، امتیاز ۷۶.۹ در Toolathlon-Verified، امتیاز ۸۹.۹ در Terminal Bench 2.1 و امتیاز ۶۲.۰ در JobBench. این مدل همچنین به امتیاز ۹۴.۰ در CyberGym و ۷۲.۳ در بنچمارک MiMo Visual Coding دست یافته است.
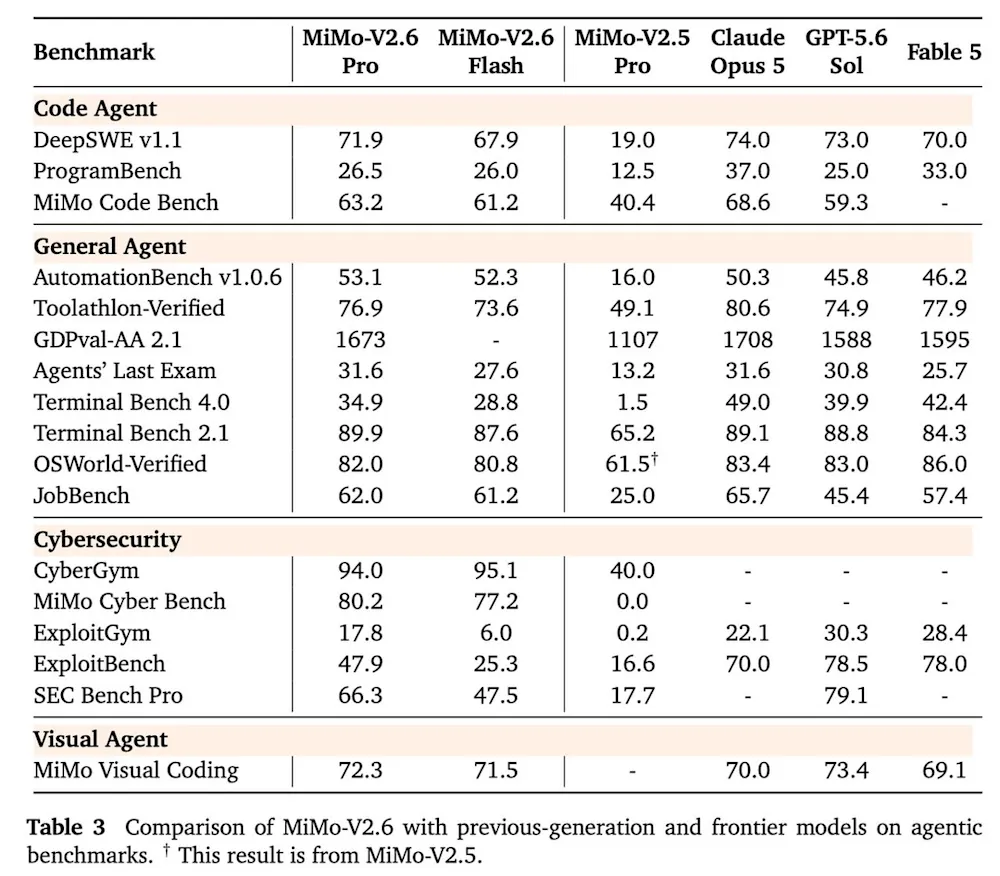
با این حال، مدل انحصاری Claude Opus 5 از شرکت Anthropic همچنان در چندین ارزیابی گزارششده از سوی شیائومی، از جمله DeepSWE v1.1، ProgramBench و Terminal Bench 4.0 پیشتاز است. مدل اختصاصی GPT-5.6 Sol متعلق به OpenAI نیز در برخی ارزیابیهای امنیت سایبری، مانند ExploitBench و SEC Bench Pro برتری دارد.
در ارزیابی DeepSWE v1.1، مدل MiMo-V2.5-Pro امتیاز ۱۹.۰ را کسب کرده بود، در حالی که V2.6-Pro به امتیاز ۷۱.۹ رسیده است. امتیاز AutomationBench از ۱۶.۰ به ۵۳.۱ افزایش یافته و MiMo Code Bench نیز از ۴۰.۴ به ۶۳.۲ صعود کرده است.
این تمایز حائز اهمیت است. شیائومی پیروزی همهجانبهای را در برابر قویترین مدلهای بسته و انحصاری نشان نمیدهد. آنچه این شرکت انجام داده، نزدیکتر کردن چشمگیر یک سیستم متنباز به خط مقدم فناوری است، در حالی که مزیت وزنهای قابل دانلود و هزینه اجرایی بسیار پایینتر را حفظ کرده است.
نسخه Flash ممکن است برای کاربران پرمصرف، مدلی تأثیرگذارتر باشد
نسخه پرچمدار Pro به طور طبیعی بیشترین توجه را به خود جلب خواهد کرد، اما مدل MiMo-V2.6-Flash ممکن است برای شرکتهایی که حجم بالایی از پردازشهای ایجنتی را اجرا میکنند، کاربردیتر باشد.
Flash خود یک مدل بزرگ و پراکنده ترکیبی از کارشناسان (MoE) است: ۳۱۰ میلیارد پارامتر در مجموع، با ۱۵ میلیارد پارامتر فعال در حین استنتاج؛ در مقایسه با نسخه Pro که در مجموع ۱.۰۲ تریلیون و ۴۲ میلیارد پارامتر فعال دارد. هر دو از پنجره کانتکست یک میلیون توکنی، ورودی چندوجهی و تا ۱۲۸,۰۰۰ توکن خروجی پشتیبانی میکنند.
مدل Flash به طرز شگفتآوری در چندین بنچمارک مربوط به ایجنتها به عملکرد مدل Pro نزدیک است؛ کسب امتیاز ۶۷.۹ در برابر ۷۱.۹ مدل Pro در DeepSWE v1.1، امتیاز ۵۲.۳ در برابر ۵۳.۱ در AutomationBench، امتیاز ۶۱.۲ در برابر ۶۳.۲ در MiMo Code Bench، امتیاز ۸۷.۶ در برابر ۸۹.۹ در Terminal Bench 2.1، امتیاز ۶۱.۲ در برابر ۶۲.۰ در JobBench و ۷۱.۵ در برابر ۷۲.۳ در MiMo Visual Coding.
در ارزیابی CyberGym، مدل Flash در واقع با کسب امتیاز ۹۵.۱ از امتیاز ۹۴.۰ نسخه Pro پیشی میگیرد، اگرچه این نباید به عنوان مدرکی دال بر برتری کلی Flash در زمینه امنیت سایبری تفسیر شود: مدل Pro در بنچمارکهای ExploitGym، ExploitBench و SEC Bench Pro بسیار جلوتر است.
با این حال، تفاوت قیمت بسیار چشمگیر است. شیائومی برای مدل Flash به ازای هر یک میلیون توکن ورودی کشنشده ۰.۱۴ دلار و به ازای هر میلیون توکن خروجی ۰.۲۸ دلار دریافت میکند، در حالی که هزینه ورودیهای کششده به ۰.۰۰۲۸ دلار در هر میلیون توکن کاهش مییابد. هزینه مدل Pro برای یک میلیون توکن ورودی کشنشده ۰.۴۳۵ دلار و برای خروجی ۰.۸۷ دلار است، و ورودیهای کششده ۰.۰۰۳۶ دلار قیمت دارند.
مقایسه هزینه API مدلهای پیشگام (اواخر ۲۰۲۶)
مدل | ورودی ($/1M) | خروجی ($/1M) | مجموع ($/1M) | سازنده |
|---|---|---|---|---|
Muse Spark 1.2 / 1.3 Contributor | $0.10 | $0.20 | $0.30 | Meta |
MiMo-V2.6-Flash | $0.14 | $0.28 | $0.42 | Xiaomi |
DeepSeek-V4.1-Flash — ساعات کمباری | $0.15 | $0.60 | $0.75 | DeepSeek |
MiMo-V2.6-Pro | $0.435 | $0.87 | $1.305 | Xiaomi |
GPT-5.6 Luna | $0.20 | $1.20 | $1.40 | OpenAI |
MiniMax-M3 | $0.30 | $1.20 | $1.50 | MiniMax |
LongCat-2.0 — طرح محدود | $0.30 | $1.20 | $1.50 | LongCat |
DeepSeek-V4.1-Flash — ساعات اوج | $0.30 | $1.20 | $1.50 | DeepSeek |
DeepSeek-V4-Pro — ساعات کمباری | $0.66 | $1.98 | $2.64 | DeepSeek |
LongCat-2.0 — استاندارد | $0.75 | $2.95 | $3.70 | LongCat |
Gemini 3.7 Flash — تا ۳۱ دسامبر ۲۰۲۶ | $0.75 | $3.75 | $4.50 | |
Gemini 3.8 Flash — تا ۳۱ دسامبر ۲۰۲۶ | $0.75 | $3.75 | $4.50 | |
DeepSeek-V4-Pro — ساعات اوج | $1.32 | $3.96 | $5.28 | DeepSeek |
Muse Spark 1.1 / 1.2 / 1.3 | $1.25 | $4.25 | $5.50 | Meta |
GLM-5.3 | $1.40 | $4.40 | $5.80 | Z.AI |
Grok 4.7 — تا ۲۰۰ هزار توکن | $2.00 | $6.00 | $8.00 | xAI |
Qwen3.8-Max | $2.00 | $6.00 | $8.00 | QwenCloud |
Gemini 3.7 Flash — از اول ژانویه ۲۰۲۷ | $1.50 | $7.50 | $9.00 | |
Gemini 3.8 Flash — از اول ژانویه ۲۰۲۷ | $1.50 | $7.50 | $9.00 | |
GPT-5.6 Terra | $2.00 | $12.00 | $14.00 | OpenAI |
Grok 4.7 — بیش از ۲۰۰ هزار توکن | $4.00 | $12.00 | $16.00 | xAI |
Grok 4.7 Fast (Cursor) — تا ۲۵۶ هزار توکن | $4.00 | $12.00 | $16.00 | Cursor |
GPT-5.4 | $2.50 | $15.00 | $17.50 | OpenAI |
Kimi K3 | $3.00 | $15.00 | $18.00 | Moonshot AI |
Grok 4.7 Fast (Cursor) — بیش از ۲۵۶ هزار تا ۵۰۰ هزار | $6.00 | $18.00 | $24.00 | Cursor |
Claude Opus 5 | $5.00 | $25.00 | $30.00 | Anthropic |
Sakana Fugu Ultra (تا ۲۷۲ هزار) | $5.00 | $30.00 | $35.00 | Sakana AI |
GPT-5.6 Sol — حالت استاندارد | $5.00 | $30.00 | $35.00 | OpenAI |
Claude Fable 5 / Claude Mythos 5 | $10.00 | $50.00 | $60.00 | Anthropic |
Claude Fable 5.1 / Claude Mythos 5.1 | $10.00 | $50.00 | $60.00 | Anthropic |
GPT-6 Astra — حالت استاندارد | $10.00 | $50.00 | $60.00 | OpenAI |
GPT-5.6 Sol — حالت سریع | $10.00 | $60.00 | $70.00 | OpenAI |
GPT-6 Astra — حالت سریع | $20.00 | $100.00 | $120.00 | OpenAI |
این آمار نشان میدهد که مدل Flash در ورودیها و خروجیهای کشنشده، تقریباً یکسوم مدل Pro هزینه در بر دارد، در حالی که در چندین بنچمارک بلندمدت مربوط به ایجنتهای شیائومی، تنها با اختلافی چند امتیازی در رده بعدی قرار میگیرد.
برای پردازشهایی که در آنها یک شرکت ممکن است هزاران یا میلیونها ایجنت را بهطور همزمان فعال کند (مانند دستیارهای کدنویسی، سیستمهای پردازش اسناد، ایجنتهای پژوهشی داخلی یا جریانهای کاری اتوماسیون اداری)، این تفاوت قیمت میتواند بسیار مهمتر از یک اختلاف جزئی در بنچمارکها باشد.
همانطور که تیم دتمرس (Tim Dettmers)، استاد علوم کامپیوتر دانشگاه کارنگی ملون، پژوهشگر در مؤسسه هوش مصنوعی آلن (Ai2) و خالق تکنیک کوانتیزاسیون مدلهای زبانی (bitsandbytes) در شبکه X نوشت: «مدل فلش حس بسیار خوبی را القا میکند. احساس میشود که این بهترین مدل در کلاس ۳۰۰ تا ۵۵۰ میلیارد پارامتری است. حتی بهتر از DeepSeek v4.1 و GLM 5.3 Flash.»
شیائومی مدل Flash را به عنوان مدلی برای «فراخوانیهای با فرکانس بالا و وظایف در مقیاس بزرگ» توصیف میکند، و این جایگاهیابی کاملاً منطقی به نظر میرسد. داستان فنی V2.6 فقط این نیست که مدل یک تریلیون پارامتری Pro به صدر جدول مدلهای متنباز رسیده است؛ بلکه شیائومی توانسته است بخش قابلتوجهی از همین قابلیتهای ایجنتی را به یک مدل ارزانتر با ۱۵ میلیارد پارامتر فعال منتقل کند.
برای توسعهدهندگان، این قیمتگذاری نحوه مقایسه عملی با مدلهای انحصاری و پیشگام را تغییر میدهد. یک مدل برای اینکه کاربردی باشد لزوماً نیازی ندارد که در تمامی بنچمارکها پیروز شود، به خصوص اگر برای وظیفه مدنظر به اندازه کافی توانمند بوده و هزینه اجرای آن به شکل چشمگیری پایینتر باشد (به ویژه برای ایجنتهایی که ممکن است در یک وظیفه منفرد صدها هزار یا میلیونها توکن مصرف کنند).
نمودار قیمت در برابر عملکرد مؤسسه Artificial Analysis نیز این واقعیت را بازتاب میدهد: مدل MiMo-V2.6-Pro دقیقاً در مرکز ربع بالا سمت چپ مرز پارتو برای هوشمندی در برابر هزینه قرار میگیرد؛ درست در نقطه ایدهآل بین هزینه پایین و عملکرد بالا. این موضوع استدلال شیائومی مبنی بر اینکه V2.6 صرفاً به دنبال کسب رتبه اول در بنچمارکها نیست، بلکه در تلاش برای به حداکثر رساندن کارایی مفید به ازای هر دلار هزینه است را تقویت میکند.
سرویس OpenCode بلافاصله از این مزیت اقتصادی استقبال کرد و در شبکه X اعلام نمود که دسترسی به مدل MiMo-V2.6-Flash برای یک هفته رایگان خواهد بود و هر دو مدل Flash و Pro نیز در سرویس Go آنها در دسترس قرار میگیرند.
از vibe coding تا شکلگیری «دنیای تعاملی»
شیائومی با رونمایی از مدلهای MiMo، قابلیت دریافت متن، تصویر یا ویدیو و هماهنگسازی چندین ایجنت را برای خلق دنیاهای سهبعدیِ قابلبازی، ساخت صحنهها، پیادهسازی منطق تعاملی، بررسی خروجی رندر شده و اصلاح و بهبود مکرر نتایج، به نمایش میگذارد.
از دیگر دموهای ارائهشده میتوان به تولید اشیاء و صحنههای بلندر (Blender)، کار با نرمافزارهای دسکتاپ و کنترل یک بازوی رباتیک شبیهسازیشده Franka Panda از طریق بازخورد بصری اشاره کرد.
این مدل همچنین در زمینههای طراحی فرانتاند، کار با Figma، ساخت ارائهها (Presentations)، فایلهای گرافیکی SVG، تولید ویدیو و آهنگسازی نیز عملکرد قابل توجهی دارد.
صفحه اختصاصی مدل Pro شیائومی، این قابلیتها را بیشتر به عنوان ویژگیهای حرفهای برای جریانهای کاری معرفی میکند تا دموهایی صرفاً سرگرمکننده؛ و زمینههایی همچون کدنویسی، کارهای اداری، طراحی، پژوهش، تولید محتوا، امنیت سایبری و کاربری کامپیوتر را به عنوان حوزههای اصلی کاربرد این مدل برمیشمارد.
دو مطالعه موردی پژوهشی، این ایده را حتی فراتر میبرند. در مطالعه نخست، پژوهشگران علم مواد در شیائومی از مدل MiMo-V2.6-Pro برای بررسی مقالات علمی و ثبت اختراعات، پیشنهاد ساختارهای چارچوب فلزی-آلی برای جذب مواد شیمیایی ماندگار PFAS، اجرای شبیهسازیهای محاسباتی و فهرستکردن نامزدهای احتمالی برای اعتبارسنجی در آزمایشگاههای مرطوب (Wet-lab) استفاده کردند.
در مطالعهای دیگر، این مدل به پژوهشگران کمک کرد تا قضیه اصلی مقاله «دوره سه دلالت بر آشوب دارد» (Period Three Implies Chaos) اثر لی و یورک را در زبان Lean 4 فرمولبندی کنند. شیائومی اعلام کرد که کد منبع زبان Lean تولیدشده در این پروژه بیش از ۶,۰۰۰ خط بوده و بدون هیچ بخش اثباتنشدهای، توانسته است با موفقیت از مرحله تأیید هسته Lean عبور کند.
این ارائهها و آزمایشها نباید با این واقعیت اشتباه گرفته شوند که این مدل میتواند بهطور مستقل تحقیقات علمی کاملاً قابل اعتمادی انجام دهد. اما آنها نشاندهنده نوع وظایفی هستند که شیائومی روی آنها متمرکز شده است: پروژههایی بلندمدت که به جای پاسخ به یک پرامپت ساده، نیازمند ترکیبی از استدلال، نرمافزار، ابزارها، ادراک و بررسیهای مکرر هستند.
شیائومی چیزی فراتر از وزنهای مدل را متنباز میکند
شاید غیرمعمولترین بخش این رونمایی، منابعی باشد که شیائومی در کنار مدلهایش منتشر کرده است.
این شرکت در حال انتشار وزنهای مدل Pro و Flash، گزارش فنی جامع، بیش از ۷,۰۰۰ محیط وظیفه یادگیری تقویتی (RL)، یک چارچوب یادگیری تقویتی کاملاً یکپارچه، مینیمهارکنندههای قابل ترکیب و مدل MiMo-V2.6-Distill-Qwen-9B (یک مدل کوچکتر که از تقطیر مسیرهای یادگیری تقویتی MiMo به دست آمده) است.
این امر موجب میشود تا رویکرد شیائومی چیزی بیش از یک انتشار سنتیِ وزنهای مدل باشد. گزارش فنی این شرکت دهها صفحه را به توضیح نحوه ایجاد محیط، ساخت ارزیابیگر، سیستمهای دفاعی در برابر فریب پاداش، زیرساخت غیرهمگام اجرای مسیرها و مکانیک ترکیب وظایف ایجنتها در یک اجرای آموزشی مشترک اختصاص داده است. شیائومی اعلام کرده که هدف از این کار، ارائه بخش عمدهای از فناوریهای پایهای به دیگر پژوهشگران است تا آنها نیز بتوانند این کار را تکرار کرده و توسعه دهند.
برای جامعه نرمافزارهای متنباز، این اقدام میتواند پیامدهایی مهمتر از این موضوع داشته باشد که مدل MiMo-Pro رتبه اول ارزیابی Artificial Analysis را برای چند هفته یا چند ماه در اختیار داشته باشد. اگر تیمهای خارجی بتوانند برخی از دستاوردهای یادگیری تقویتی شیائومی را در مدلهای کوچکتر بازآفرینی کنند، این انتشار میتواند طرحی عملی برای بهبود رفتار ایجنتها بدون نیاز به آموزش از پایه یک مدل تریلیون پارامتریِ جدید ارائه دهد.
چالش قدرتمند شیائومی از طریق پشته هوش مصنوعی یکپارچهاش
نادیده گرفتن این الگوی کلان دشوار به نظر میرسد. شیائومی از مدلهای پایه شروع کرد، ایجنتهای کدنویسی طولانیمدت را اضافه کرد، وارد توسعه مهارکنندههای سازگار شد و اکنون بخش عمدهای از زیرساخت یادگیری تقویتی را که این اجزا را به یکدیگر متصل میکند، در دسترس عموم قرار داده است.
این شرکت هنوز در تمامی بنچمارکها پیشتاز نیست و بسیاری از ارزیابیهای مربوط به ایجنتهایش همچنان توسط خود سازنده انجام میشوند. مدل یک تریلیون پارامتری Pro نیز با وجود اینکه در هر مرحله تولید توکن تنها بخشی از پارامترهایش فعال میشود، همچنان سیستم سنگینی برای میزبانی شخصی محسوب میشود.
اما این محدودیتها در کنار یک واقعیت جدید قرار میگیرند: شیائومی اکنون دارای بالاترین رتبه در شاخصهای ترکیبی هوشمندی Artificial Analysis برای مدلهای با وزن باز است؛ این شرکت یک مدل کوچکتر Flash دارد که در چندین کار ایجنتی به عملکرد نسخه Pro با قیمتی در حدود یک سوم نزدیک میشود؛ از استراتژی لایسنس باز بهره میبرد و مجموعه روبهرشدی از زیرساختهای آموزشی باز را ارائه کرده است.
بنابراین برای تیمهای هوش مصنوعی سازمانی، سؤال فوری این نیست که آیا MiMo-V2.6 از همه نظر بهتر از هر مدل انحصاری پیشگامی است یا خیر (که چنین نیست).
سؤال کاربردیتر این است که آیا یک مدل قابل دانلود که در پردازشهای مهم عملکرد قابل قبولی ارائه میدهد — در حالی که هزینه آن ۰.۸۷ دلار به ازای هر یک میلیون توکن خروجی برای نسخه Pro یا تنها ۰.۲۸ دلار برای نسخه Flash است — میتواند جایگزین مدلهای انحصاری گرانتر برای حداقل بخشی از وظایف ایجنتهای سازمانی شود؟
شیائومی با مدل MiMo-V2.6، دلیل بسیار قانعکنندهای به توسعهدهندگان داده است تا این ارزیابی را انجام دهند.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی

رکورد ۸۳۳ هزار دانلود ماهانه برای LEGAL-BERT؛ وقتی توسعهدهندهها قید مدلهای گرانقیمت را میزنند!
مدل زبانی تخصصی LEGAL-BERT با ثبت بیش از ۸۳۳ هزار دانلود در ماه روی پلتفرم هاگینگ فیس حسابی خبرساز شده است. این ابزار جمعوجور و تخصصی نشان میدهد که برای پردازش و تحلیل متون حقوقی، حتماً نیازی به مدلهای غولپیکر و پرهزینه ندارید و گزینههای بهینه همچنان در اوج هستند.

جاسوسی هوش مصنوعی در محل کار؛ کارمندان میگویند کارفرماها باید قانوناً مچگیریهایشان را لو بدهند!
نظرسنجیهای تازه نشان میدهد که بیشتر کارمندان حس میکنند مدیرانشان با ابزارهای هوش مصنوعی تمام حرکات آنها را زیر نظر گرفتهاند. حالا بیش از ۸۰ درصد شاغلان خواستار تصویب قانونی شدهاند که شرکتها را مجبور کند هرگونه مچگیری و نظارت هوش مصنوعی در محیط کار را رسماً اعلام کنند.

گزارش داغ مایکروسافت از نفوذ جهانی هوش مصنوعی؛ امارات در صدر و رتبه عجیب آمریکا!
مایکروسافت در تازهترین گزارش خود از ضریب نفوذ هوش مصنوعی در جهان پرده برداشت؛ آماری شگفتانگیز که نشان میدهد امارات و سنگاپور با فاصلهای خیرهکننده پیشتاز دنیا هستند و در مقابل، آمریکا در رتبه ۲۱ جا مانده است. همچنین الگوی استفاده از هوش مصنوعی میان کشورهای غربی و کشورهای در حال توسعه، از تفاوتی عمیق میان کاربردهای روزمره و آموزش پرده برمیدارد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.