رونمایی الف آلفا از مدل استدلال متنباز Kolibri-1؛ پردازش فوقسریع با حافظه ۱ میلیون توکنی!
استارتاپ آلمانی الف آلفا (Aleph Alpha) از مدل استدلال متنباز جدید خود به نام Kolibri-1 رونمایی کرد که با تمرکز ویژه روی زبانهای آلمانی و انگلیسی توسعه یافته است. این مدل با معماری کارشناسان ترکیبی (MoE) و مجموعاً ۷۸ میلیارد پارامتر، تنها ۳.۵ میلیارد پارامتر فعال در هر توکن مصرف میکند و از پردازش متون فوقطولانی تا سقف ۱ میلیون توکن پشتیبانی به عمل میآورد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- استارتاپ آلمانی الف آلفا از مدل استدلال متنباز Kolibri-1 رونمایی کرد؛ مدلی با ۷۸ میلیارد پارامتر که به لطف معماری خلوت و مدرن MoE، برای هر توکن فقط ۳.۴۶ میلیارد پارامتر رو درگیر میکنه تا پردازش بهینهتری داشته باشه.
- این مدل قدرتمند که روی آلمانی و انگلیسی تمرکز داره، حافظه و پنجره زمینه بومی ۲۶۲ هزار توکنی داره و توی تستها نشون داده میتونه تا سقف شگفتانگیز ۱ میلیون توکن رو هم بدون دردسر مدیریت کنه.
- نکته جذاب ماجرا انتشار مدل با لایسنس آزاد Apache 2.0 هست؛ یعنی شرکتها و برنامهنویسها میتونن با خیال راحت اون رو روی سرورهای اختصاصی خودشون بالا بیارن و کنترل دادهها رو کامل دست بگیرن.
عرضه مدل استدلال Kolibri-1 توسط الف آلفا با پردازش بهینه و پنجره ۱ میلیون توکنی
استارتاپ آلمانی الف آلفا (Aleph Alpha) مستقر در هایدلبرگ، از صفحه مدل Kolibri-1 در هاگینگفیس رونمایی کرد؛ یک مدل استدلال با وزنهای باز بر پایه معماری کارشناسان ترکیبی (MoE) که برای زبانهای آلمانی و انگلیسی بهینهسازی شده است. این مدل در مجموع ۷۸.۱ میلیارد پارامتر دارد، اما به لطف ساختار هوشمندانهاش برای پردازش هر توکن فقط حدود ۳.۴۶ میلیارد پارامتر را فعال میکند. همچنین این مدل از استدلال قابلتنظیم و فراخوانی ابزارها (Tool Calling) پشتیبانی کرده و با لایسنس کاملاً آزاد Apache 2.0 برای میزبانی و استقرار روی سرورهای اختصاصی عرضه شده است.
مدل Kolibri-1 دقیقاً برای تیمها و سازمانهایی طراحی شده که به استدلال قوی به زبان آلمانی، بازیابی اطلاعات در متون فوقالعاده طولانی (Long-context) و کنترل کامل روی محل ذخیره پرامپتها و وزنهای مدل نیاز دارند. معماری خلوت (Sparse) این مدل بار پردازشی هر توکن را به شکل چشمگیری کاهش میدهد؛ هرچند که برای نگهداری کل مجموعه وزنهای آن، همچنان به حدود ۷۸ گیگابایت فضای ذخیرهسازی نیاز خواهید داشت.
پردازش خلوت، حافظه فشرده
مشخصات فنی | مدل Kolibri-1 |
|---|---|
تعداد کل پارامترها | ۷۸,۱۰۳,۰۷۴,۵۶۰ |
پارامترهای فعال در هر توکن | ۳,۴۵۷,۵۷۳,۱۲۰ |
زبانهای پشتیبانیشده | آلمانی و انگلیسی |
لایههای ترنسفورمر | ۵۰ لایه |
کارشناسان (Experts) | ۳۸۴ کارشناس مسیریابیشده در هر لایه (انتخاب ۶ کارشناس به ازای هر توکن به همراه ۱ کارشناس مشترک) |
پنجره زمینه بومی | ۲۶۲,۱۴۴ توکن |
پنجره توسعهیافته و اعتبارسنجیشده | تا ۱,۰۴۸,۵۷۶ توکن |
فرمت وزنها | FP8 به همراه بخشهای منتخب در قالب bfloat16 |
مجوز (License) | Apache 2.0 |
نسبت ۲۲.۶ به ۱ میان پارامترهای کل و پارامترهای فعال، علت رفتار سختافزاری خاص این مدل را به خوبی توجیه میکند. هر توکن فقط کسری از وزنهای کارشناسان را به کار میگیرد که این موضوع فشار محاسباتی را حسابی مهار میکند؛ با این حال، سرور ارائهدهنده در زمان استنتاج همچنان باید به کل شبکه دسترسی کامل داشته باشد.
در هر بلوک ترنسفورمر یک لایه پیشخوران (Feed-forward) بر پایه کارشناسان ترکیبی تعبیه شده است. سازوکار توجه (Attention) نیز از الگوی ترکیبی ۴ به ۱ بین لایههای پنجره متحرک (Sliding-window) و لایههای توجه کامل پیروی میکند؛ به این شکل که بیشتر لایهها فقط ۵۱۲ توکن قبلی را بررسی میکنند، در حالی که لایههای سراسری (Global) دورهای میتوانند از کل پنجره زمینه بهره ببرند. این معماری هوشمندانه حجم عملیات توجه را در بخش اعظم مدل محدود نگه میدارد، اما همزمان مسیرهای انتقال اطلاعات در فواصل طولانی را دستنخورده حفظ میکند.
پردازش متون فوقطولانی بدون نیاز به مقیاسپذیری پوزیشنها
تیم الف آلفا آموزش این مدل را ابتدا روی پنجره ۱۶,۳۸۴ توکنی آغاز کرد، سپس فرآیند یادگیری را در ۶۵,۵۳۶ توکن ادامه داد و نهایتاً زمینه بومی مدل را به ۲۶۲,۱۴۴ توکن رساند. این شرکت همچنین گزارش داده که تستهای کیفیت و سرویسدهی مدل را در پنجره شگفتانگیز ۱,۰۴۸,۵۷۶ توکنی (بیش از یک میلیون توکن) با موفقیت پشت سر گذاشته است.
بر اساس مستندات رسمی مدل، کدگذاری موقعیت (Positional Encoding) صرفاً در لایههای توجه پنجره متحرک حضور دارد. این ساختار فنی هوشمند به الف آلفا اجازه داده تا بدون نیاز به روشهای دستکاری یا مقیاسپذیری مانند YaRN یا RoPE، پنجره زمینه را به شکل خارقالعادهای گسترش دهد. البته در عمل، محدودیتهای نهایی درخواستها به پیکربندی فریمورک vLLM، اندازه بچ (Batch Size) و حافظه رم موجود برای کَش کلید-مقدار (KV Cache) وابسته خواهد بود.
وزنهای مدل در قالب بلوکهای ۱۲۸ در ۱۲۸ از فرمت بهینه FP8 بهره میبرند و اکتیویشنها نیز به شکل پویا کوانتیزه میشوند. با این حال بخشهای حساسی چون امبدینگها، لایههای نرمالسازی، هد نهایی مدل زبانی و روتر کارشناسان همچنان در فرمت bfloat16 حفظ شدهاند تا دقت مدل افت نکند. در ارزیابیهای فنی الف آلفا، این مدل همراه با کش کلید-مقدار تحت فرمت FP8 مورد سنجش قرار گرفته است.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
پایتورچ و رد هت رکورد زدند: شتاب ۱۸ درصدی استنتاج در پردازندههای H100 با Helion
پایتورچ و رد هت با توسعه یک بکاند خطی مبتنی بر فریمورک Helion برای موتور vLLM، جهش چشمگیری در سرعت پردازش مدلهای هوش مصنوعی رقم زدند. این سیستم نوآورانه با تنظیم خودکار کرنلها، موفق شده سرعت ضرب ماتریسی در پردازندههای H100 انویدیا را تا ۱۷.۸ درصد نسبت به کتابخانههای مطرح ارتقا دهد. این بهینهسازی بهویژه در سناریوهای تولید سریع متن در مدلهای زبانی، بازدهی سرورهای هوش مصنوعی را به شکل محسوسی افزایش میدهد.
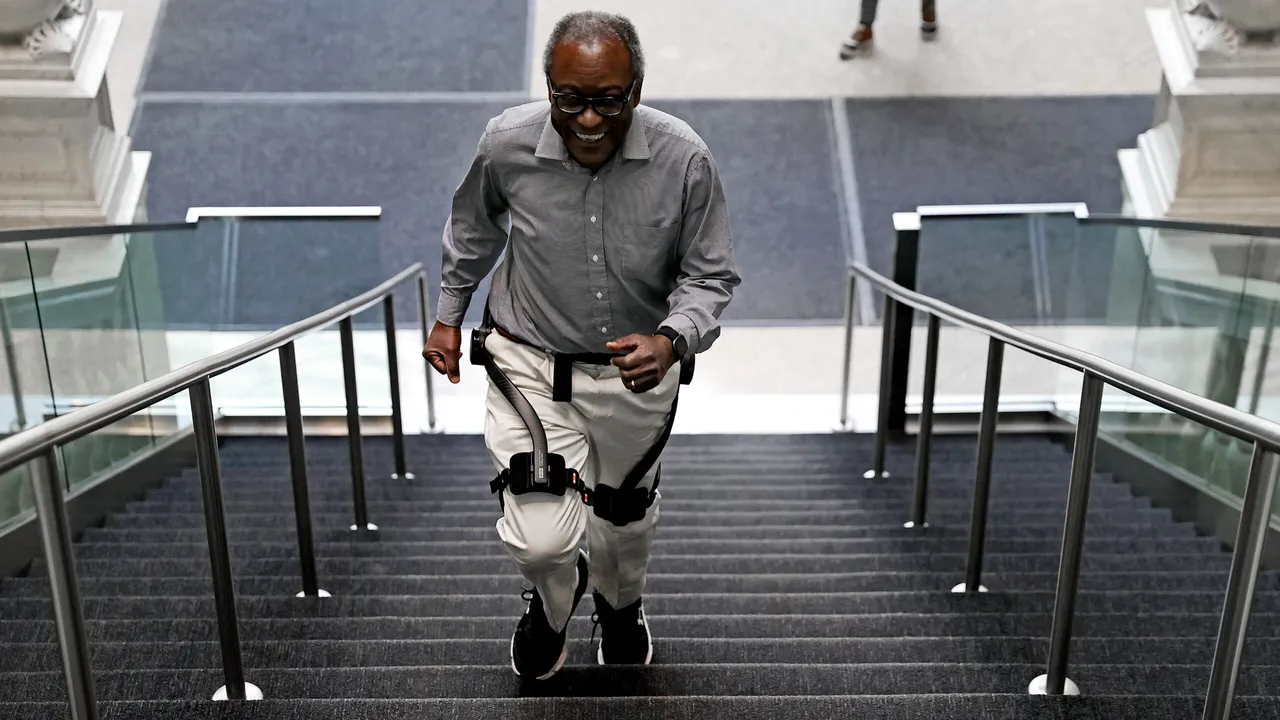
ورود به عصر اسکلتهای بیرونی روباتیک؛ گجتهایی که قدرت بدنی انسان را متحول میکنند
اسکلتهای بیرونی روباتیک دیگر فقط به فیلمهای علمیتخیلی تعلق ندارند و حالا از خط مقدم نبرد و انبارهای بزرگ تا عملیاتهای سخت امداد و نجات به کار گرفته میشوند. این گجتهای پیشرفته با تقویت توان عضلانی، خستگی را به حداقل میرسانند و به کاربران امکان میدهند کارهای سنگین فیزیکی را بسیار سریعتر، ایمنتر و با کارایی بالاتر انجام دهند.
رد هت حجم مدل ۳۰ میلیاردی نموترون انویدیا را نصف کرد: اجرای آسانتر ایجنتها روی یک کارت گرافیک!
تیم هوش مصنوعی رد هت با تبدیل وزنهای مدل ۳۰ میلیارد پارامتری Nemotron انویدیا به فرمت FP8، ردپای حافظه آن را به نصف رسانده است. این دستاورد فنی استقرار این ایجنت پیشرفته را روی یک کارت گرافیک ممکن کرده و تا الان با استقبال چشمگیر بیش از ۷۸۰ هزار دانلود در هاگینگ فیس روبهرو شده است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.