رد هت حجم مدل ۳۰ میلیاردی نموترون انویدیا را نصف کرد: اجرای آسانتر ایجنتها روی یک کارت گرافیک!
تیم هوش مصنوعی رد هت با تبدیل وزنهای مدل ۳۰ میلیارد پارامتری Nemotron انویدیا به فرمت FP8، ردپای حافظه آن را به نصف رسانده است. این دستاورد فنی استقرار این ایجنت پیشرفته را روی یک کارت گرافیک ممکن کرده و تا الان با استقبال چشمگیر بیش از ۷۸۰ هزار دانلود در هاگینگ فیس روبهرو شده است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- تیم هوش مصنوعی رد هت با فشردهسازی و تبدیل وزنهای مدل ۳۰ میلیاردی Nemotron انویدیا به فرمت FP8، حجم اون رو تقریباً نصف کرده تا بشه این ایجنت رو حتی روی یک شتابدهنده گرافیکی اجرا کرد.
- استقبال توسعهدهندهها از این نسخه جدید فوقالعاده بوده و تا الان بیش از ۷۸۰ هزار بار روی هاگینگ فیس دانلود شده که نشون میده جامعه هوش مصنوعی چقدر دنبال مدلهای سبکتره.
- البته حواستون باشه که نصف شدن حجم فایلها به معنی دو برابر شدن سرعت نهایی نیست؛ چون بخشهای حساس مدل دستنخورده موندن، اما سقف کارایی روی پردازندههای هاپر و بلکول حسابی بالا رفته.
رد هت حجم مدل Nemotron 3.5 Lightning انویدیا را با FP8 نصف کرد
تیم هوش مصنوعی رد هت (Red Hat AI) یک چکپوینت کوانتیزهشده با فرمت FP8 از مدل Nemotron شرکت انویدیا منتشر کرده است. تبدیل وزنها و فعالسازهای منتخب از فرمت BF16 به FP8 فضای ذخیرهسازی آنها را تقریباً به نصف کاهش میدهد و استقرار این مدل ایجنت ۳۰ میلیارد پارامتری را روی یک کارت گرافیک یا شتابدهنده واحد به مراتب آسانتر میکند.
در پلتفرم هاگینگ فیس (Hugging Face) تا لحظه انتشار این خبر بیش از ۷۸۰ هزار بار دانلود برای این چکپوینت ثبت شده است. هرچند این آمار نشاندهنده تعداد دفعات دانلود فایلهاست و نه لزوماً تعداد کاربران یکتا یا استفاده مستقیم در محیط عملیاتی، اما علاقه اولیه و چشمگیر توسعهدهندگان به نسخههای کممصرفتر و سبکتر را به خوبی نشان میدهد.
نصف شدن حجم وزنها؛ دستاوردی جذاب اما با پیششرطهای فنی
تیم رد هت این چکپوینت را با استفاده از ابزار LLM Compressor توسعه داده است؛ به این صورت که کوانتیزاسیون ایستا بر پایه هر تنسور (Per-Tensor FP8) روی وزنها و فعالسازهای عملگرهای خطیِ پشتیبانیشده پیاده شده است. فرمت FP8 هر مقدار کوانتیزهشده را تنها در ۸ بیت ذخیره میکند، در حالی که در فرمت BF16 برای هر مقدار به ۱۶ بیت فضا نیاز است.
برای حفظ حداکثر دقت، چندین بخش حساس به دقت بالا دستنخورده باقی مانده و فشرده نشدهاند؛ از جمله لایههای conv1d، امبدینگها، پروجکشنهای نهفته (Latent Projections)، گیتهای معماری متخصصان ترکیبی (Mixture of Experts)، لایههای پیشبینی چندتوکنی، لایه نرمالسازی نهایی و هِد اصلی مدل زبانی (LM Head). فرآیند کالیبراسیون نیز با استفاده از ۵۱۲ نمونه متن از مجموعه UltraChat و با طول ۲۰۴۸ توکن برای هر نمونه انجام شده است.
صرفهجویی حاصل از این روش اساساً روی تنسورهای کوانتیزهشده اعمال میشود. از آنجا که حافظه کلی در زمان اجرا شامل پارامترهای فشردهنشده، فعالسازها، وضعیتهای مامبا (Mamba State)، حافظه کش کلید-مقدار توجه (KV Cache) و فضای اختصاصیافته برای کتابخانه vLLM نیز میشود، کل مصرف حافظه کارت گرافیک (VRAM) در بسیاری از پیکربندیهای استقرار، اندکی کمتر از ۵۰ درصد کاهش پیدا میکند.
پردازندههای گرافیکی معماری هاپر (Hopper) و بلکول (Blackwell) میتوانند ضرب ماتریسی در فرمت FP8 را از طریق هستههای تانسور اختصاصی خود با نهایت سرعت اجرا کنند. با این حال، توان عملیاتی سرتاسری مدل به فاکتورهایی مثل اندازه بچ (Batch Size)، طول رشته ورودی، پهنای باند حافظه، مسیریابی متخصصان در مدل و سهم عملگرهای فشردهنشده بستگی دارد؛ بنابراین استفاده از فرمت FP8 سقف کارایی سختافزار را به شکل چشمگیری افزایش میدهد، اما لزوماً به این معنی نیست که تعداد پاسخها در هر ثانیه دقیقاً دو برابر خواهد شد.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
پایتورچ و رد هت رکورد زدند: شتاب ۱۸ درصدی استنتاج در پردازندههای H100 با Helion
پایتورچ و رد هت با توسعه یک بکاند خطی مبتنی بر فریمورک Helion برای موتور vLLM، جهش چشمگیری در سرعت پردازش مدلهای هوش مصنوعی رقم زدند. این سیستم نوآورانه با تنظیم خودکار کرنلها، موفق شده سرعت ضرب ماتریسی در پردازندههای H100 انویدیا را تا ۱۷.۸ درصد نسبت به کتابخانههای مطرح ارتقا دهد. این بهینهسازی بهویژه در سناریوهای تولید سریع متن در مدلهای زبانی، بازدهی سرورهای هوش مصنوعی را به شکل محسوسی افزایش میدهد.
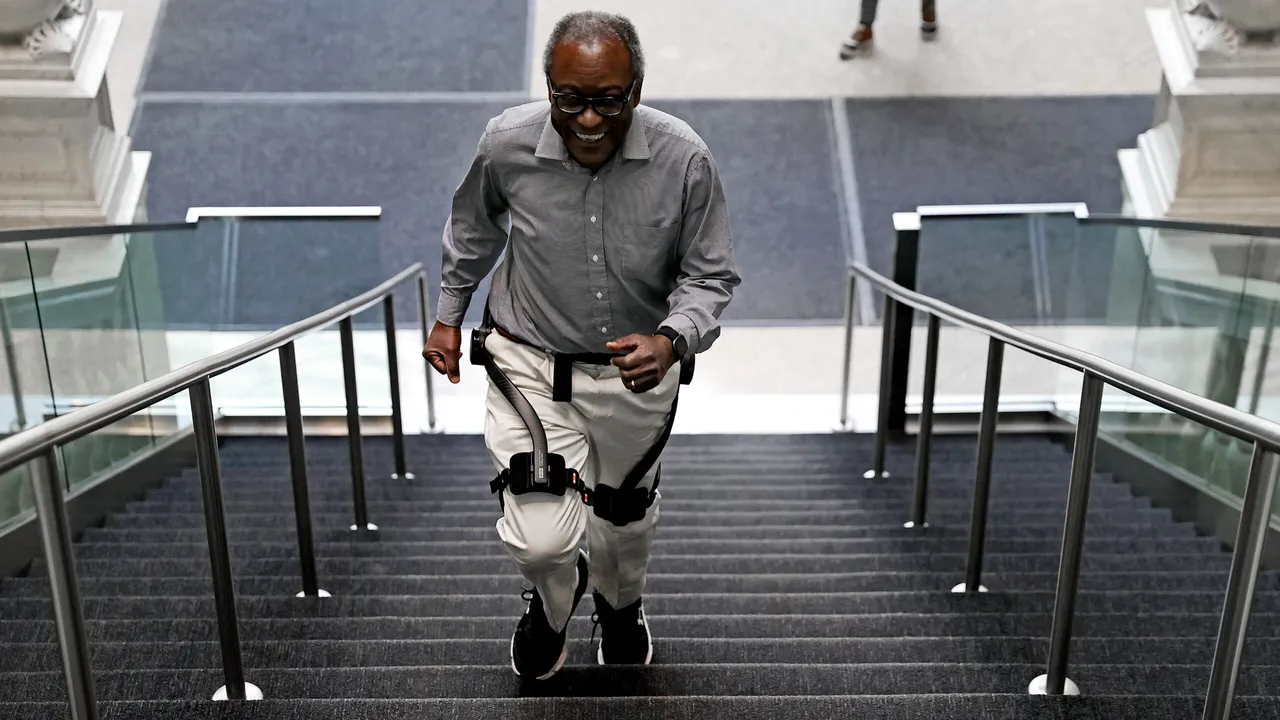
ورود به عصر اسکلتهای بیرونی روباتیک؛ گجتهایی که قدرت بدنی انسان را متحول میکنند
اسکلتهای بیرونی روباتیک دیگر فقط به فیلمهای علمیتخیلی تعلق ندارند و حالا از خط مقدم نبرد و انبارهای بزرگ تا عملیاتهای سخت امداد و نجات به کار گرفته میشوند. این گجتهای پیشرفته با تقویت توان عضلانی، خستگی را به حداقل میرسانند و به کاربران امکان میدهند کارهای سنگین فیزیکی را بسیار سریعتر، ایمنتر و با کارایی بالاتر انجام دهند.
رونمایی الف آلفا از مدل استدلال متنباز Kolibri-1؛ پردازش فوقسریع با حافظه ۱ میلیون توکنی!
استارتاپ آلمانی الف آلفا (Aleph Alpha) از مدل استدلال متنباز جدید خود به نام Kolibri-1 رونمایی کرد که با تمرکز ویژه روی زبانهای آلمانی و انگلیسی توسعه یافته است. این مدل با معماری کارشناسان ترکیبی (MoE) و مجموعاً ۷۸ میلیارد پارامتر، تنها ۳.۵ میلیارد پارامتر فعال در هر توکن مصرف میکند و از پردازش متون فوقطولانی تا سقف ۱ میلیون توکن پشتیبانی به عمل میآورد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.