پایتورچ و رد هت رکورد زدند: شتاب ۱۸ درصدی استنتاج در پردازندههای H100 با Helion
پایتورچ و رد هت با توسعه یک بکاند خطی مبتنی بر فریمورک Helion برای موتور vLLM، جهش چشمگیری در سرعت پردازش مدلهای هوش مصنوعی رقم زدند. این سیستم نوآورانه با تنظیم خودکار کرنلها، موفق شده سرعت ضرب ماتریسی در پردازندههای H100 انویدیا را تا ۱۷.۸ درصد نسبت به کتابخانههای مطرح ارتقا دهد. این بهینهسازی بهویژه در سناریوهای تولید سریع متن در مدلهای زبانی، بازدهی سرورهای هوش مصنوعی را به شکل محسوسی افزایش میدهد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- همکاری پایتورچ و رد هت منجر به ساخت یک بکاند جدید بر پایه Helion برای موتور vLLM شد که محاسبات ضرب ماتریسی کوانتایزشده را حسابی متحول کرده است.
- بنچمارکهای رسمی روی تراشه قدرتمند H100 انویدیا نشان میدهد این فناوری جدید بین ۱۱ تا ۱۷.۸ درصد سریعتر از غولهایی مثل CUTLASS، DeepGEMM و FlashInfer عمل میکند.
- با استفاده از قابلیت اتوتیونینگ (تنظیم خودکار) و جستجوی هوشمند به کمک هوش مصنوعی، نیازی به نوشتن دستی و طاقتفرسای کدهای جداگانه برای ابعاد مختلف ماتریسها نخواهد بود.
شتاب چشمگیر موتور vLLM در پردازندههای هاپر با کرنلهای اتوتیون Helion
تیمهای پایتورچ (PyTorch) و رد هت (Red Hat) از یک بکاند خطی جدید مبتنی بر Helion برای موتور محبوب vLLM رونمایی کردند. آزمایشها روی پردازنده گرافیکی قدرتمند NVIDIA H100 نشان میدهد کرنلهای سطحبالای ضرب ماتریسی کوانتایزشده در این سیستم، شتاب میانگین هندسی چشمگیر ۱۱.۰ تا ۱۷.۸ درصدی را نسبت به کتابخانههای مطرح CUTLASS، DeepGEMM و FlashInfer به ثبت رساندهاند. این یکپارچهسازی، فرآیند دشوار انتخاب کرنل مناسب برای ابعاد مختلف ماتریس را به یک اتوتیونر (تنظیمکننده خودکار) میسپارد و دیگر نیازی به کدنویسی دستی قوانین متعدد برای هر حالت خاص نیست.
این نسخه منتشرشده بهطور ویژه روی استنتاج توکنهای کوچک در پردازندههای گرافیکی نسل هاپر (NVIDIA Hopper) تمرکز دارد. این سیستم از سه فرمت کوانتایزیشن ۸ بیتی پشتیبانی میکند و برای بارهای کاری سنگینتر، از کرنلهای فعلی vLLM به عنوان جایگزین پشتیبان استفاده مینماید. سورسکد، اسکریپتهای تنظیم و پیکربندیهای از پیش آمادهشده در فورک اختصاصی رد هت از vLLM در دسترس عموم قرار گرفته است.
اتوتیونینگ؛ خداحافظی با تنظیمات دستی و خستهکننده
موتور vLLM لایههای خطی مدلهای ترنسفورمر را از طریق یک بکاند پردازش میکند که محاسبات ضرب عمومی ماتریسها یا اصطلاحاً GEMM را بر عهده دارد. در GEMMهای کوانتایزشده، وزنها و اکتیویشنهای با دقت پایین در هم ضرب میشوند و سپس با اعمال ضرایب مقیاسگذاری (Scaling Factors)، دامنه عددی واقعی بازیابی میگردد. تاکنون vLLM اجرای این محاسبات را به کتابخانههای تخصصی نظیر CUTLASS، DeepGEMM و FlashInfer ارجاع میداد.
فریمورک Helion یک زبان اختصاصی دامنه کرنل (Kernel DSL) و تعبیهشده در پایتون است که بر پایه برنامهنویسی کاشیبندیشده (Tiled) برای پردازندههای گرافیکی توسعه یافته است. اتوتیونر پیش از اجرا (Ahead-of-Time) در این فریمورک، چیدمانهای حافظه، زمانبندیهای اجرا، اندازههای کاشی و گزینههای مختلف الگوریتمی را برای هر ابعاد ماتریسی به طور خودکار بررسی میکند. سپس بهترین پیکربندی انتخابشده ذخیره میشود تا در زمان اجرای واقعی استنتاج، بدون اتلاف وقت مجدداً استفاده شود.
یکپارچهسازی اولیه با vLLM از فرمتهای زیر پشتیبانی میکند:
فرمت | مقیاسگذاری اکتیویشن | مقیاسگذاری وزن |
|---|---|---|
FP8_Dynamic | به ازای هر توکن | به ازای هر کانال |
W8A8_INT8 | به ازای هر توکن | به ازای هر کانال |
Block_FP8 | بلوکهای ۱ × ۱۲۸ | بلوکهای ۱۲۸ × ۱۲۸ |
البته رابط لایه خطی جامعتر vLLM از فرمتهایی نظیر INT4 و NVFP4 نیز پشتیبانی میکند، اما این فرمتها در نسخه فعلی Helion گنجانده نشدهاند.
یک کرنل واحد و سه سناریوی اجرایی هوشمند
کارایی محاسبات GEMM روی پردازنده گرافیکی به شدت به ابعاد ماتریسها وابسته است. در یک عملیات ضرب ماتریسی که به صورت C = A @ B نوشته میشود، متغیر M معمولاً بیانگر تعداد توکنهایی است که همزمان پردازش میشوند، N عرض خروجی را نشان میدهد و K بُعد کاهشیافته (Reduction Dimension) است. بارهای کاری در مرحله دیکود (تولید توکن به توکن) معمولاً مقدار M بسیار پایینی دارند؛ در نتیجه، کار موازی کافی برای زمانبندیهای سنتی GEMM باقی نمیماند و عملکرد افت میکند.
پیادهسازی Helion سه برنامه اجرایی مجزا را تنها در قالب یک تعریف کرنل واحد پیاده کرده است:
برنامه اجرا | نحوه عملکرد | شرایط ایدهآل استفاده |
|---|---|---|
استاندارد (Standard) | ضرب اصلی ماتریس را به صورت مستقیم کاشیبندی میکند. | ابعادی با حجم کار کافی در ابعاد M و N. |
تقسیم بُعد کا (Split-K) | بُعد K را بین بلوکهای ریسه تقسیم کرده و نتایج جزئی را ادغام میکند. | ابعادی با موازیسازی محدود در ابعاد خروجی. |
جابهجایی ماتریسها (Swap-AB) | عبارت (B.T @ A.T).T را محاسبه میکند تا چیدمان کاشی بهینهتری حاصل شود. | ماتریسهایی با مقدار M کوچک، بهویژه در پردازشهای سنگین مرحله دیکود. |
بکاندهای فعلی معمولاً این سناریوها را جداگانه کدنویسی کرده و با قوانین تجربی و ثابت (Heuristics) بین آنها تصمیمگیری میکنند. به عنوان مثال، مسیر فعلی Block_FP8 در موتور vLLM زمانی که در پردازندههای هاپر مقدار M کمتر از ۳۲ باشد، حالت Swap-AB را برمیگزیند.
فریمورک Helion این سناریوها را از طریق تابع hl.register_tunable در دسترس قرار میدهد. در کرنل مرجع، پارامتر split_k میتواند توانهایی از عدد ۲ تا مقدار ۲۵۶ را بپذیرد، در حالی که swap_ab یک گزینه بولی (True/False) است. بدین ترتیب، فرآیند تنظیم آفلاین گزینههای مختلف را بنچمارک کرده و سریعترین پیکربندی برنده را برای هر ابعاد خاص ثبت مینماید.
مسیر اختصاصی Helion برای ورودیهای کوچک
اگر اجرای محاسبات خارج از فرآیند بازپخش گرافهای کودا (CUDA Graph Replay) انجام شود، فراخوانی و مدیریت کرنل در Helion میتواند سربار پردازشی زیادی به پردازنده اصلی (CPU) تحمیل کرده و سود حاصل از شتاب گرافیکی را خنثی کند. قابلیت CUDA Graphs زنجیرهای از عملیات گرافیکی را ثبت کرده و بدون درگیر کردن مکرر CPU آنها را با سرعت بالا بازپخش میکند؛ این قابلیت به ویژه برای شکلهای پایدار استنتاج ایدهآل است.
به همین دلیل، این بکاند از یک سازوکار توزیع ترکیبی (Hybrid Dispatch) هوشمند بهره میبرد:
- تعداد توکنها تا سقف
max_helion_sizeدر طول بازپخش گرافهای کودا از موتور Helion استفاده میکنند (در پیکربندی پیشفرض، این آستانه روی عدد ۳۲ تنظیم شده است). - ابعاد بزرگتر همچنان از مسیر پیشفرض کتابخانههای CUTLASS یا DeepGEMM پردازش میشوند.
این طراحی هوشمندانه، تمرکز بهینهسازی را روی استنتاج توکنهای کوچک در فاز دیکود متمرکز میکند و تعداد پیکربندیهایی را که باید تولید، اعتبارسنجی و توزیع شوند به حداقل میرساند. کتابخانههای تثبیتشده CUTLASS و DeepGEMM نیز همچنان برای بارهای کاری فراتر از این آستانه در مدار باقی میمانند.
از سطح کرنل تا کل سرور: جهش عملکرد پردازندههای H100
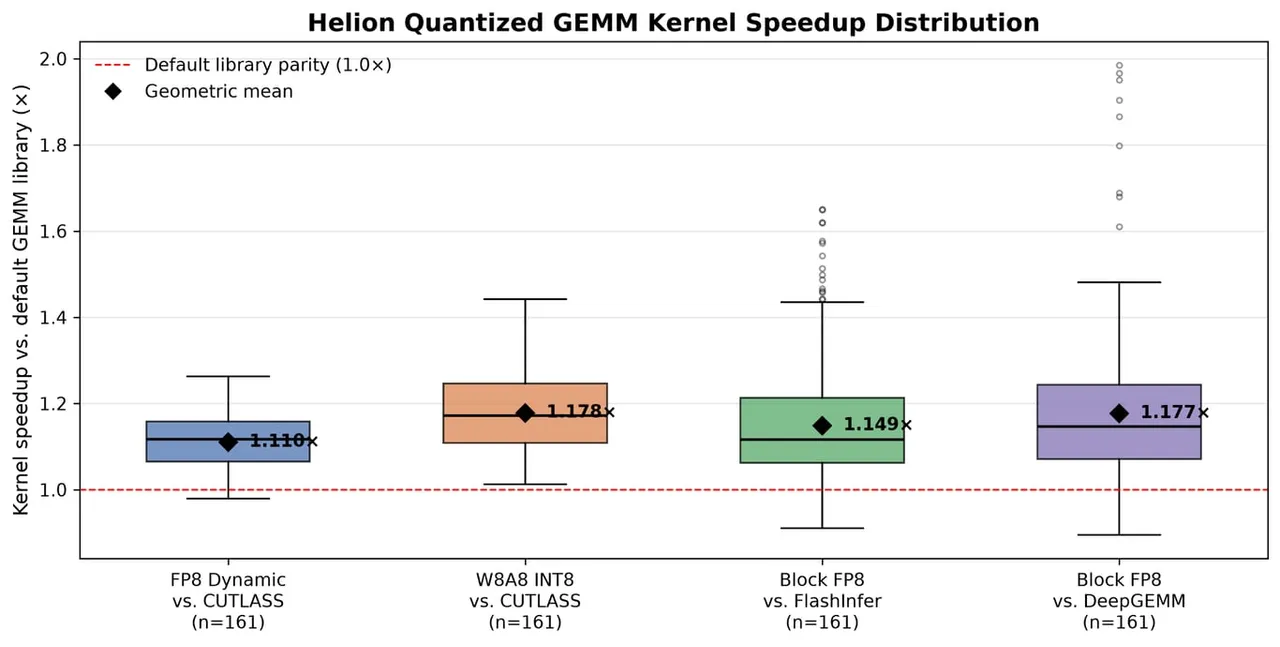
بنچمارکهای سطح کرنل روی کارت گرافیک قدرتمند NVIDIA H100 مجهز به ۸۰ گیگابایت حافظه فوقسریع HBM3 به اجرا درآمدند. مدلهای ارزیابیشده شامل خانواده Qwen3 از ۱.۷ تا ۳۲ میلیارد پارامتر و مدل Qwen3.8-27B بودند. فریمورک Helion به بهبودهای میانگین هندسی زیر در سرعت دست یافت:
فرمت | کتابخانه مبنا | ضریب شتاب | رشد نسبی |
|---|---|---|---|
FP8_Dynamic | CUTLASS | ۱.۱۱۰ برابر | ۱۱.۰٪ |
W8A8_INT8 | CUTLASS | ۱.۱۷۸ برابر | ۱۷.۸٪ |
Block_FP8 | FlashInfer | ۱.۱۴۹ برابر | ۱۴.۹٪ |
Block_FP8 | DeepGEMM | ۱.۱۷۷ برابر | ۱۷.۷٪ |
در آزمایشهای سرویسدهی واقعی (End-to-End) سرور vLLM با استفاده از دیتاست پرکاربرد ShareGPT، بکاند Helion توانست نرخ پردازش کل (Throughput) را در تمامی مدلها و فرمتهای کوانتایزیشن ارزیابیشده ارتقا دهد و در برخی سناریوها حتی رشدهای بالای ۱۰ درصد را به ثبت برساند.
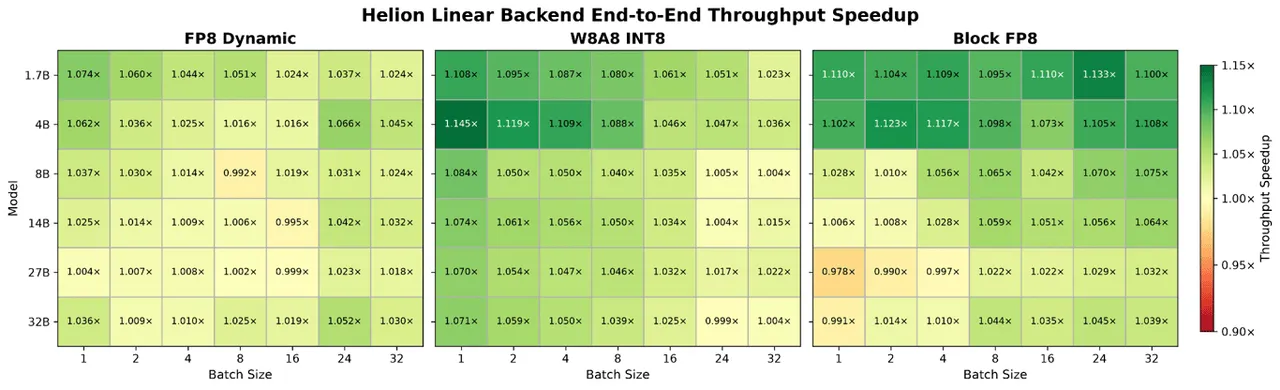
شواهد منتشرشده در حال حاضر یک مدل کارت گرافیک، مدلهای منتخب Qwen و سه فرمت کوانتایزیشن را شامل میشود. ارزیابی عملکرد روی سایر کارتهای نسل هاپر، معماریهای مختلف مدل، توزیع درخواستها و تنظیمات توازی تانسوری (Tensor Parallelism) نیازمند آزمایشهای مستقل دیگری خواهد بود.
انتقال بار پردازشی به فاز آفلاین برای حداکثر سرعت
اگرچه تنظیم خودکار دقیق زحمت برنامهنویسی دستی کرنلها را از دوش توسعهدهندگان برمیدارد، اما چالشها و هزینههای عملیاتی خاص خود را به همراه دارد:
چالش عملیاتی | پیامد | راهکار برطرفسازی |
|---|---|---|
زمان تنظیم | جستجوی دقیق برای ابعاد مختلف ماتریس میتواند ساعتها طول بکشد. | اجرای فرآیند اتوتیونینگ به صورت آفلاین و ذخیره فایلهای آماده برای استفاده مجدد. |
تأخیر راهاندازی اولیه | ضبط گراف کودا در هنگام اجرای اولیه vLLM میتواند کامپایل درلحظه (JIT) هلیون را فعال کند. | ذخیرهسازی و کش کردن فایلهای کامپایلشده برای راهاندازی بسیار سریع در دفعات بعدی. |
نگهداری پیکربندیها | فایلهای از پیش تنظیمشده حجیم هستند و اعتبارسنجی همه آنها دشوار است. | محدود کردن فایلهای همراه به مدلهای رایج و اجرای تنظیم اختصاصی برای سرورهای خاص. |
توسعهدهندگان برای کوتاه کردن این زمان، از روش نوآورانه تنظیم خودکار با هدایت مدلهای زبانی استفاده کردهاند. در ساختار LLMSeededLFBOTreeSearch، مدل هوش مصنوعی Claude Opus 4.8 گزینههای بهینه اولیه را پیشنهاد میدهد و سپس یک الگوریتم جستجوی درختی عددی، آن پیکربندیها را صیقل داده و نهایی میکند.
نحوه راهاندازی با فورک اختصاصی رد هت
کدهای اجرایی، پیکربندیهای آماده و ابزارهای اتوتیونینگ همگی در فورک رد هت در گیتهاب منتشر شدهاند. در این مخزن، با افزودن پرچم دستور --linear-backend helion میتوانید این بکاند پرسرعت را فعال کنید:
vllm serve \\
    --model "$MODEL" \\
    --max-num-seqs 32 \\
    --tensor-parallel-size 1 \\
    --no-enable-prefix-caching \\
    --linear-backend helion
سایر گزینهها در این دستور، حداکثر تعداد توالیها را مشخص میکنند، یک پردازشگر موازی تانسوری اختصاص میدهند و کش کردن پیشوندها را غیرفعال میسازند. این ساختار پیکربندی استاندارد گزارششده در آزمایشها را نشان میدهد که پرچم آخر آن، فعالکننده بکاند جدید است.
مدلهایی که تنظیمات آماده آنها در بسته وجود ندارد، نیازمند یک بار اجرای فرآیند تنظیم آفلاین برای ابعاد ماتریسی خود خواهند بود. همچنین برای ارزیابی در محیط واقعی عملیاتی (Production)، باید مواردی مثل زمان کامپایل در اولین اجرا، دوام حافظه کش، نحوه دستهبندی درخواستها (Batching) و احتمال افت بازدهی در لایههای بالاتر نرمافزار را در نظر گرفت.
شرطبندی روی سازگاری و انعطافپذیری آینده
فریمورک Helion بهینهسازی را از تودهای از کرنلهای مجزا و قوانین شکننده دستی، به یک تعریف کرنل بومی در پایتورچ همراه با فرآیند جستجوی خودکار تبدیل کرده است. البته نسخه فعلی vLLM عمداً بر دامنهای مشخص متمرکز مانده و کارتهای هاپر، سه فرمت کوانتایزیشن و بارهای کاری با توکنهای کوچک در CUDA Graph را پوشش میدهد.
تحقیقات اولیه با استفاده از بکاند CuteDSL در هلیون، حتی نشاندهنده عملکرد رقابتی عالی در محاسبات ضرب ماتریسی پردازندههای نسل بعدی NVIDIA Blackwell است. علاوه بر این، توسعهدهندگان در حال کار روی پشتیبانی از پردازندههای گرافیکی AMD، پردازندههای TPU گوگل و ارائه یک بکاند ویژه برای معماریهای مدرن ترکیبی از متخصصان (Mixture of Experts یا MoE) هستند.
سرورهای مبتنی بر معماری هاپر با صرف کمی زمان برای تنظیم آفلاین، میتوانند به جهش ملموسی در سرعت مرحله تولید توکن (Decode) دست یابند. توزیعکننده ترکیبی، هلیون را هوشمندانه در محدوده توکنهای کوچک نگه میدارد؛ یعنی دقیقاً جایی که اتوتیونینگ بیشترین بازدهی را دارد. در عین حال، کتابخانههای قدرتمند قبلی همچنان ورودیهای بزرگتر را مدیریت میکنند تا مسیر آزمایش و پیادهسازی این نسل جدید از کرنلهای خودکار در سیستمهای استنتاج فعلی، کاملاً امن و مطمئن باشد.
مطالب مرتبط و پیشنهادی
ورود به عصر اسکلتهای بیرونی روباتیک؛ گجتهایی که قدرت بدنی انسان را متحول میکنند
اسکلتهای بیرونی روباتیک دیگر فقط به فیلمهای علمیتخیلی تعلق ندارند و حالا از خط مقدم نبرد و انبارهای بزرگ تا عملیاتهای سخت امداد و نجات به کار گرفته میشوند. این گجتهای پیشرفته با تقویت توان عضلانی، خستگی را به حداقل میرسانند و به کاربران امکان میدهند کارهای سنگین فیزیکی را بسیار سریعتر، ایمنتر و با کارایی بالاتر انجام دهند.
رونمایی الف آلفا از مدل استدلال متنباز Kolibri-1؛ پردازش فوقسریع با حافظه ۱ میلیون توکنی!
استارتاپ آلمانی الف آلفا (Aleph Alpha) از مدل استدلال متنباز جدید خود به نام Kolibri-1 رونمایی کرد که با تمرکز ویژه روی زبانهای آلمانی و انگلیسی توسعه یافته است. این مدل با معماری کارشناسان ترکیبی (MoE) و مجموعاً ۷۸ میلیارد پارامتر، تنها ۳.۵ میلیارد پارامتر فعال در هر توکن مصرف میکند و از پردازش متون فوقطولانی تا سقف ۱ میلیون توکن پشتیبانی به عمل میآورد.
رد هت حجم مدل ۳۰ میلیاردی نموترون انویدیا را نصف کرد: اجرای آسانتر ایجنتها روی یک کارت گرافیک!
تیم هوش مصنوعی رد هت با تبدیل وزنهای مدل ۳۰ میلیارد پارامتری Nemotron انویدیا به فرمت FP8، ردپای حافظه آن را به نصف رسانده است. این دستاورد فنی استقرار این ایجنت پیشرفته را روی یک کارت گرافیک ممکن کرده و تا الان با استقبال چشمگیر بیش از ۷۸۰ هزار دانلود در هاگینگ فیس روبهرو شده است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.