میسترال با معرفی خانواده مدلهای Voxtral 3 ساخت ایجنتهای صوتی بلادرنگ را یکپارچه کرد
میسترال با رونمایی از خانواده مدلهای Voxtral 3، قابلیتهای تبدیل گفتار، استدلال هوشمند و تولید صدا را در قالب یک پایپلاین یکپارچه گردهم آورد. این پکیج جدید همراه با یک کیت توسعه ایجنت صوتی ارائه شده است و امکان اجرای سریع و بدون تأخیر دستیارهای صوتی را روی سرورهای ابری یا محلی فراهم میکند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مجموعه Voxtral 3 شامل چهار مدل تخصصی برای تبدیل گفتار به متن و تولید صدا است و چرخه کامل شنیدن، پردازش و پاسخگویی صوتی را پوشش میدهد.
- کیت توسعه اختصاصی مبتنی بر LiveKit، مراحل شنیدن، تفکر توسط مدل زبانی و تولید پاسخ صوتی را با تأخیر کمتر از یک ثانیه به یکدیگر متصل میکند.
- میسترال امکان استفاده از این سیستم را علاوه بر رابط ابری، بهصورت استقرار محلی و برونخط روی زیرساخت اختصاصی سازمانها نیز فراهم کرده است.
شرکت میسترال از Voxtral 3 رونمایی کرد؛ خانوادهای جدید از مدلهای تبدیل گفتار به متن و متن به گفتار که همراه با یک کیت توسعه نرمافزار (SDK) اختصاصی برای ساخت ایجنتهای صوتی عرضه شده است. این SDK فرآیندهای شنیدن، استدلال، فراخوانی ابزارها و تولید گفتار را در یک چرخه پردازش جریانی (Streaming) و یکپارچه به هم متصل میکند. این پلتفرم از طریق API میزبانیشده در اروپا یا بهصورت استقرار مستقیم روی زیرساخت اختصاصی سازمانها در دسترس است و کنترل کاملی بر محل پردازش دادههای صوتی فراهم میآورد.
ساخت یک ایجنت صوتی در حالت عادی به سرویسهای مجزایی برای تبدیل گفتار به متن، تشخیص نوبت صحبت، استدلال منطقی، فراخوانی ابزارها و سنتز گفتار نیاز دارد. انتقال دادهها میان این بخشهای جداگانه میتواند تأخیر پردازش را افزایش دهد، زمینه مکالمه (کانتکست) را از بین ببرد یا مدیریت وقفهها و پریدن در صحبت را با اختلال مواجه کند. نسخه سوم Voxtral تمامی این بخشها را در قالب یک API و SDK مشترک گردآوری کرده است، در حالی که امکان پیکربندی مستقل مدلهای رونویسی، مدل زبانی و سنتز صدا را همچنان حفظ میکند.
چهار مدل برای پوشش کامل چرخه تعامل صوتی
مدل | کاربرد اصلی | قابلیتهای اعلامشده | قیمت |
|---|---|---|---|
Voxtral Small Transcribe 3 | تبدیل دستهای گفتار به متن با دقت بالا | پشتیبانی از ۵۰ زبان، بایاس مبتنی بر کانتکست و تفکیک گویندگان (Diarization) | ۰٫۰۰۴ دلار به ازای هر دقیقه صوت |
Voxtral Mini Transcribe 3 | تبدیل دستهای و پرسرعت گفتار به متن | مدل ۴ میلیارد پارامتری با پشتیبانی از چندین زبان | ۰٫۰۰۳۵ دلار به ازای هر دقیقه صوت |
Voxtral Mini Transcribe Realtime 3 | تبدیل جریانی گفتار به متن ویژه ایجنتها | پشتیبانی از بیش از ۳۵ زبان با تأخیر اعلامشده کمتر از ۵۰۰ میلیثانیه | ۰٫۰۰۸ دلار به ازای هر دقیقه صوت |
Voxtral Speech 3 | سنتز گفتار بهصورت دستهای و جریانی | پشتیبانی از بیش از ۳۵ زبان، کنترل لهجهها و تنظیم شیوه بیان | ۱۳ دلار به ازای هر ۱ میلیون کاراکتر |
تبدیل گفتار بهینهسازیشده برای نامهای خاص و نوبت صحبت
مدل Voxtral Small Transcribe 3 از ۵۰ زبان مختلف، از جمله تمام ۲۴ زبان رسمی اتحادیه اروپا و چندین زبان آسیایی و هندی با منابع داده کمتر پشتیبانی میکند. در بنچمارک ۴۵ زبانه FLEURS، میسترال در حالت تعیین قبلی زبان (Forced-language mode) نرخ خطای کلمات (WER) معادل ۴٫۰ درصد را گزارش کرده است. شاخص نرخ خطای کلمات، نسبت کلمات اشتباه، جاافتاده یا اضافه را میسنجد؛ بنابراین هرچه این رقم پایینتر باشد، دقت رونویسی بیشتر است.
مقایسههای منتشرشده توسط میسترال، مدل Voxtral Small را بالاتر از مدلهای رقیبی همچون Microsoft AI Transcribe 2، Gemini 3.5 Transcribe، Scribe v2، GPT Transcribe و Whisper large-v3 قرار میدهد؛ مدلی که در همین آزمون نرخ خطای ۱۴٫۹ درصدی را ثبت کرده بود. این شرکت همچنین نتایج برتری را در رونویسی چندزبانه و تفکیک گویندگان (فرآیند تشخیص اینکه هر بخش از صحبت متعلق به چه کسی است) اعلام کرده است. البته این آمارها از سوی سازنده ارائه شدهاند و در عمل باید با ضبطهای صوتی مربوط به کاربردهای واقعی اعتبارسنجی شوند.
قابلیت بایاس مبتنی بر کانتکست (Context Biasing) به توسعهدهندگان امکان میدهد همزمان با ارسال درخواست، نام محصولات، اصطلاحات فنی، سرواژهها و دیگر متون مرتبط را در اختیار سیستم بگذارند. این کار بدون نیاز به فاینتیون یا بهینهسازی اختصاصی مدل، سیستم تشخیص گفتار را به سمت واژگان تخصصی هر حوزه هدایت میکند. در آزمون بازیابی عبارات کلیدی Earnings 22، میسترال گزارش داده است که دقت Voxtral Small با استفاده از این قابلیت، از ۸۱٫۴ درصد در حالت بدون کانتکست به ۹۴٫۶ درصد ارتقا مییابد.
قابلیت بومی پیشبینی پایان نوبت مکالمه، نشانههای صوتی را با معنای متن ترکیب میکند تا زمان دقیق پایان صحبت کاربر را تخمین بزند. این رویکرد مکثهای بین کلام را بسیار دقیقتر از تایمرهای ثابت سکوت مدیریت میکند؛ روشهای سنتی مبتنی بر تایمر ممکن است صحبت کاربری را که در حال فکر کردن است قطع کنند یا پس از یک پاسخ کوتاه، ایجنت را بیش از حد منتظر نگه دارند.
تولید گفتار با لحن و شیوه بیان قابل تنظیم
مدل گفتاری Voxtral از بیش از ۳۵ زبان و ۵۰ لهجه پشتیبانی میکند. این مدل میتواند احساسات، سرعت بیان و تأکید روی کلمات را از متن گفتوگو استنتاج کند یا مستقیماً از دستورالعملهای متنی توسعهدهنده پیروی نماید:
[emotion=sad][pace=slow] I'm sorry to hear that.
[emotion=excited][emphasis=high] Your flight is confirmed!
قابلیت شبیهسازی Pro Voice تنها با دریافت ۳۰ دقیقه نمونه صوتی مرجع، ویژگیهای صوتی گوینده، بازه احساسی و سبک بیان او را در زبانهای گوناگون بازآفرینی میکند. به گفته میسترال، ارزیابی لهجهها در این مدل شامل تلفظ، لحن رسمی و غیررسمی، املا، میزان خلاصهگویی و قواعد محلی برای بیان تاریخ، ساعت، دما، نشانیها و ارزهای مختلف است.
شبیهسازی صدا به دلیل بازتولید ویژگیهای شناساییپذیر افراد، نیازمند سازوکارهای حفاظتی و امنیتی جدی است. تیمهایی که قصد ارزیابی Pro Voice را دارند، باید پیش از هر اقدامی مواردی نظیر رضایتنامه رسمی صاحب صدا، کنترلهای دسترسی، ثبت لاگهای نظارتی، خطمشیهای شفافسازی هویت مصنوعی صدا و قوانین ذخیرهسازی و حذف نمونههای مرجع را بهدقت پیادهسازی کنند.
چرخه پیوسته پردازش؛ حرکتی بدون وقفه در تعامل صوتی
کیت توسعه ایجنت صوتی که بر بستر LiveKit ساخته شده است، سه مرحله با قابلیت پیکربندی مستقل را به یکدیگر پیوند میدهد:
- شنیدن: مدل Voxtral Mini Transcribe Realtime 3 متن را بهصورت جریانی آماده میکند و پایان نوبت صحبت کاربر را تشخیص میدهد.
- استدلال و عمل: یک مدل زبانی بزرگ مانند Mistral Small درخواست را تحلیل کرده و ابزارهای تنظیمشده را فراخوانی میکند.
- پاسخگویی: مدل Voxtral Speech 3 پاسخ صوتی را متناسب با حالوهوای مکالمه تولید و بهشکل جریانی مخابره مینماید.
خروجیهای میانی به محض آماده شدن در طول چرخه پردازش منتقل میشوند تا زمان اتلافشده بین مراحل به حداقل برسد. میسترال اعلام کرده است که تأخیر نوبت مکالمه به کمتر از یک ثانیه میرسد و این سیستم از قابلیت پریدن در کلام (Barge-in) نیز پشتیبانی میکند؛ قابلیتی که به محض قطع صحبت توسط کاربر، صحبت ایجنت را متوقف میسازد. البته تأخیر واقعی در عملکرد نهایی به وضعیت شبکه، مدل انتخابشده، زمان اجرای ابزارها، منطقه جغرافیایی استقرار و زیرساخت مخابراتی وابسته خواهد بود.
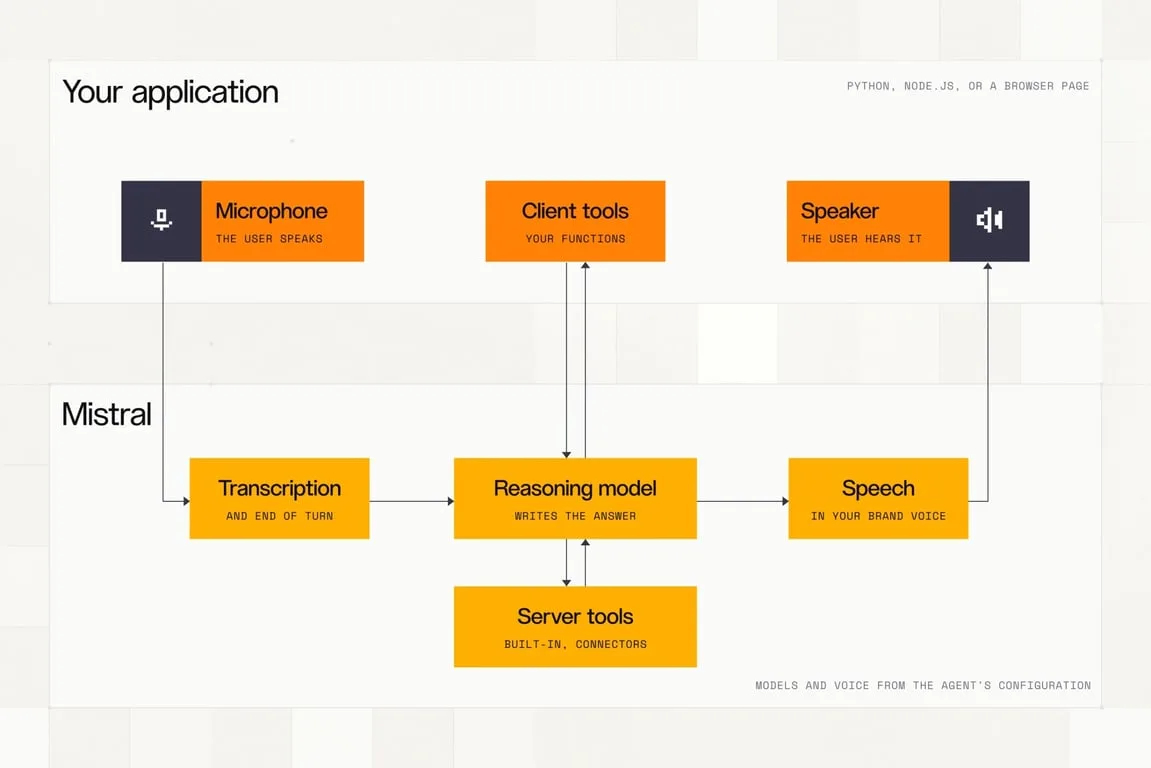
ابزارهای متصل به سیستم میتوانند از طریق فراخوانی توابع (Function Calling)، جستجوی وب و بازیابی اطلاعات از پایگاههای داده داخلی، هویت تماسگیرنده را تأیید کنند، اطلاعات حساب کاربری را واکشی نمایند، صورتحساب را بسنجند یا نوبت ملاقات رزرو کنند. این SDK از پروتکل SIP برای تماسهای تلفنی و WebRTC برای مرورگرها و اپلیکیشنها پشتیبانی میکند و مسیرهای یکپارچهسازی متعددی را برای سیستمهای تلفنی، پاسخ صوتی تعاملی (IVR) و مراکز تماس پیش روی سازمانها قرار میدهد.
تعویض منعطف ماژولها و انتخاب منطقه استقرار
تفکیک مراحل تبدیل گفتار، استدلال و تولید صدا بهعنوان اجزای مستقل به توسعهدهندگان اجازه میدهد بدون نیاز به بازسازی کل ایجنت، مدل زبانی، صدای گوینده یا زبانهای پشتیبانیشده را تغییر دهند. این ساختار ماژولار همچنین ارزیابی و مقیاسپذیری مجزای هر مرحله را امکانپذیر میسازد که به تیمهای فنی در ردیابی خطاهای رونویسی، ابزارهای کند و پاسخهای نامناسب کمک شایانی خواهد کرد.
میسترال در کنار امکان استقرار شخصی و محلی، اندپوینتهای API را در مناطق اروپا، آمریکا و سرتاسر جهان در دسترس قرار داده است. این تنوع گزینهها، کنترل بیشتری روی محل پردازش فایلهای صوتی و نحوه اتصال سرویس به دادههای محرمانه سازمانی ایجاد میکند. با این حال، رعایت الزامات اقامت دادهها، نگهداری، امنیت و انطباق با قوانین و مقررات همچنان به معماری انتخابی، قراردادها، سیاستهای ثبت وقایع و زیرساختهای مکمل بستگی خواهد داشت.
سناریوهای ایدهآل برای کاربرد این معماری
- مراکز تماس و میزهای خدمات: مراکزی که به رونویسی چندزبانه، تفکیک دقیق گویندگان و اولویتدهی به اصطلاحات خاص نظیر نام کالاها، کدهای انبارداری یا واژگان پزشکی نیاز دارند.
- دستیارهای تلفنی هوشمند: سیستمهایی که به اتصال SIP یا WebRTC، مدیریت قطع صحبت کاربر و پاسخگویی با کمترین تأخیر وابستهاند.
- محصولات صوتی با هویت برند مشخص: سرویسهایی که خواهان لحن و شخصیت صوتی یکدست در چندین زبان و لهجه مختلف هستند.
- کاربردهای حساس به محل ذخیرهسازی داده: سازمانهایی که پردازش در سرورهای مستقر در اروپا یا استقرار بر بستر زیرساخت کاملاً محلی و کنترلشده را طلب میکنند.
نکات حیاتی برای ارزیابی پیش از راهاندازی نهایی
- از دست رفتن دادههای صوتی: تبدیل صوت به متن ممکن است جزئیاتی نظیر خنده، آه کشیدن، تردید در کلام و دیگر نشانهها را از بین ببرد، مگر آنکه لایه رونویسی آنها را بهطور صریح ثبت کند.
- کیفیت کلی سیستم مرکب: دقت تفکر ایجنت و بهرهگیری درست از ابزارها به مدل زبانی، پرامپتها، سیستم بازیابی اطلاعات و تعاریف توابع انتخابی وابسته است.
- تأخیر واقعی سرتاسری (End-to-End): ارقام اعلامشده برای مدل، تأخیرهای مربوط به پرشهای شبکه، فراخوانی ابزارها، پرسوجوهای پایگاه داده یا سیستمهای مخابراتی را شامل نمیشود.
- تفاوت نتایج بنچمارک با دنیای واقعی: امتیازات بنچمارک FLEURS ممکن است عملکرد سیستم را در تماسهای دارای نویز، تغییر متناوب زبان (Code-switching)، لغات تخصصی یا لهجههای ناآشنا به درستی پیشبینی نکند.
- هزینههای استقرار شخصی: میزبانی روی زیرساخت محلی مستلزم تأمین سختافزار، راهکارهای مقیاسپذیری، پایش مداوم، بهروزرسانیها و مدیریت حوادث فنی است.
یک ارزیابی دقیق در محیط عملیاتی باید نرخ خطای کلمات در تماسهای واقعی، قدرت بازیابی عبارات کلیدی، دقت تفکیک گویندگان، تشخیص پایان کلام، بازگشت موفق از وقفه، تکمیل درست فراخوانی توابع، تأخیرهای لحظهای و کیفیت صدای تولیدشده را برای هر منطقه و زبان هدف بسنجد. اطلاعات تکمیلی پیرامون API و جزئیات فنی استقرار در مستندات رسمی Voxtral در دسترس است.
مطالب مرتبط و پیشنهادی
سرمایهگذاری میلیاردی انویدیا در اروپا؛ جنسن هوانگ برای تکتک کشورها هوش مصنوعی اختصاصی میخواهد
مدیرعامل انویدیا با دستهچکی چند میلیارد دلاری راهی اروپا شده است تا کشورها را به ساخت زیرساختهای بومی هوش مصنوعی ترغیب کند. جنسن هوانگ با این اقدام قصد دارد در بحبوحه نگرانیها از حباب هوش مصنوعی، تقاضای جهانی برای تراشههای شرکتش را تضمین کند.
چرا آنتروپیک چارهای جز عرضه اولیه سهام در بورس ندارد؟ عطش بیپایان برای جذب سرمایه
آنتروپیک با تعهدات مالی سنگین چندصد میلیارد دلاری برای توسعه زیرساختها، دیگر در بازارهای خصوصی سرمایه نمیگنجد. سرمایهگذاران تأکید میکنند این غول هوش مصنوعی چارهای جز ورود به والاستریت ندارد تا نقدینگی عظیم بازارهای عمومی را برای ادامه رقابت نفسگیر هوش مصنوعی جذب کند.
دوراهی سخت اروپا؛ آیا توسعه مراکز داده هوش مصنوعی اهداف اقلیمی را قربانی میکند؟
آلمان و دیگر کشورهای اروپایی در تلاشاند برای کاهش وابستگی به آمریکا، زیرساختها و مراکز داده هوش مصنوعی خود را بهسرعت گسترش دهند؛ اما سیاستهای سختگیرانه اقلیمی برای مهار گازهای گلخانهای به مانعی بزرگ تبدیل شده و دولتها را بر سر دوراهی توسعه فناوری یا نجات محیط زیست قرار داده است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.